Perplexity가 공개한 pplx-decider는 무엇이 다를까, 글 대신 확률로 답하고 바탕 모델 Qwen3.8 27B보다 11%포인트 높았다
Perplexity가 판단 모델 pplx-decider-v1-27b를 Apache 2.0으로 공개했습니다. 글 대신 확률로 답하고, 11가지 시험에서 바탕 모델 Qwen3.8 27B보다 약 11%포인트 높았습니다. 요금 계산과 RTX 5090·16GB 그래픽카드에서 돌릴 수 있는지도 정리했습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"파이썬" 검색 결과 22건
Perplexity가 판단 모델 pplx-decider-v1-27b를 Apache 2.0으로 공개했습니다. 글 대신 확률로 답하고, 11가지 시험에서 바탕 모델 Qwen3.8 27B보다 약 11%포인트 높았습니다. 요금 계산과 RTX 5090·16GB 그래픽카드에서 돌릴 수 있는지도 정리했습니다.
Comfy가 ComfyUI 워크플로를 커스텀 노드, 모델, LoRA까지 통째로 묶어 클라우드 GPU에 올리는 Comfy API를 열었습니다. 유료 요금제(월 20달러부터)가 필요하고 GPU는 초 단위로 냅니다(RTX PRO 6000 96GB가 1시간 4.54달러). Build·Release·Deployment가 무엇인지, 원래 있던 내 PC의 ComfyUI API와 무엇이 다른지, 실제로 얼마가 나오는지 계산과 함께 정리했습니다.
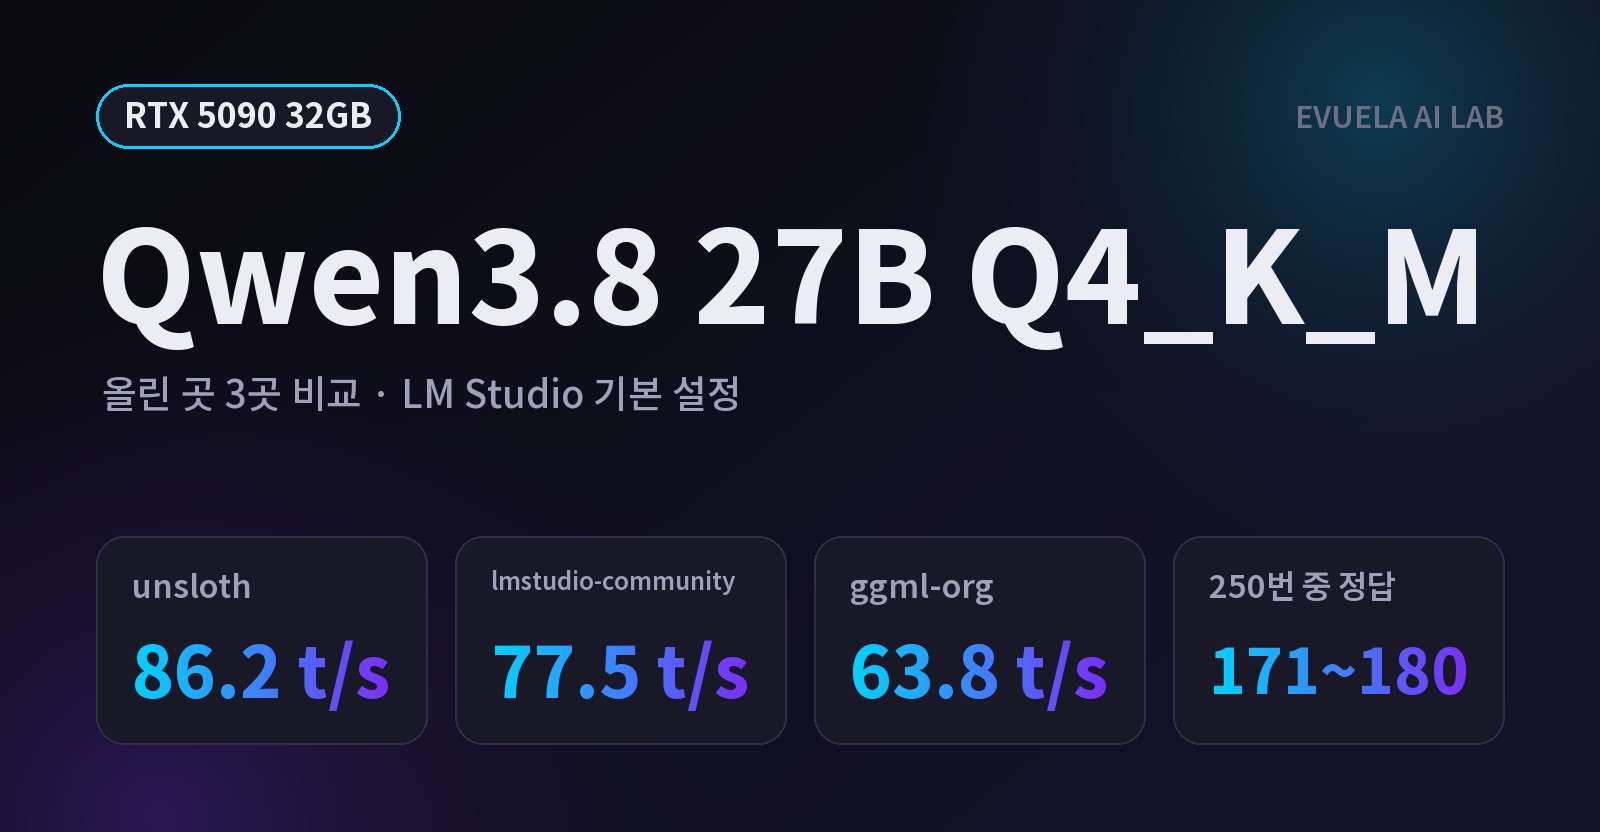
Qwen3.8 27B Q4_K_M 파일을 lmstudio-community, unsloth, ggml-org 세 곳에서 받아 RTX 5090과 LM Studio로 비교했습니다. 채점 질문 250번 중 171~180번을 맞혀 정답률은 거의 같았고, 생성 속도는 초당 63.8~86.2토큰으로 달랐습니다. 차이는 파일 안에 MTP 레이어가 있느냐에서 나왔습니다. 파일 속 양자화 구성, VRAM, MCP 도구 호출 결과와 LM Studio 캡처를 함께 정리했습니다.
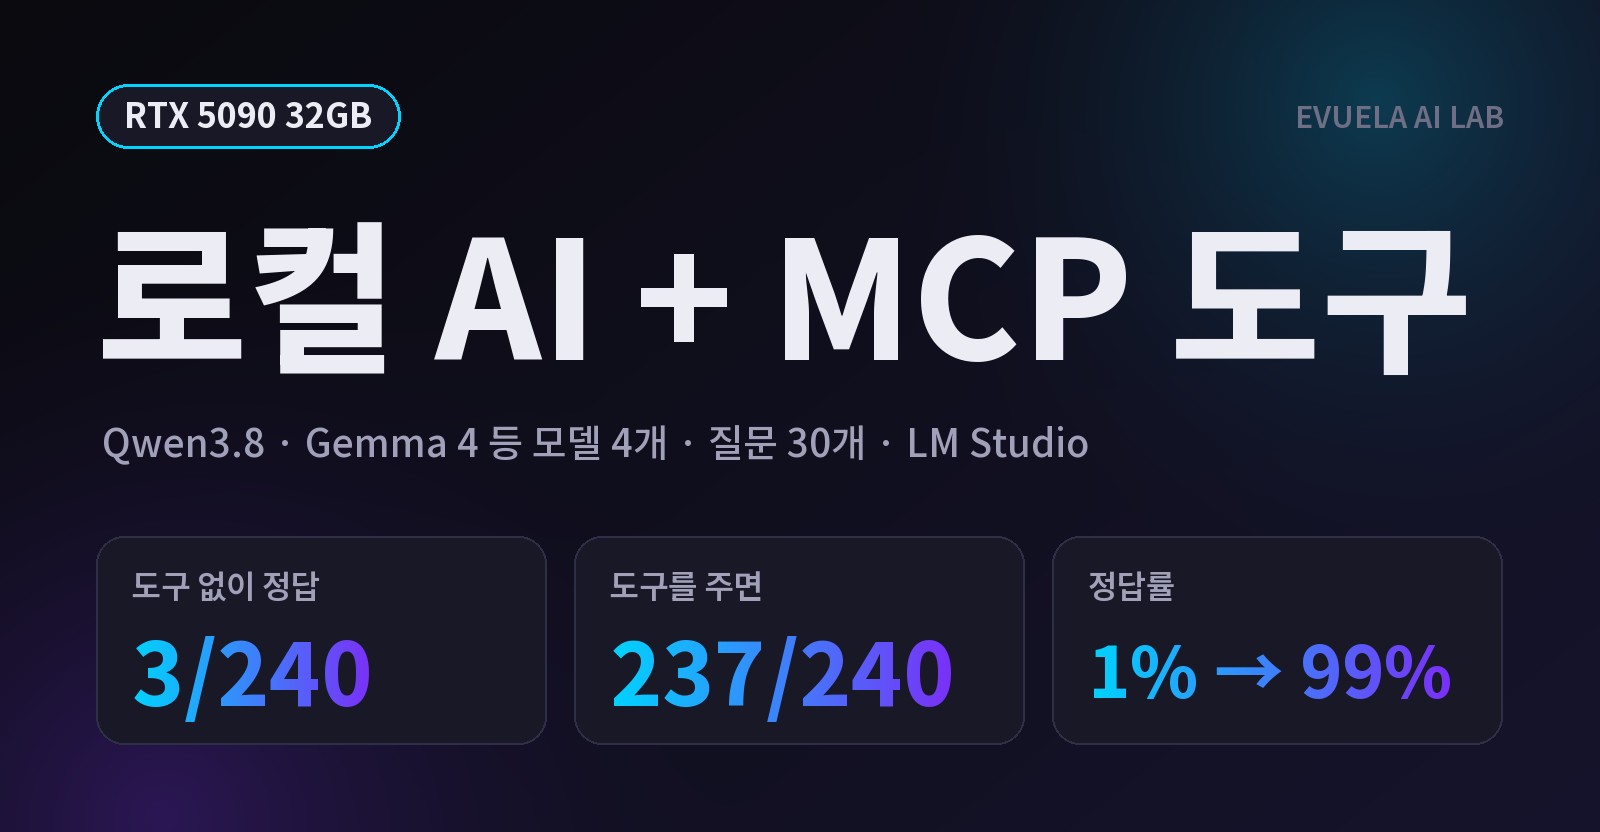
로컬 AI 모델 4개(Qwen3.8 27B, Gemma 4 26B A4B, Gemma 4 31B, Muse Glimmer)에 MCP 도구 3개(웹 페이지 읽기, 현재 시간, 파일 읽기)를 붙이고 같은 질문 30개를 물었습니다. 최신 정보와 파일 질문에서 240번 중 3번이던 정답이 237번이 됐고, 도구가 없을 때는 문서를 읽은 척 틀린 답을 하기도 했습니다. LM Studio 설정 방법과 캡처, 모델별 결과를 정리했습니다.