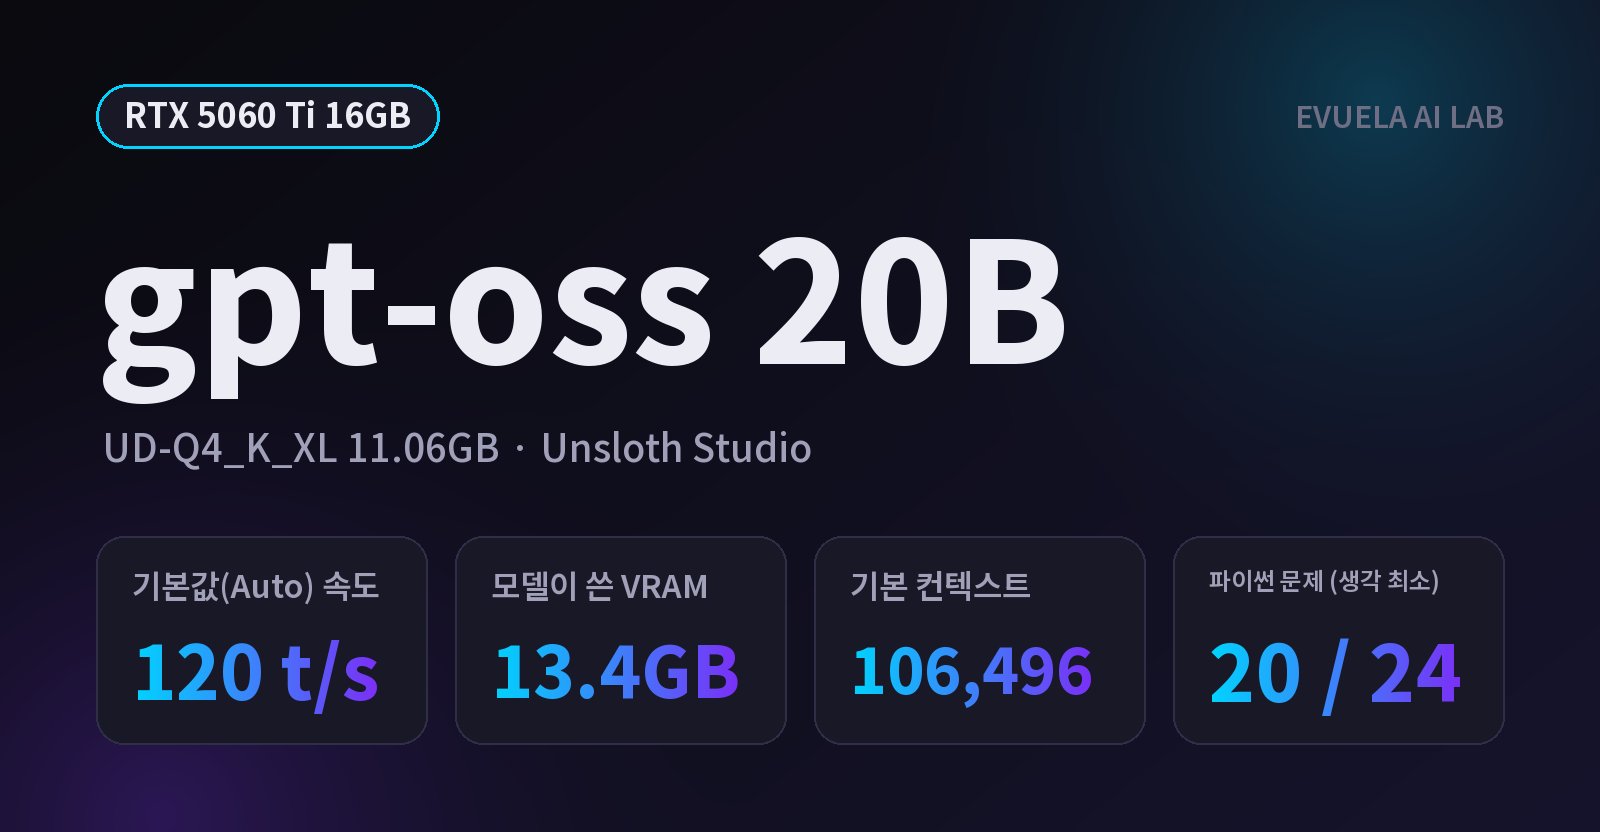
[RTX 5060 Ti 16GB] OpenAI의 gpt-oss 20B를 16GB에서 돌리면, 컨텍스트 10만에서도 초당 120토큰이 나왔다
RTX 5060 Ti 16GB의 Unsloth Studio에서 OpenAI의 gpt-oss 20B(UD-Q4_K_XL 11.06GB)를 기본값으로 돌렸습니다. 초당 약 120토큰, 컨텍스트 65,536까지 같은 속도였고, 생각 단계에 따라 시간과 코딩 결과가 크게 달랐습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"매개변수" 검색 결과 5건
RTX 5060 Ti 16GB의 Unsloth Studio에서 OpenAI의 gpt-oss 20B(UD-Q4_K_XL 11.06GB)를 기본값으로 돌렸습니다. 초당 약 120토큰, 컨텍스트 65,536까지 같은 속도였고, 생각 단계에 따라 시간과 코딩 결과가 크게 달랐습니다.
같은 Qwen3.8 27B 파일로 LM Studio와 Unsloth Studio를 비교했습니다. 기본값 속도는 65.4 대 65.6 t/s로 같았고, MTP를 켜면 35~44% 빨랐습니다. 생각 한도, 컨텍스트, 조심할 점과 앞으로의 측정 방법을 정리했습니다.
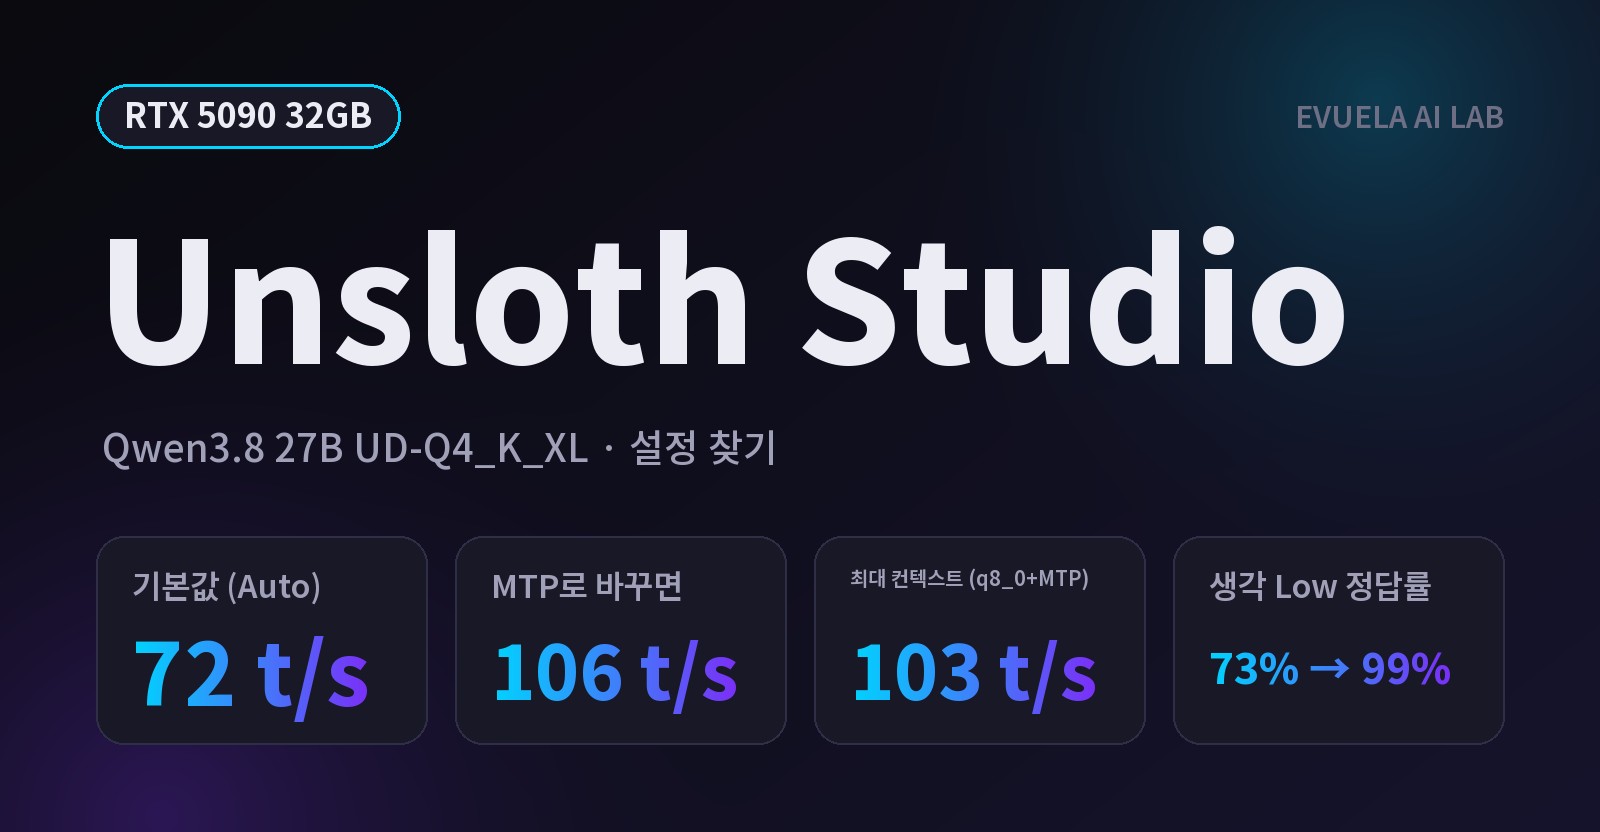
Unsloth Studio를 RTX 5090에 설치하고 Qwen3.8 27B(UD-Q4_K_XL)로 설정을 하나씩 바꿔 가며 쟀습니다. 기본값은 컨텍스트를 16만 8천 토큰으로 알아서 잡았고 초당 72토큰이었습니다. 속도 기능을 MTP로 바꾸면 48% 빨라졌고, KV 캐시를 q8_0으로 줄이면 최대 컨텍스트 262,144에서도 초당 103토큰이 나왔습니다. 생각 단계별 정답률, 화면 캡처, 쓰임새별 추천 설정을 정리했습니다.
AI 도구
"내 PC에서 AI를 더 빠르게, 더 똑똑하게 돌리는 비법!" 로컬 AI 사용 중 마주하게 되는 '느린 답변 속도'와 '메모리 부족' 문제를 해결하기 위한 두 가지 핵심 기술, GPU 오프로딩과 양자화를 완벽 분석합니다. 8GB VRAM 환경에서의 최적 모델 선택 가이드와 실전 속도 테스트 결과까지, 내 컴퓨터 자원을 200% 활용하는 최적의 세팅법을 확인해 보세요.
AI 도구
"Gemma-3 1B? Qwen 35B? 숫자가 높을수록 무조건 좋을까?" 로컬 AI 입문 시 가장 궁금해하는 매개변수(B)의 정체를 레고 조립에 비유해 정리했다. 내 PC의 VRAM 사양과 용도에 맞는 똑똑한 모델 선택법을 공유한다.