[RTX 5090 32GB] LM Studio vs Unsloth Studio, Qwen3.8 27B는 lmstudio-community와 unsloth 중 어느 파일을 올려야 빠를까, 가장 빠른 조합은 초당 109토큰 RTX 5090 32GB

[RTX 5090 32GB] LM Studio vs Unsloth Studio, Qwen3.8 27B는 lmstudio-community와 unsloth 중 어느 파일을 올려야 빠를까, 가장 빠른 조합은 초당 109토큰

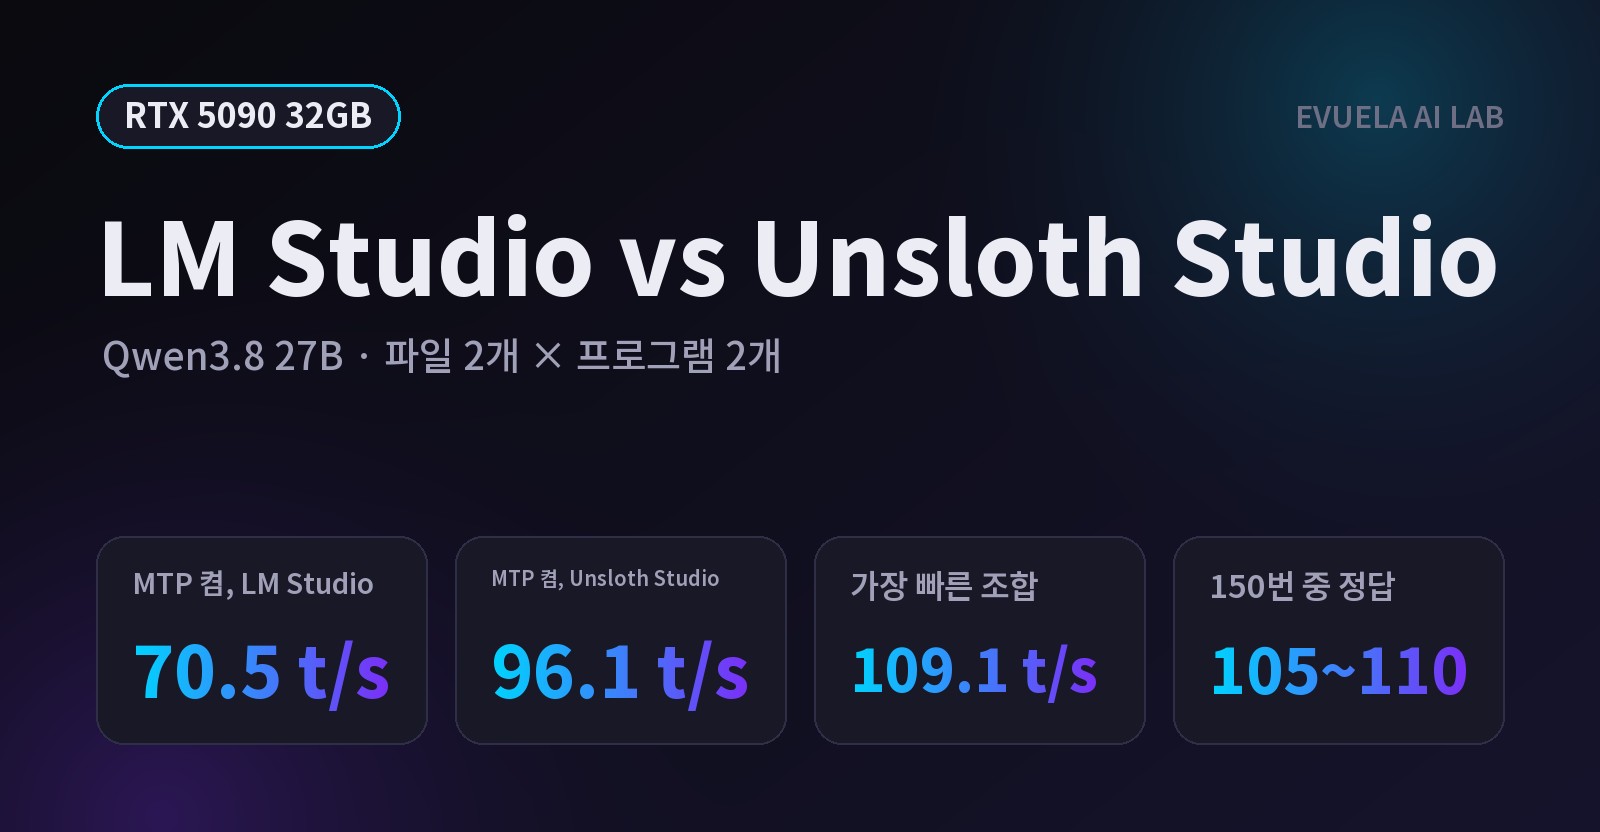
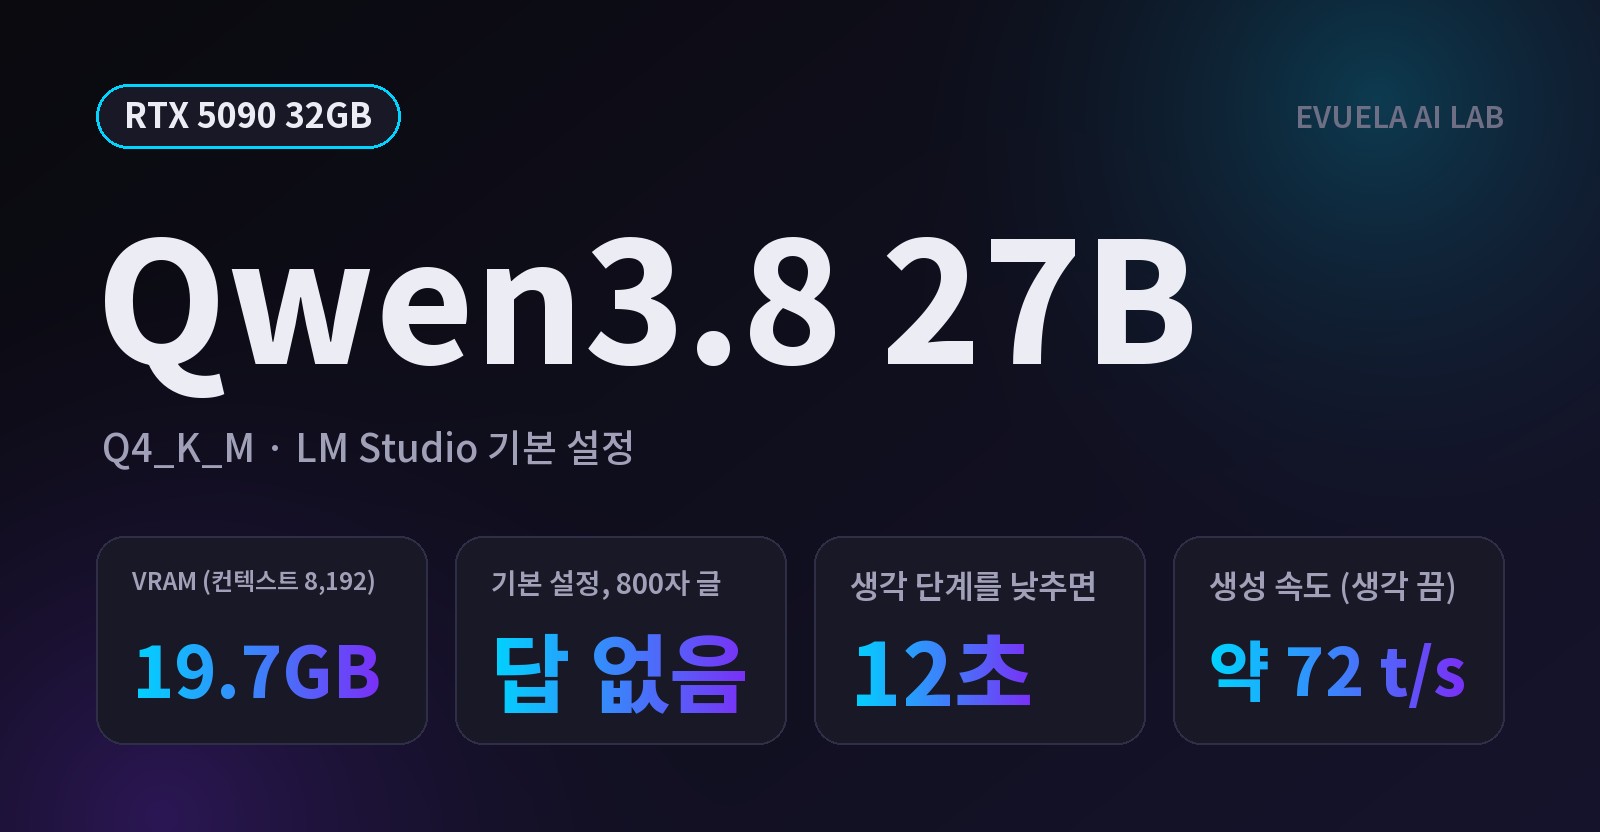
RTX 5090에서 Qwen3.8 27B 파일 두 개(lmstudio-community Q4_K_M, unsloth UD-Q4_K_XL)를 LM Studio와 Unsloth Studio에 차례로 올리고 설정을 똑같이 맞춰 쟀습니다. MTP를 끄면 두 프로그램의 속도가 거의 같았고, MTP를 켜면 Unsloth Studio가 35~36% 빨랐습니다. lmstudio-community 파일은 두 프로그램 모두에서 8~15% 더 빨랐고, 정답률은 네 조합이 같았습니다. 생각 설정의 차이와 두 프로그램 화면 캡처도 함께 정리했습니다.

2026.10.02 59
[RTX 5090 32GB] Unsloth Studio로 Qwen3.8 27B를 돌리면 어떤 설정이 좋을까, 최대 컨텍스트에서도 초당 103토큰이 나왔다 RTX 5090 32GB

[RTX 5090 32GB] Unsloth Studio로 Qwen3.8 27B를 돌리면 어떤 설정이 좋을까, 최대 컨텍스트에서도 초당 103토큰이 나왔다

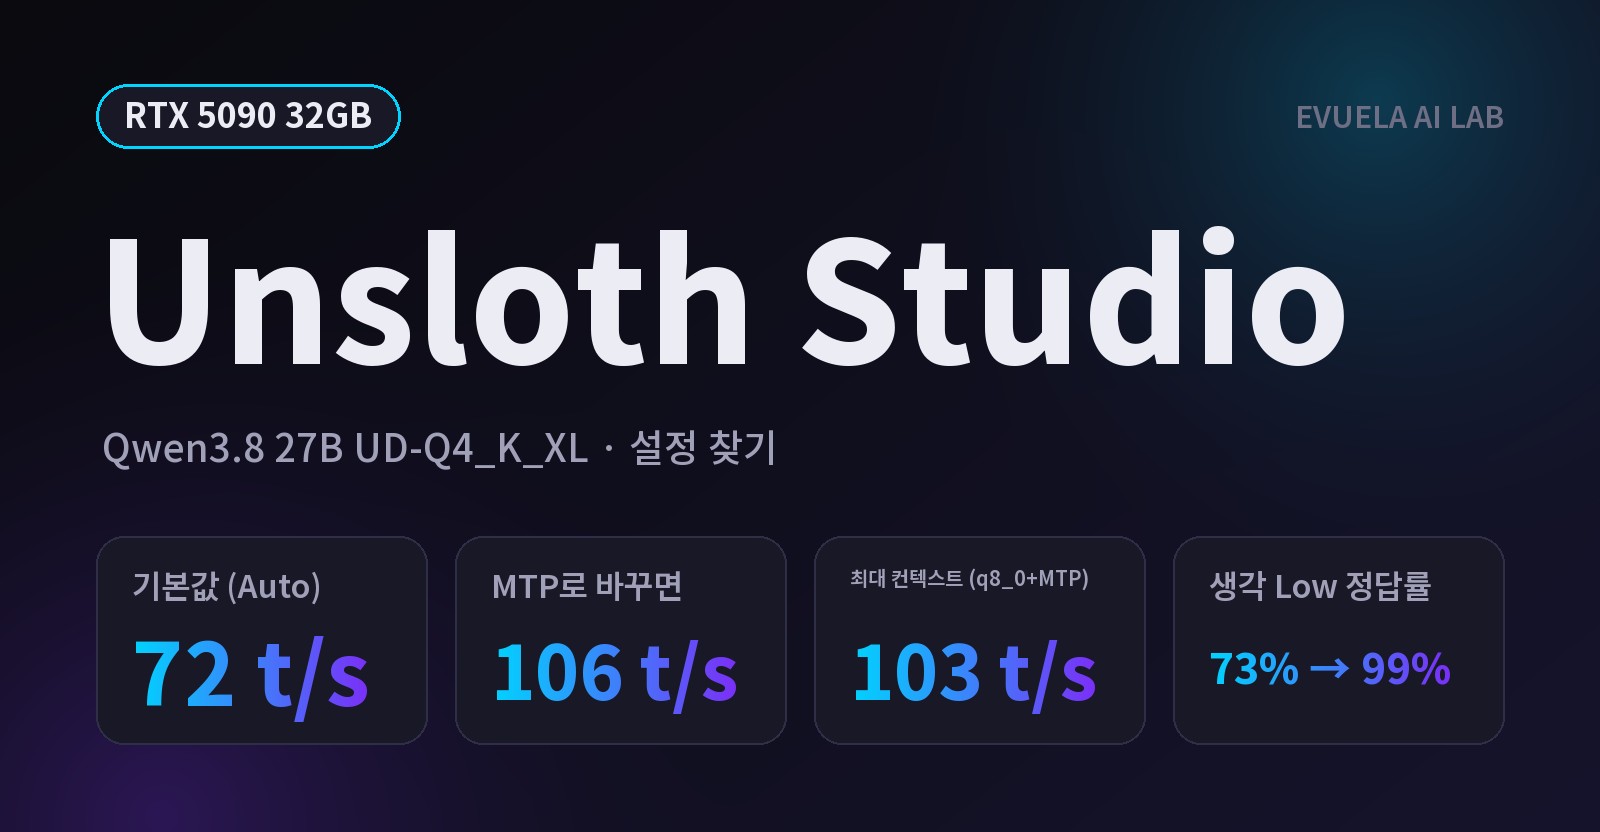
Unsloth Studio를 RTX 5090에 설치하고 Qwen3.8 27B(UD-Q4_K_XL)로 설정을 하나씩 바꿔 가며 쟀습니다. 기본값은 컨텍스트를 16만 8천 토큰으로 알아서 잡았고 초당 72토큰이었습니다. 속도 기능을 MTP로 바꾸면 48% 빨라졌고, KV 캐시를 q8_0으로 줄이면 최대 컨텍스트 262,144에서도 초당 103토큰이 나왔습니다. 생각 단계별 정답률, 화면 캡처, 쓰임새별 추천 설정을 정리했습니다.

2026.10.02 55
[RTX 5090 32GB] 같은 Q4_K_M인데 뭐가 다를까, unsloth·lmstudio-community·ggml-org의 Qwen3.8 27B는 정답률이 같고 속도만 달랐다 RTX 5090 32GB

[RTX 5090 32GB] 같은 Q4_K_M인데 뭐가 다를까, unsloth·lmstudio-community·ggml-org의 Qwen3.8 27B는 정답률이 같고 속도만 달랐다

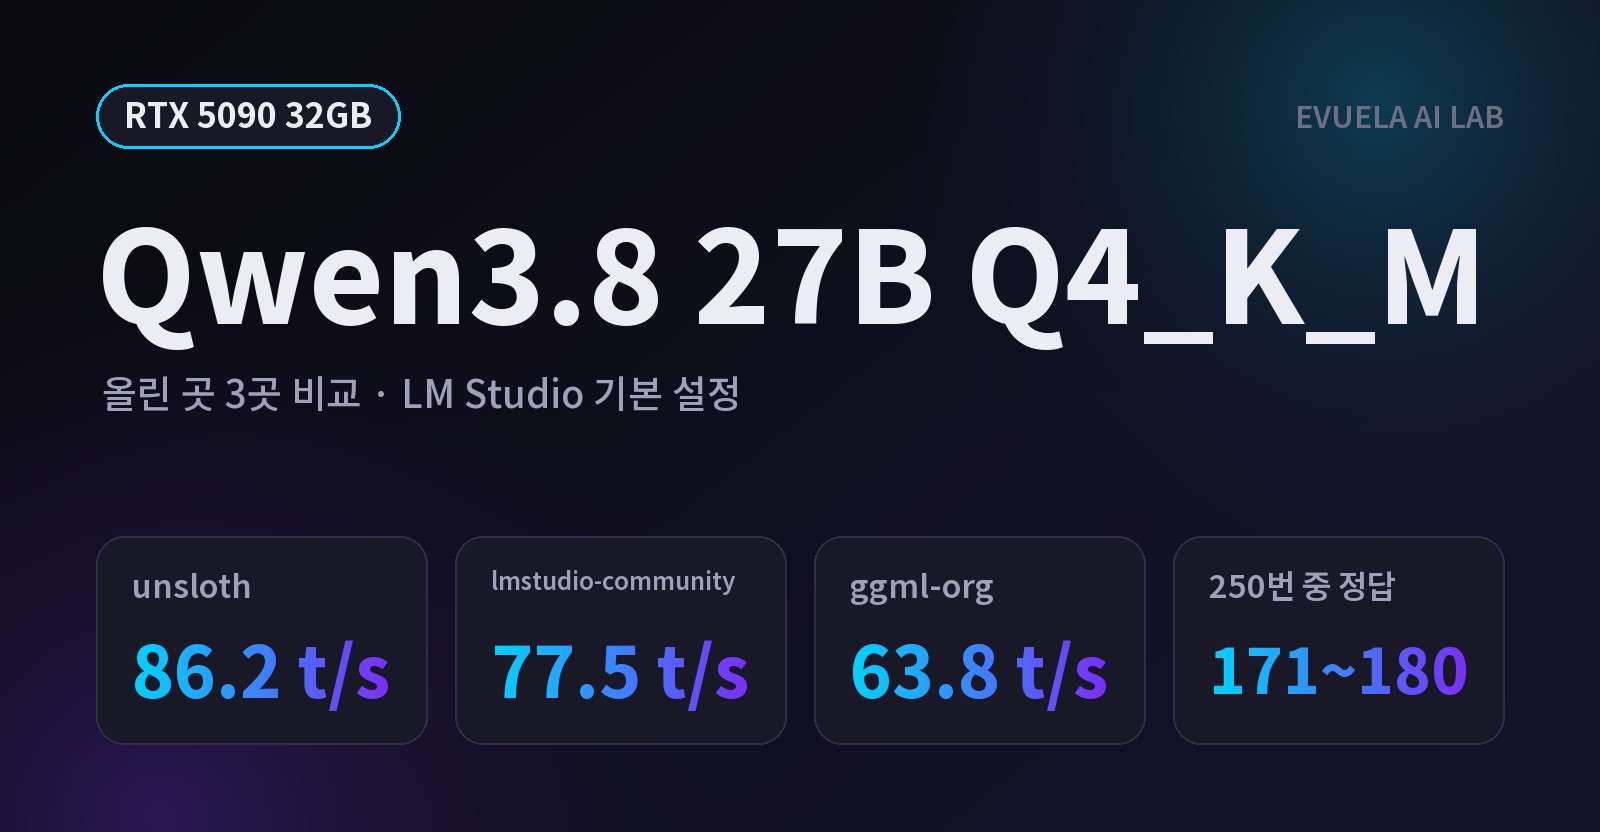
Qwen3.8 27B Q4_K_M 파일을 lmstudio-community, unsloth, ggml-org 세 곳에서 받아 RTX 5090과 LM Studio로 비교했습니다. 채점 질문 250번 중 171~180번을 맞혀 정답률은 거의 같았고, 생성 속도는 초당 63.8~86.2토큰으로 달랐습니다. 차이는 파일 안에 MTP 레이어가 있느냐에서 나왔습니다. 파일 속 양자화 구성, VRAM, MCP 도구 호출 결과와 LM Studio 캡처를 함께 정리했습니다.

2026.10.01 82
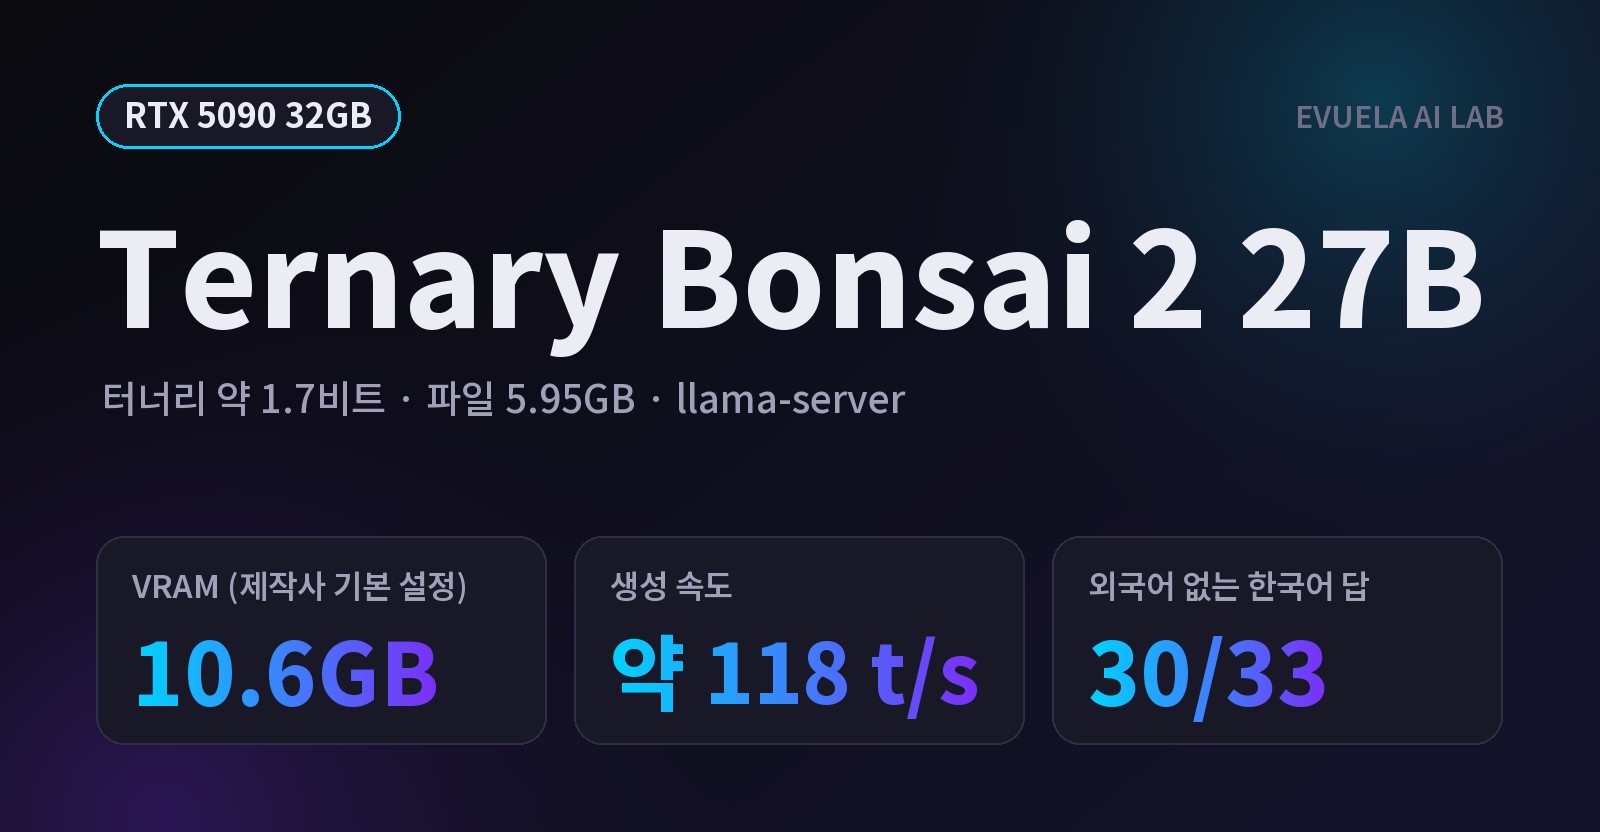
[RTX 5090 32GB] 1세대는 외국어가 섞였는데, Ternary Bonsai 2 27B는 한국어 답 33개 중 30개가 깨끗했다 RTX 5090 32GB

[RTX 5090 32GB] 1세대는 외국어가 섞였는데, Ternary Bonsai 2 27B는 한국어 답 33개 중 30개가 깨끗했다

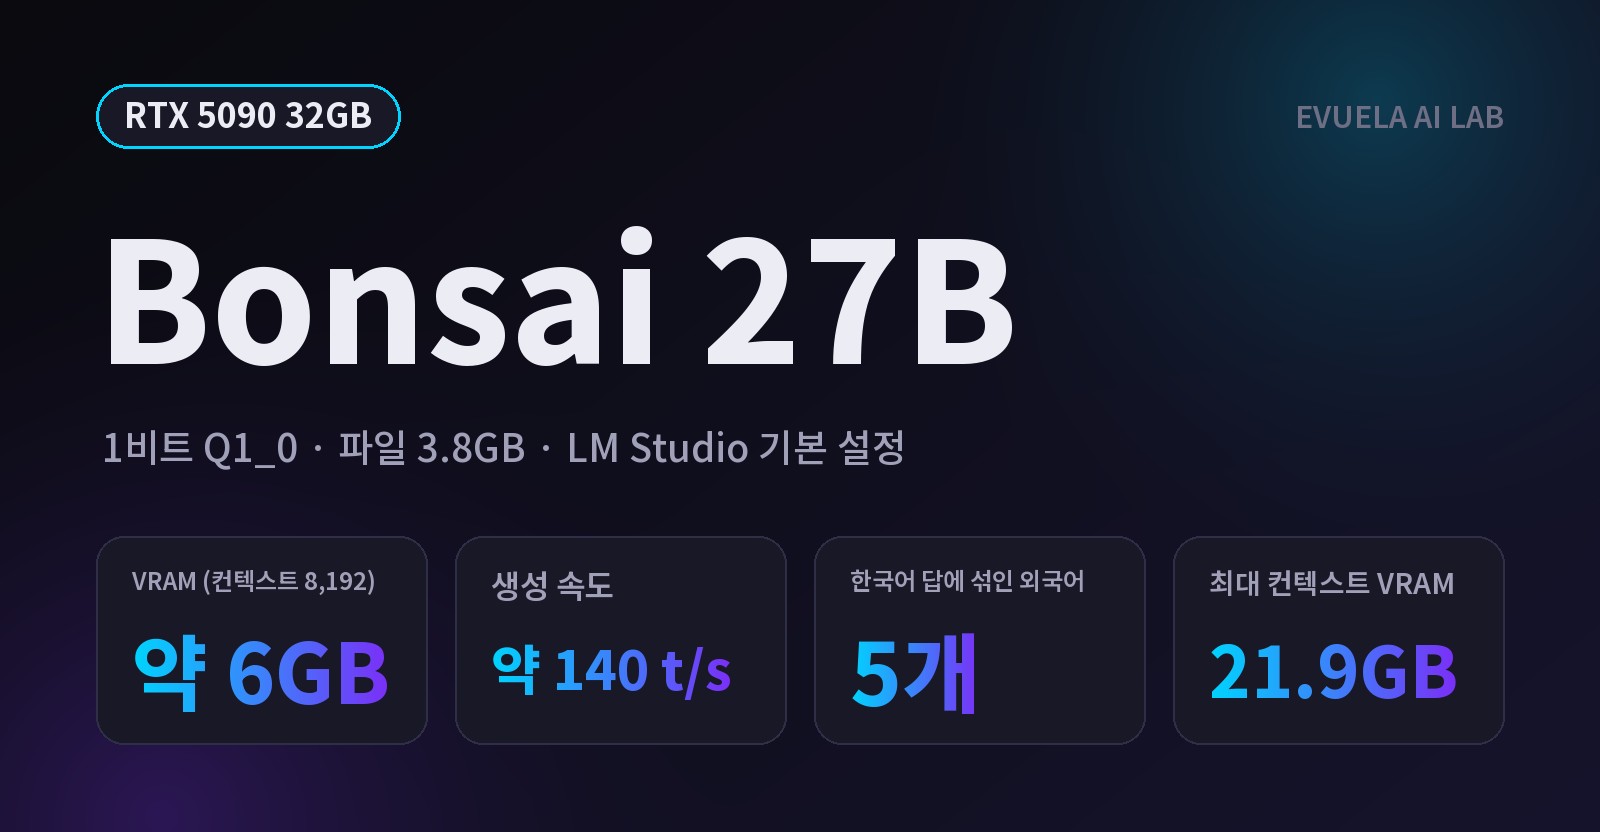
Qwen3.8 27B를 약 1.7비트로 줄인 PrismML Ternary Bonsai 2 27B(5.95GB)를 RTX 5090에서 재 봤습니다. LM Studio로는 아직 열리지 않아 제작사 llama.cpp로 돌렸고, 한국어 답 33개 중 30개에 외국어가 섞이지 않았습니다. VRAM 10.6GB, 약 118 t/s(초당 토큰 수), 생각 단계별 결과를 정리했습니다.

2026.09.29 171