Cursor 요금제가 Grok·X와 하나로 합쳐졌다, 90달러가 30달러가 됐는데 Claude와 GPT는 따로 낸다
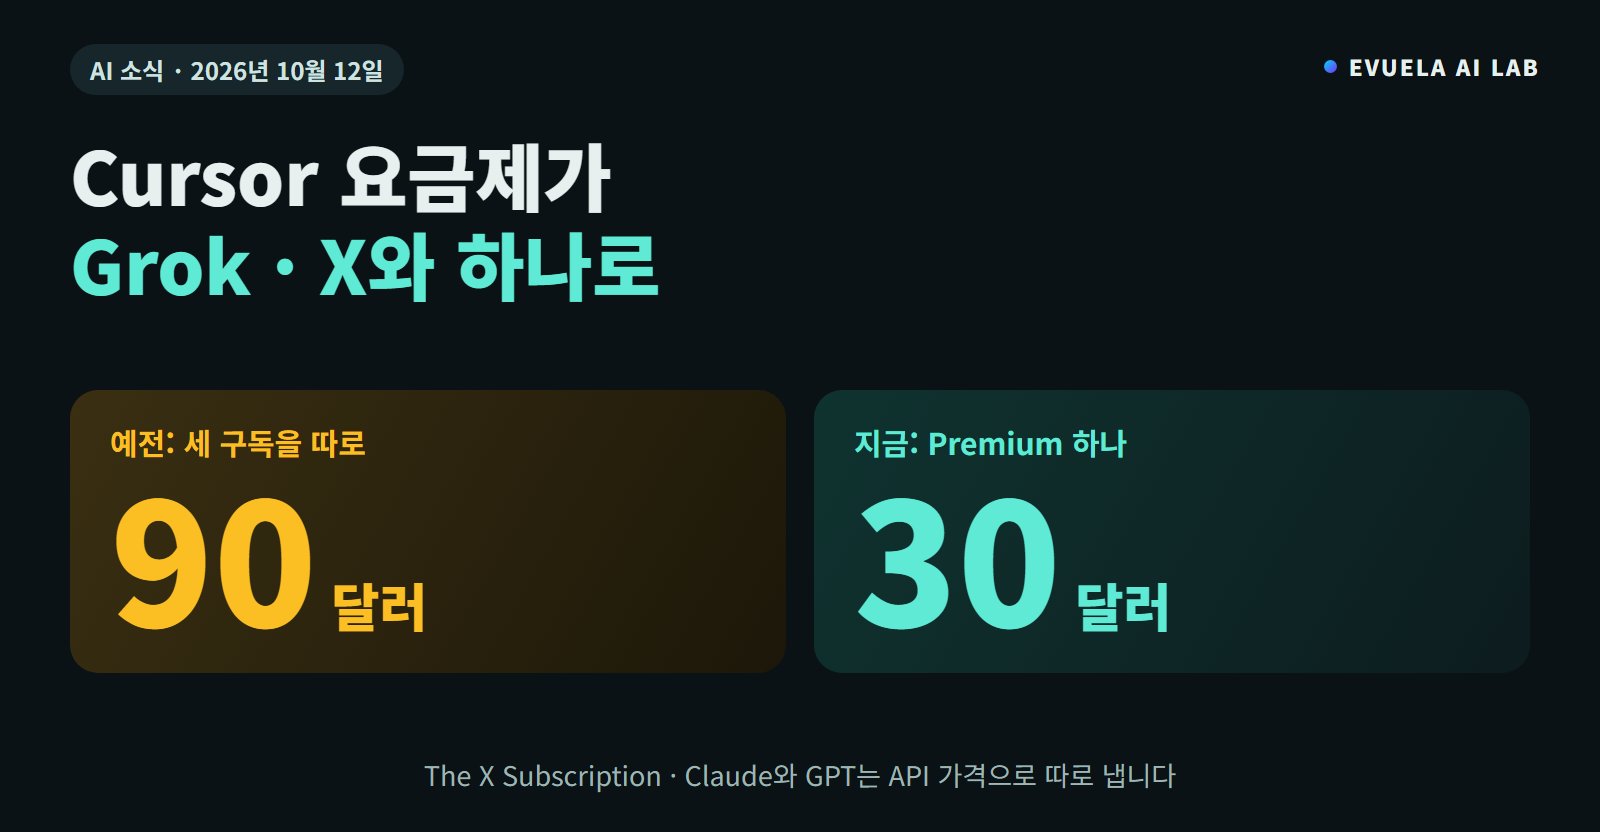
Cursor, Grok, X Premium 요금제가 The X Subscription으로 합쳐졌습니다. 셋을 따로 내면 90달러였던 것이 Premium 30달러가 됐습니다. 다만 Claude와 GPT는 API 가격으로 따로 내야 해서, 기존 구독자가 바꿀지 말지를 계산 예시와 함께 정리했습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"로컬 AI" 검색 결과 43건
Cursor, Grok, X Premium 요금제가 The X Subscription으로 합쳐졌습니다. 셋을 따로 내면 90달러였던 것이 Premium 30달러가 됐습니다. 다만 Claude와 GPT는 API 가격으로 따로 내야 해서, 기존 구독자가 바꿀지 말지를 계산 예시와 함께 정리했습니다.
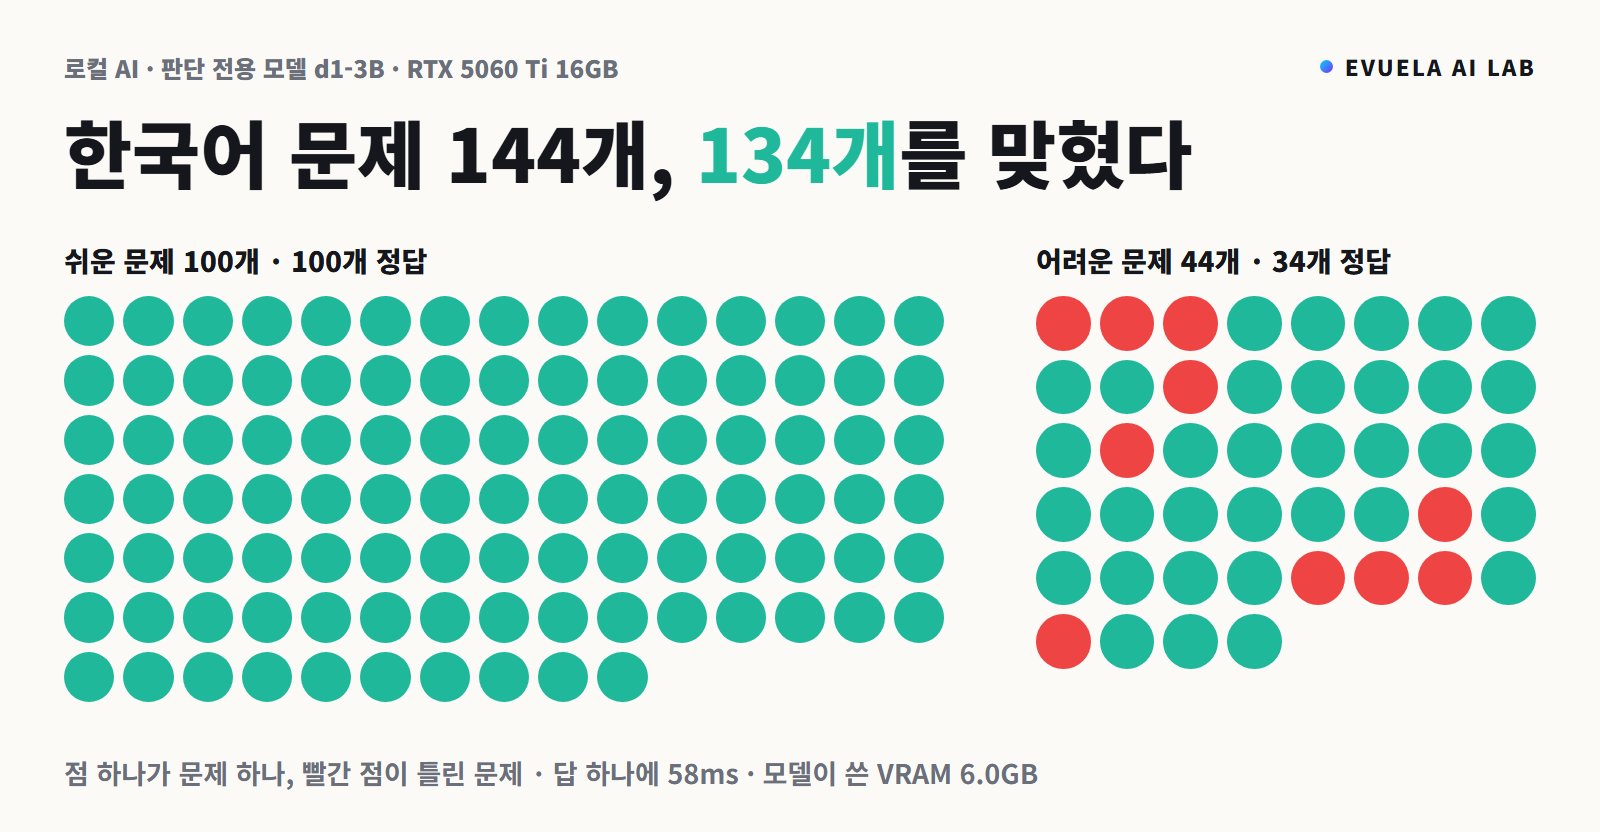
글을 쓰지 않고 보기마다 확률로 답하는 Liquid AI의 판단 전용 모델 d1-3B를 RTX 5060 Ti 16GB에서 한국어 144문제로 쟀습니다. 쉬운 100문제는 모두, 어려운 44문제는 34개를 맞혔고 답 하나에 0.06초, VRAM 6.0GB였습니다.
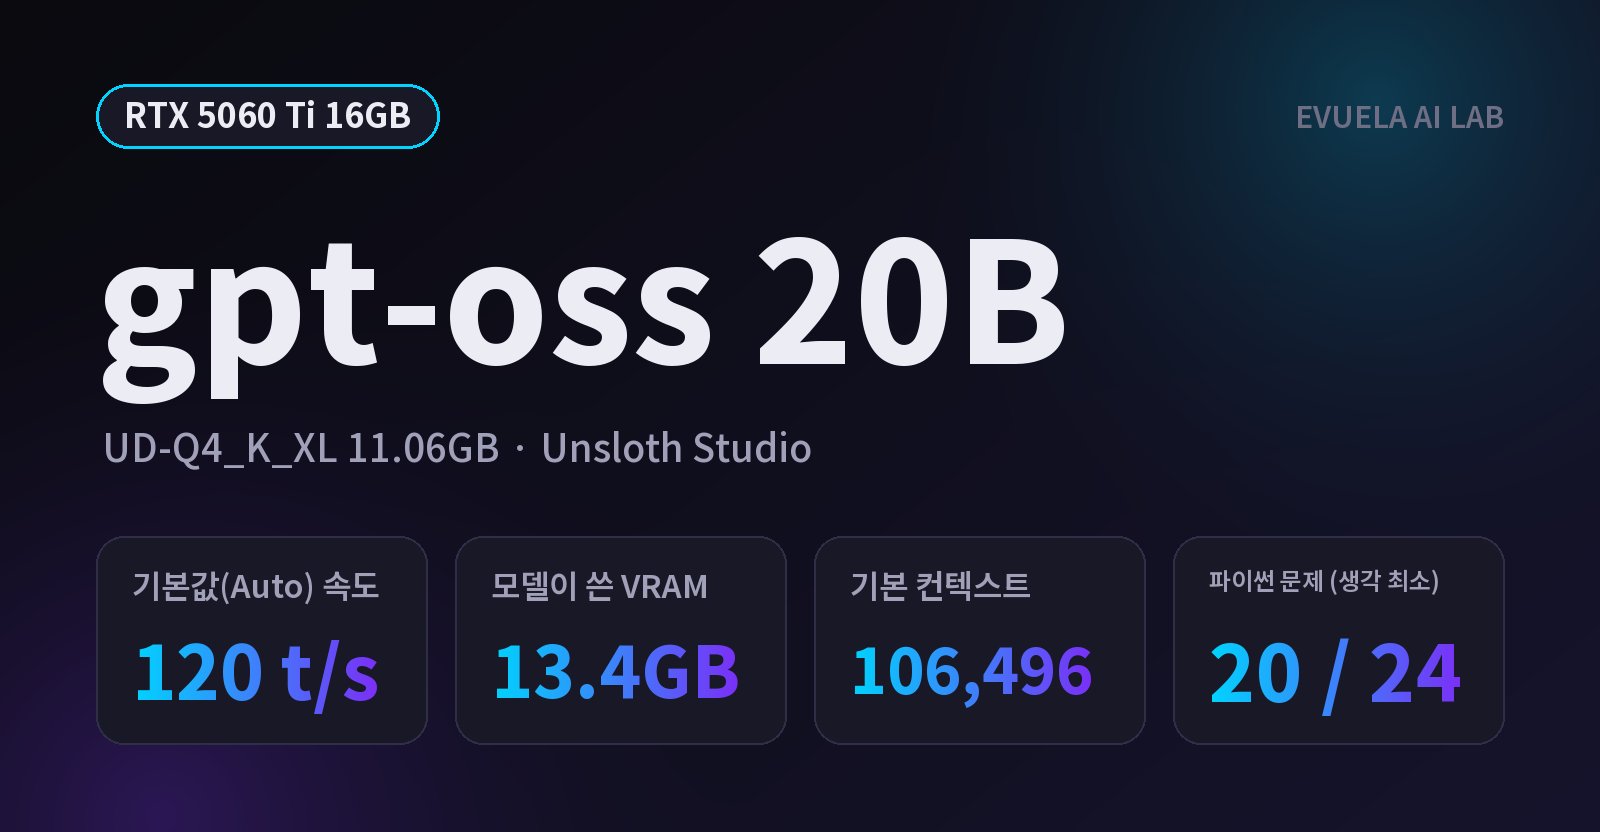
RTX 5060 Ti 16GB의 Unsloth Studio에서 OpenAI의 gpt-oss 20B(UD-Q4_K_XL 11.06GB)를 기본값으로 돌렸습니다. 초당 약 120토큰, 컨텍스트 65,536까지 같은 속도였고, 생각 단계에 따라 시간과 코딩 결과가 크게 달랐습니다.
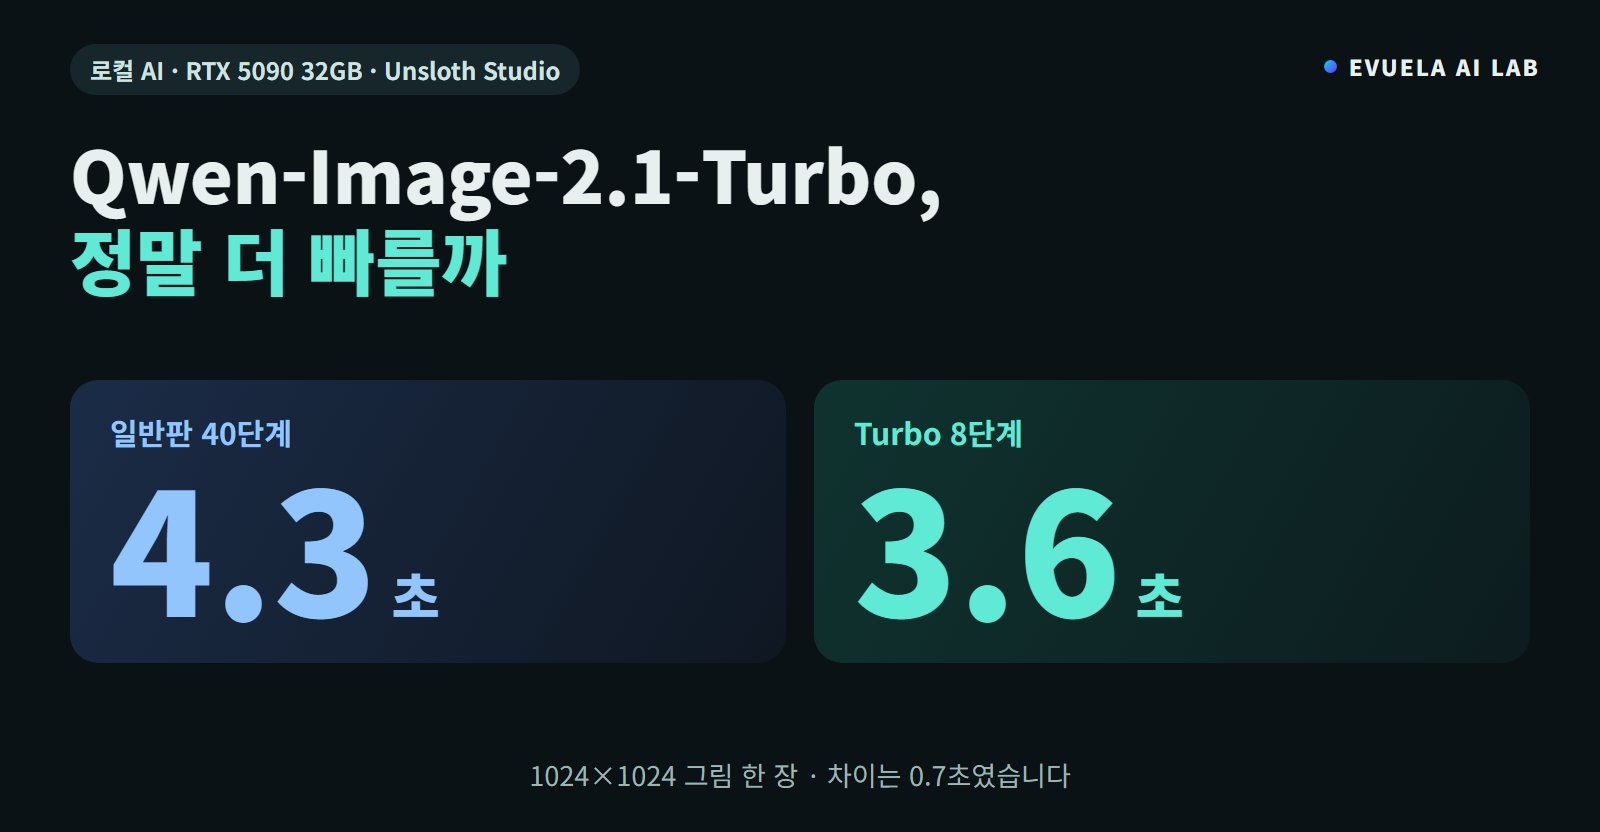
Qwen-Image-2.1-Turbo를 RTX 5090의 Unsloth Studio에서 일반판과 비교했습니다. 1024×1024 한 장에 Turbo 8단계 3.6초, 일반판 40단계 4.3초였고 VRAM은 13.9GB와 21.3GB였습니다. 기본 설정으로 올리면 일반판 가중치로 그려지는 문제와 해결 방법도 적었습니다.
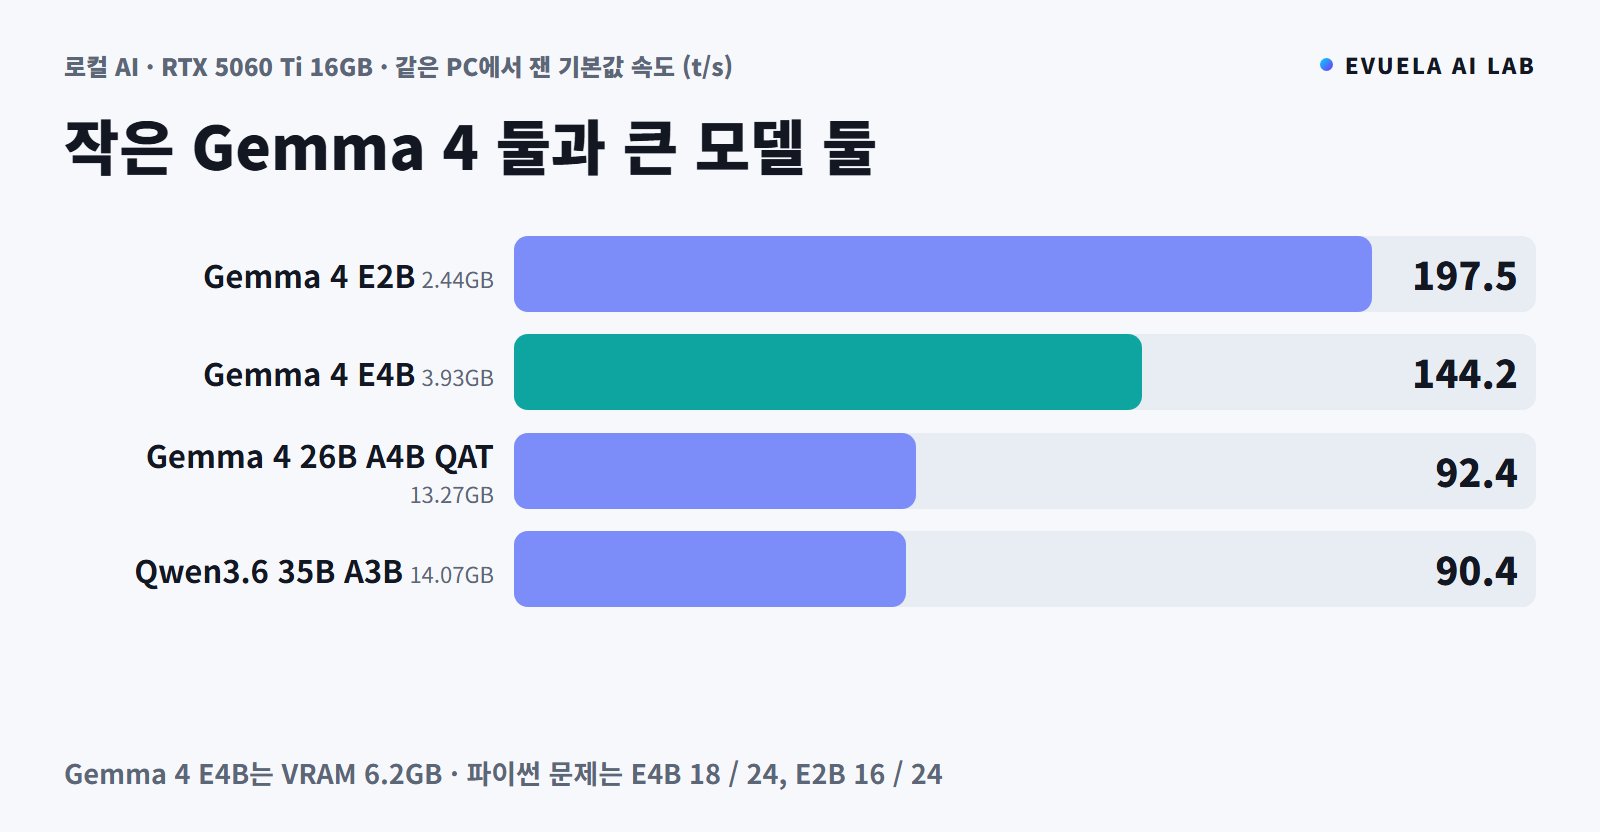
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 E4B(QAT UD-Q4_K_XL 3.93GB)를 기본값으로 돌렸습니다. VRAM 6.2GB에 초당 약 144토큰이었고, 같은 PC에서 잰 E2B와 속도·산수·코딩·사진 결과를 나란히 비교했습니다.
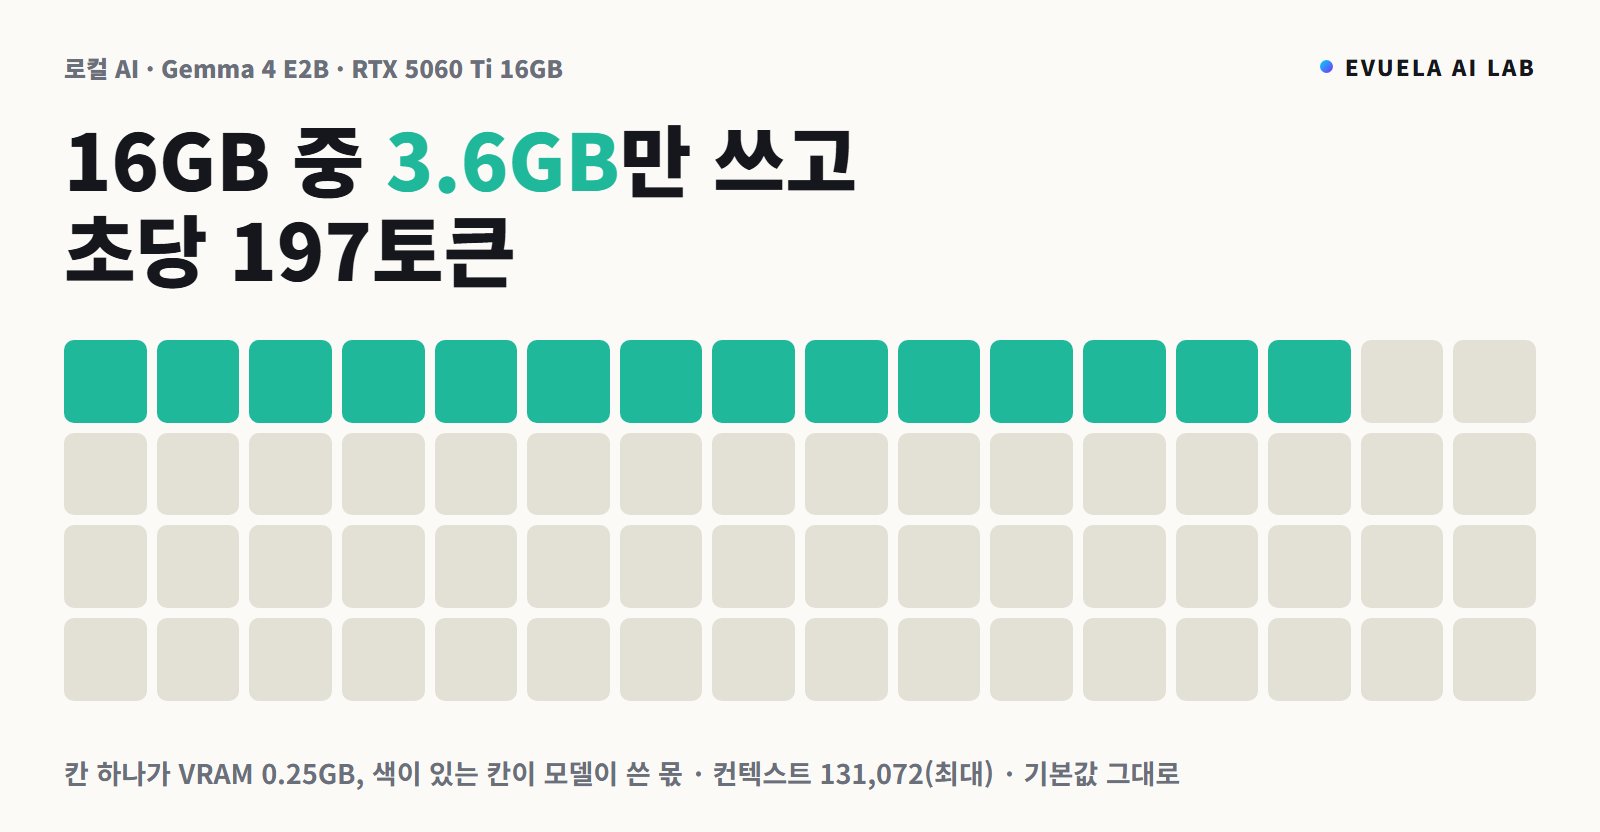
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 E2B(QAT UD-Q4_K_XL 2.44GB)를 기본값으로 돌렸습니다. VRAM 3.6GB에 초당 약 197토큰, 최대 컨텍스트 131,072에서도 같은 속도였습니다. 산수·코딩·사진 결과를 담았습니다.
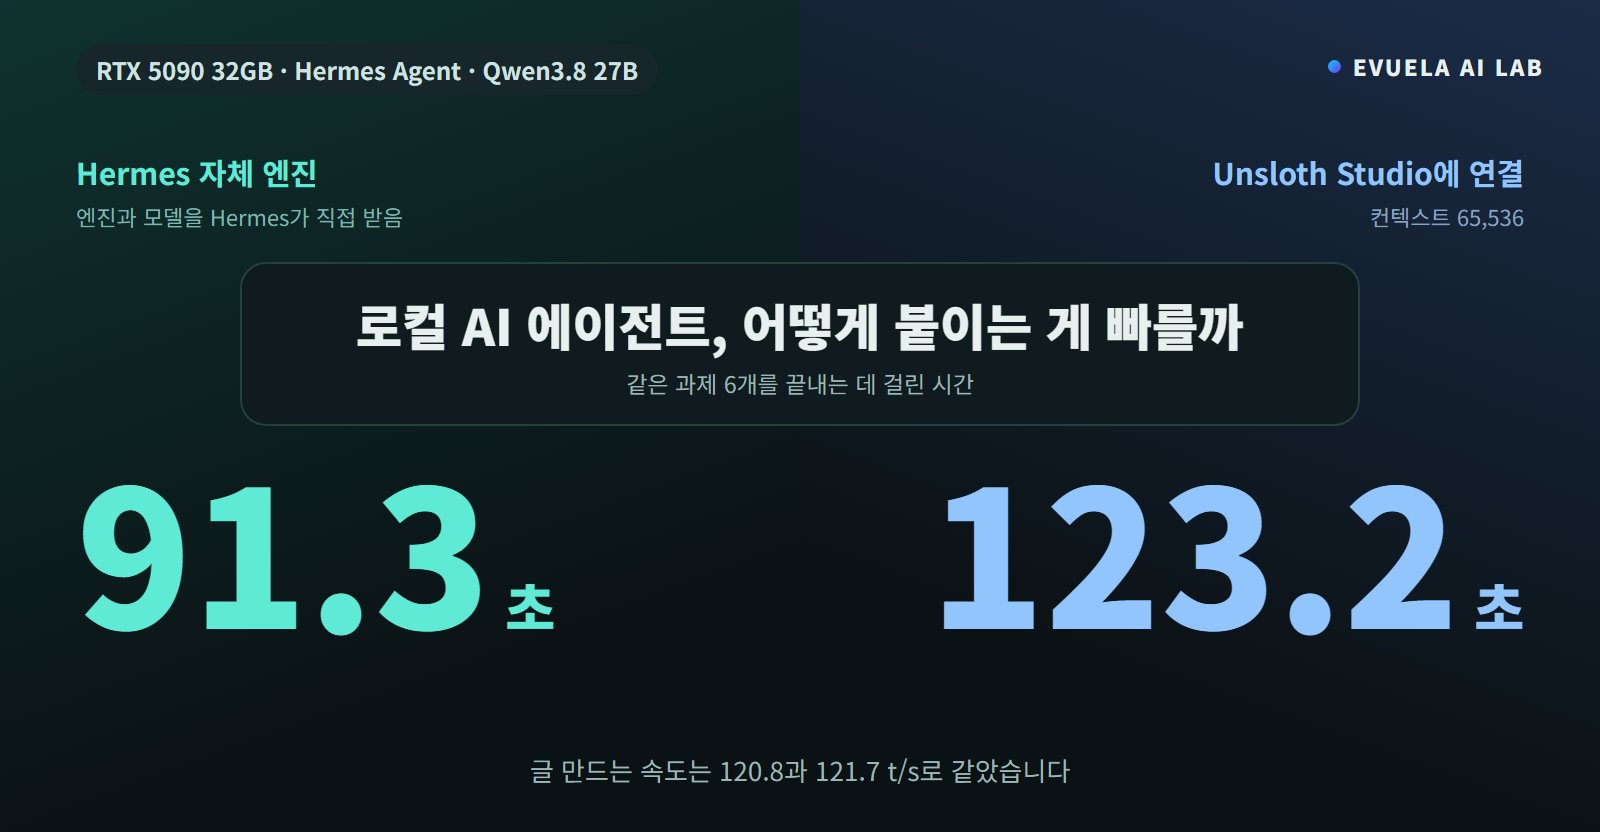
Hermes Agent를 로컬 모델에 붙이는 두 방식을 RTX 5090에서 Qwen3.8 27B로 비교했습니다. 글 만드는 속도는 120.8과 121.7 t/s로 같았지만 과제 6개는 91.3초와 123.2초였습니다. 차이는 프롬프트를 다시 읽는 양에서 났습니다.
대화에 익숙해진 다음에 해 볼 것을 코딩, 도구(MCP), API, 그림, 영상, 음성, 검색으로 정리했습니다. 그림 한 장 7.6초, 5초 영상 약 20초, 50초 음성 약 11초였고, 필요한 VRAM은 음성 3.5GB부터 영상 31.2GB까지 달랐습니다.
로컬 AI가 느리거나 답이 안 나올 때 볼 것을 증상별로 정리했습니다. 같은 3비트 파일이 레이어를 모두 그래픽카드에 올리자 초당 1.9토큰에서 28.7토큰이 됐고, 답이 멈출 때는 컨텍스트를 늘리거나 생각 단계를 낮추면 풀렸습니다.