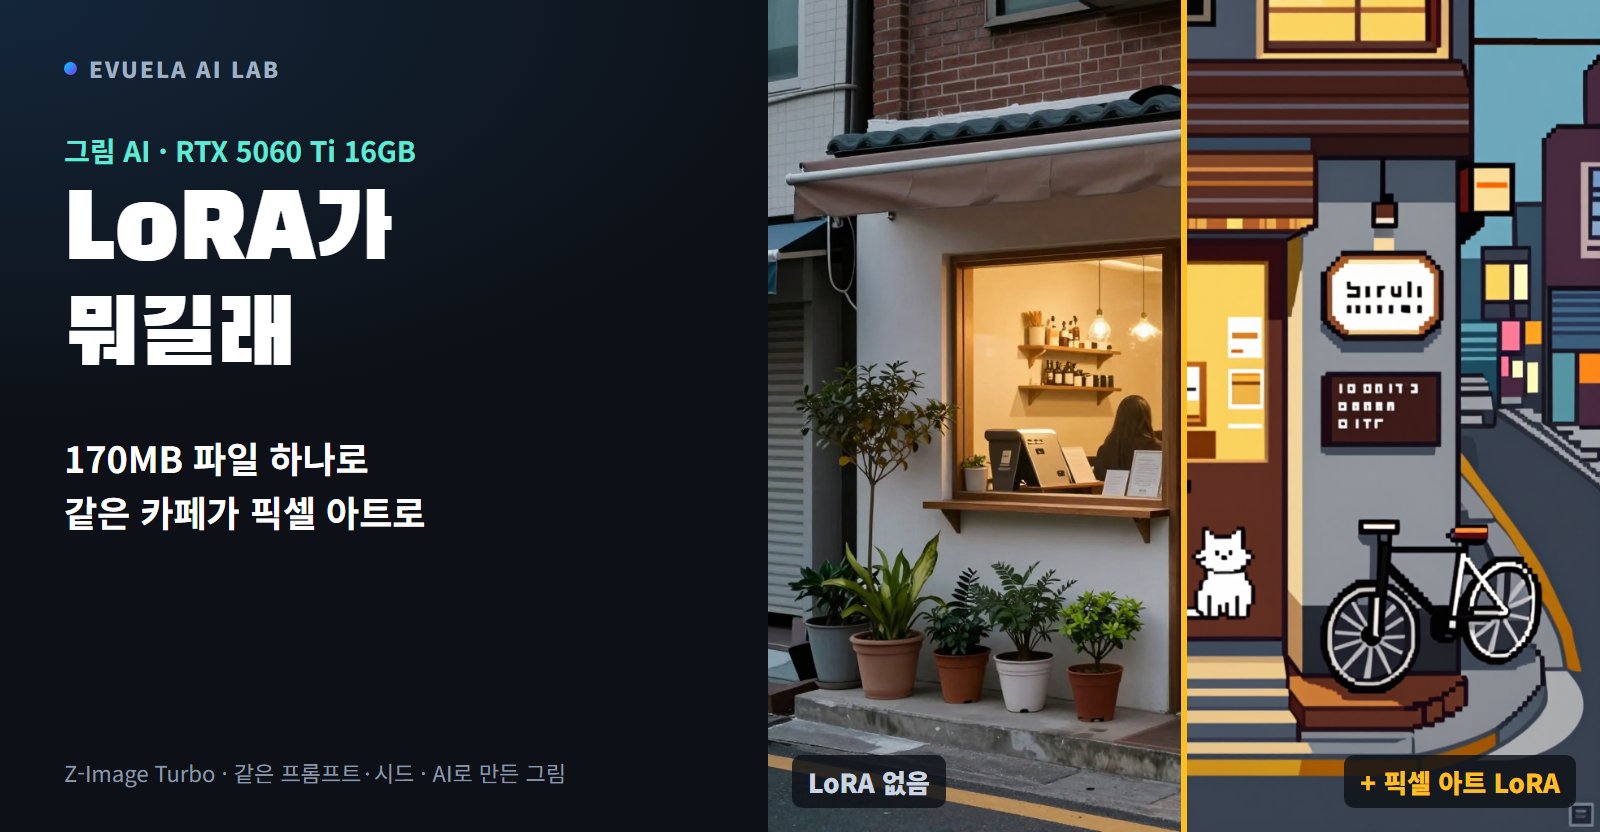
[RTX 5060 Ti 16GB] LoRA를 붙이면 그림 AI가 뭐가 달라질까? 170MB 파일 하나로 픽셀 아트가 되고 시간은 1.2초 늘었다
RTX 5060 Ti 16GB에서 Z-Image Turbo와 FLUX.2 klein 4B에 LoRA 9개를 붙여 봤습니다. 170MB 파일 하나로 픽셀 아트가 됐고 시간은 첫 장만 1.2초 늘었습니다. 배경 지우기와 바깥 늘리기는 됐고, 물건 지우기는 되지 않았습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"LoRA" 검색 결과 7건
RTX 5060 Ti 16GB에서 Z-Image Turbo와 FLUX.2 klein 4B에 LoRA 9개를 붙여 봤습니다. 170MB 파일 하나로 픽셀 아트가 됐고 시간은 첫 장만 1.2초 늘었습니다. 배경 지우기와 바깥 늘리기는 됐고, 물건 지우기는 되지 않았습니다.
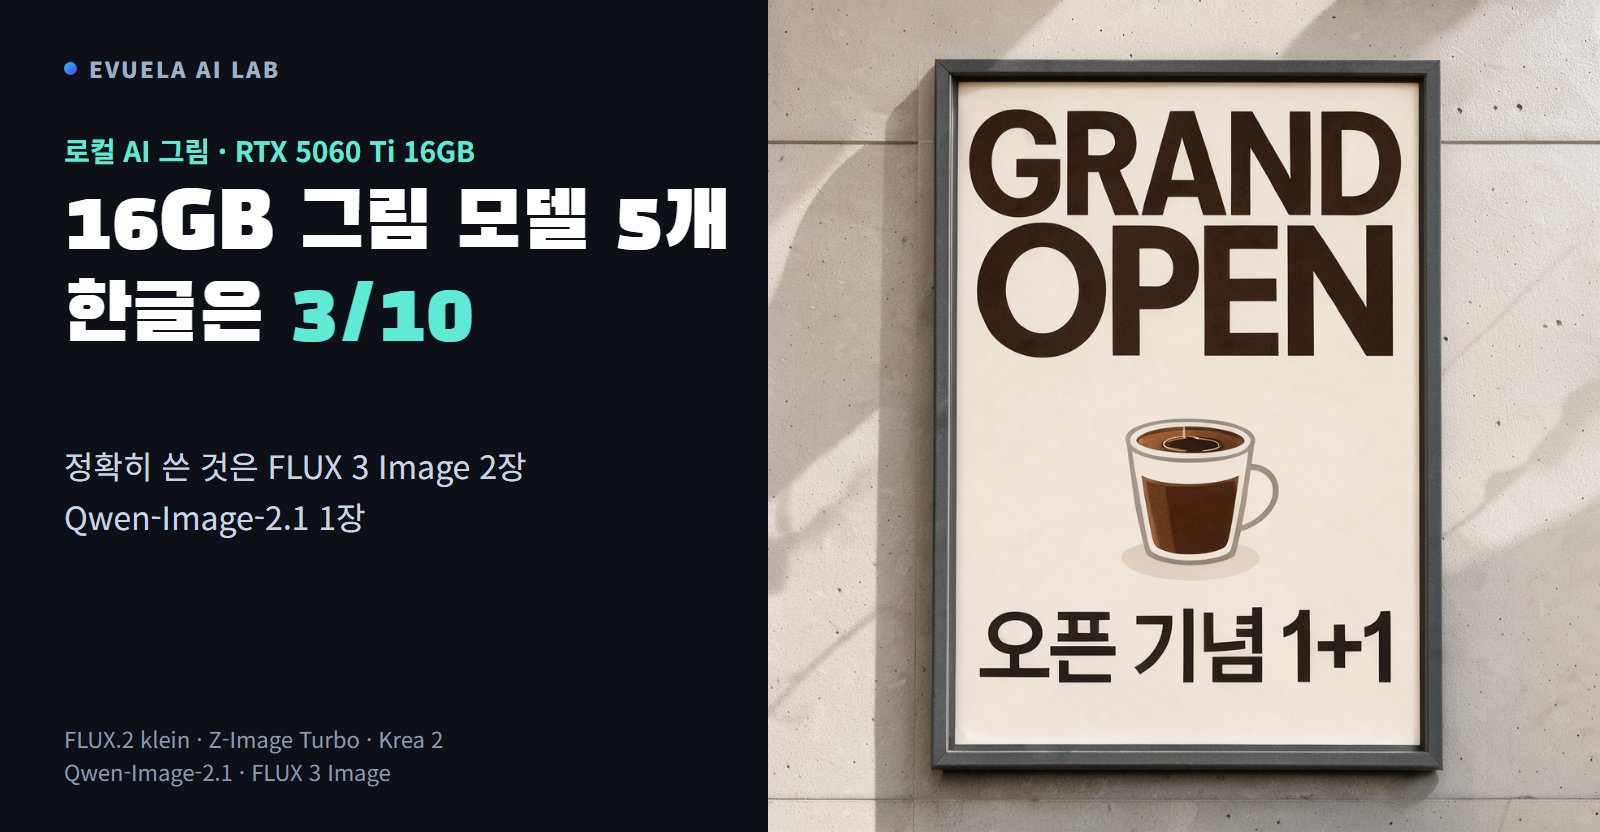
RTX 5060 Ti 16GB에서 그림 모델 5개로 같은 그림 60장을 그렸습니다. 한글 '오픈 기념 1+1'은 FLUX 3 Image klein만 2장 모두 맞혔고, 한 장은 3.7~13.8초, VRAM은 FLUX 3가 10.4GB로 가장 적었습니다.
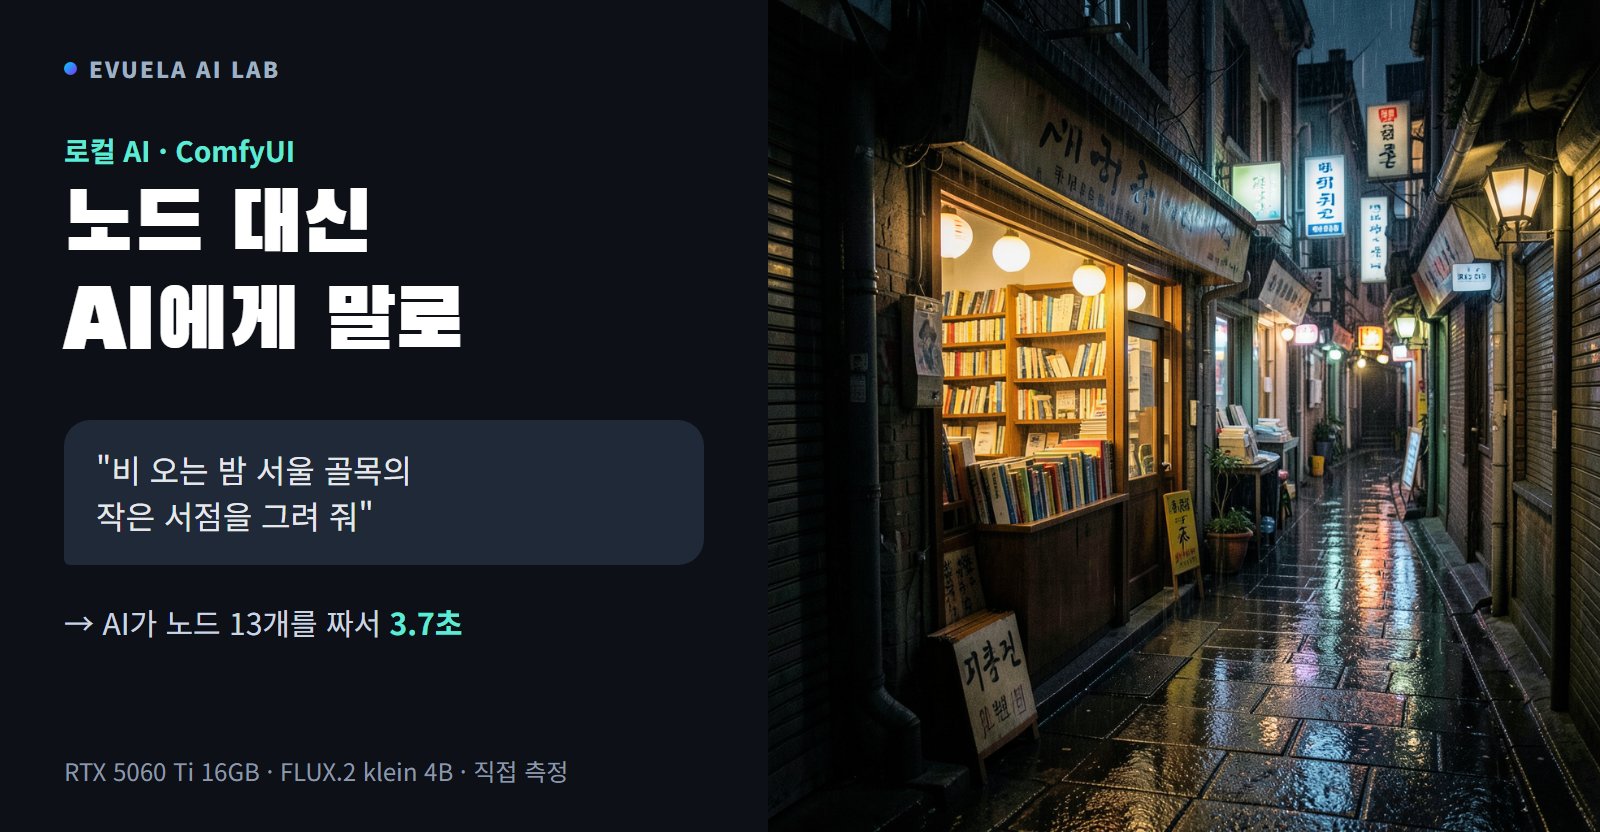
ComfyUI 노드를 잇지 않고 Claude Code에게 말로 시켜 RTX 5060 Ti 16GB에서 풍경·인물 그림 28장을 만들었습니다. 첫 장 57.2초, 그다음 3.7초, 모델을 바꾸면 37초가 더 들었고 한글 간판은 8장 모두 틀렸습니다.
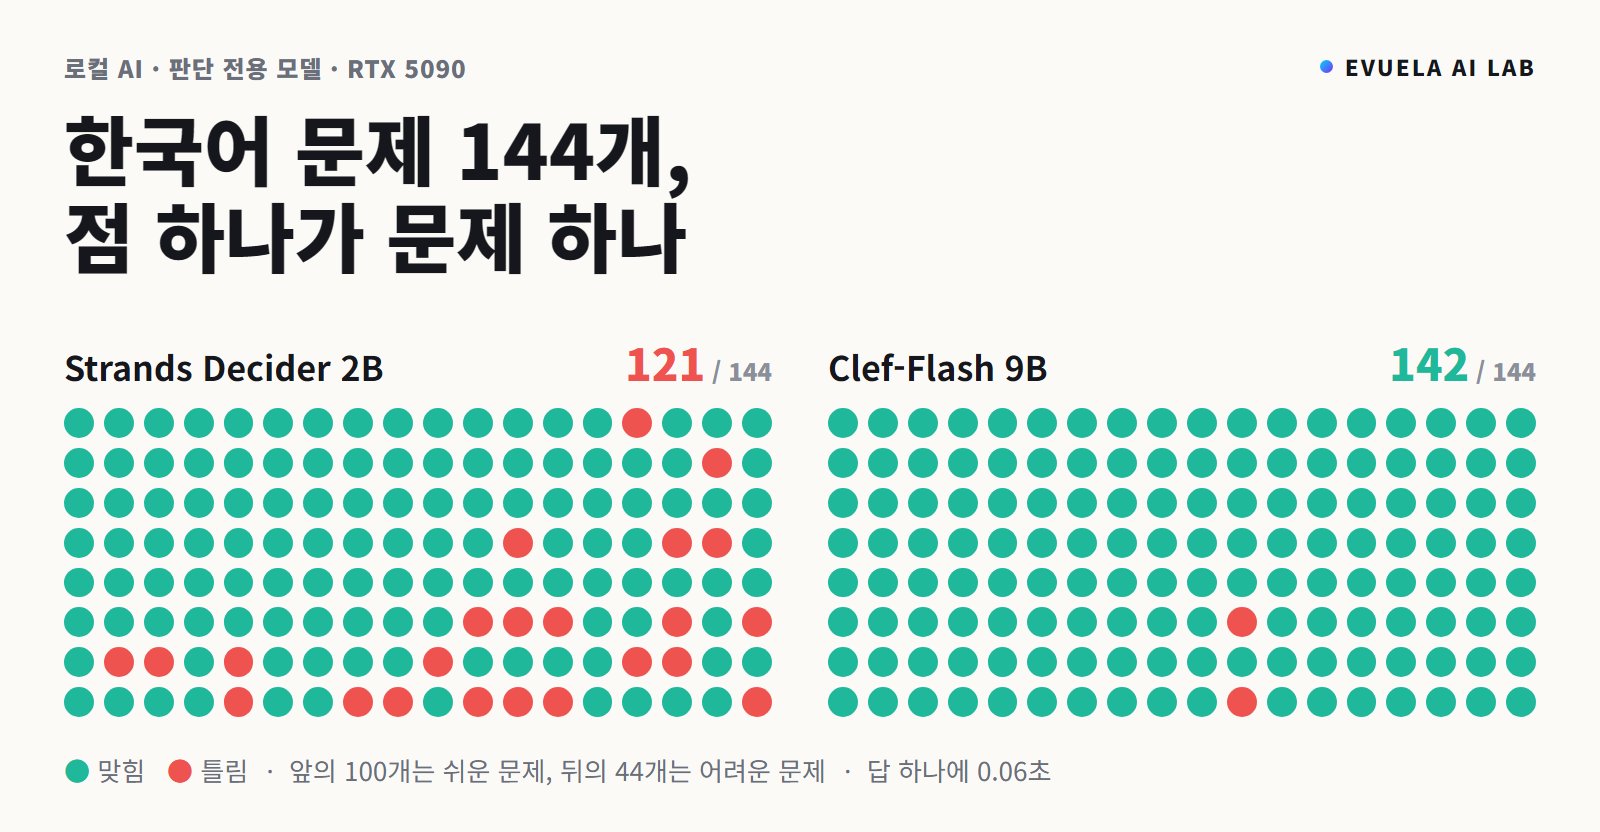
글을 쓰지 않고 보기 가운데 답을 확률로 고르는 판단 전용 모델 Strands Decider 2B와 Clef-Flash 9B를 RTX 5090에서 한국어 144문제로 비교했습니다. 쉬운 문제는 95개와 100개, 어려운 문제는 26개와 42개를 맞혔고 답 하나에 0.05~0.07초였습니다.
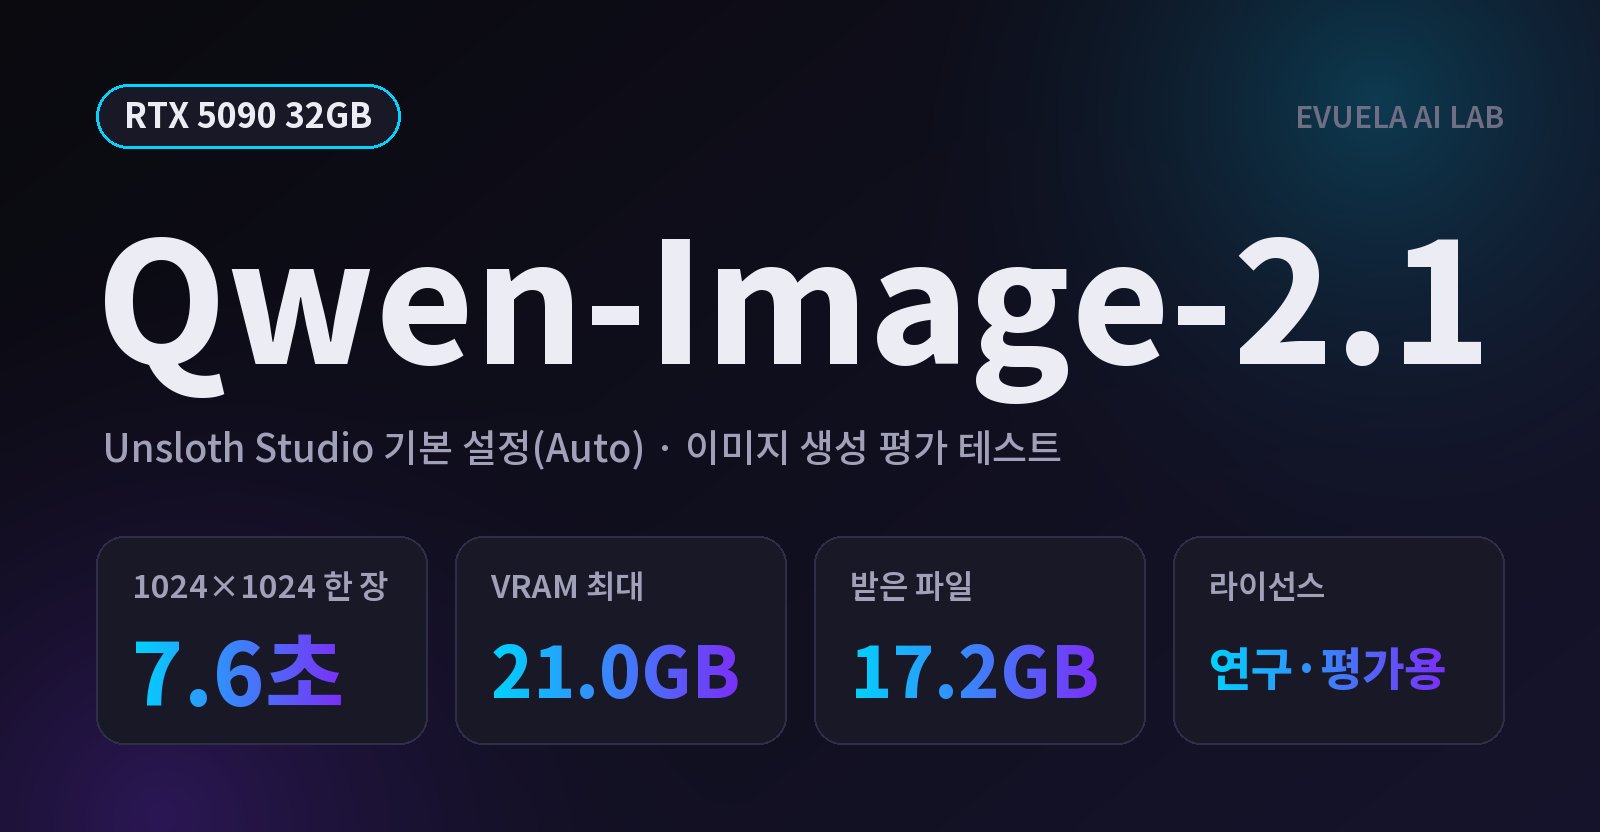
Qwen-Image-2.1을 RTX 5090에서 Unsloth Studio 기본 설정으로 돌렸습니다. 1024×1024 한 장 7.6초, VRAM 21.0GB, 받은 파일 17.2GB였습니다. 한글 글자 정확도와 연구·평가용 라이선스도 정리했습니다.
같은 Qwen3.8 27B 파일로 LM Studio와 Unsloth Studio를 비교했습니다. 기본값 속도는 65.4 대 65.6 t/s로 같았고, MTP를 켜면 35~44% 빨랐습니다. 생각 한도, 컨텍스트, 조심할 점과 앞으로의 측정 방법을 정리했습니다.
Comfy가 ComfyUI 워크플로를 커스텀 노드, 모델, LoRA까지 통째로 묶어 클라우드 GPU에 올리는 Comfy API를 열었습니다. 유료 요금제(월 20달러부터)가 필요하고 GPU는 초 단위로 냅니다(RTX PRO 6000 96GB가 1시간 4.54달러). Build·Release·Deployment가 무엇인지, 원래 있던 내 PC의 ComfyUI API와 무엇이 다른지, 실제로 얼마가 나오는지 계산과 함께 정리했습니다.