로컬 AI 시작하기 2편, Unsloth Studio 설치부터 Gemma 4 12B 첫 대화까지, 16GB는 설정 하나로 52토큰이 94토큰이 됐다
Unsloth Studio를 설치하고 Gemma 4 12B를 받아 첫 질문을 하기까지를 네 단계로 정리했습니다. 기본값으로 RTX 5090 32GB는 초당 약 233토큰, RTX 5060 Ti 16GB는 약 52토큰이었고, 16GB는 컨텍스트를 숫자로 정하면 약 94토큰이 됩니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"LM Studio" 검색 결과 43건
Unsloth Studio를 설치하고 Gemma 4 12B를 받아 첫 질문을 하기까지를 네 단계로 정리했습니다. 기본값으로 RTX 5090 32GB는 초당 약 233토큰, RTX 5060 Ti 16GB는 약 52토큰이었고, 16GB는 컨텍스트를 숫자로 정하면 약 94토큰이 됩니다.
로컬 AI는 모델을 내 PC의 그래픽카드에서 돌리는 것입니다. 필요한 것 세 가지와 VRAM 확인하는 법을 정리하고, RTX 5060 Ti 16GB와 RTX 5090 32GB에서 직접 잰 속도와 VRAM을 한 표로 모았습니다. 가이드 일곱 편의 첫 편입니다.
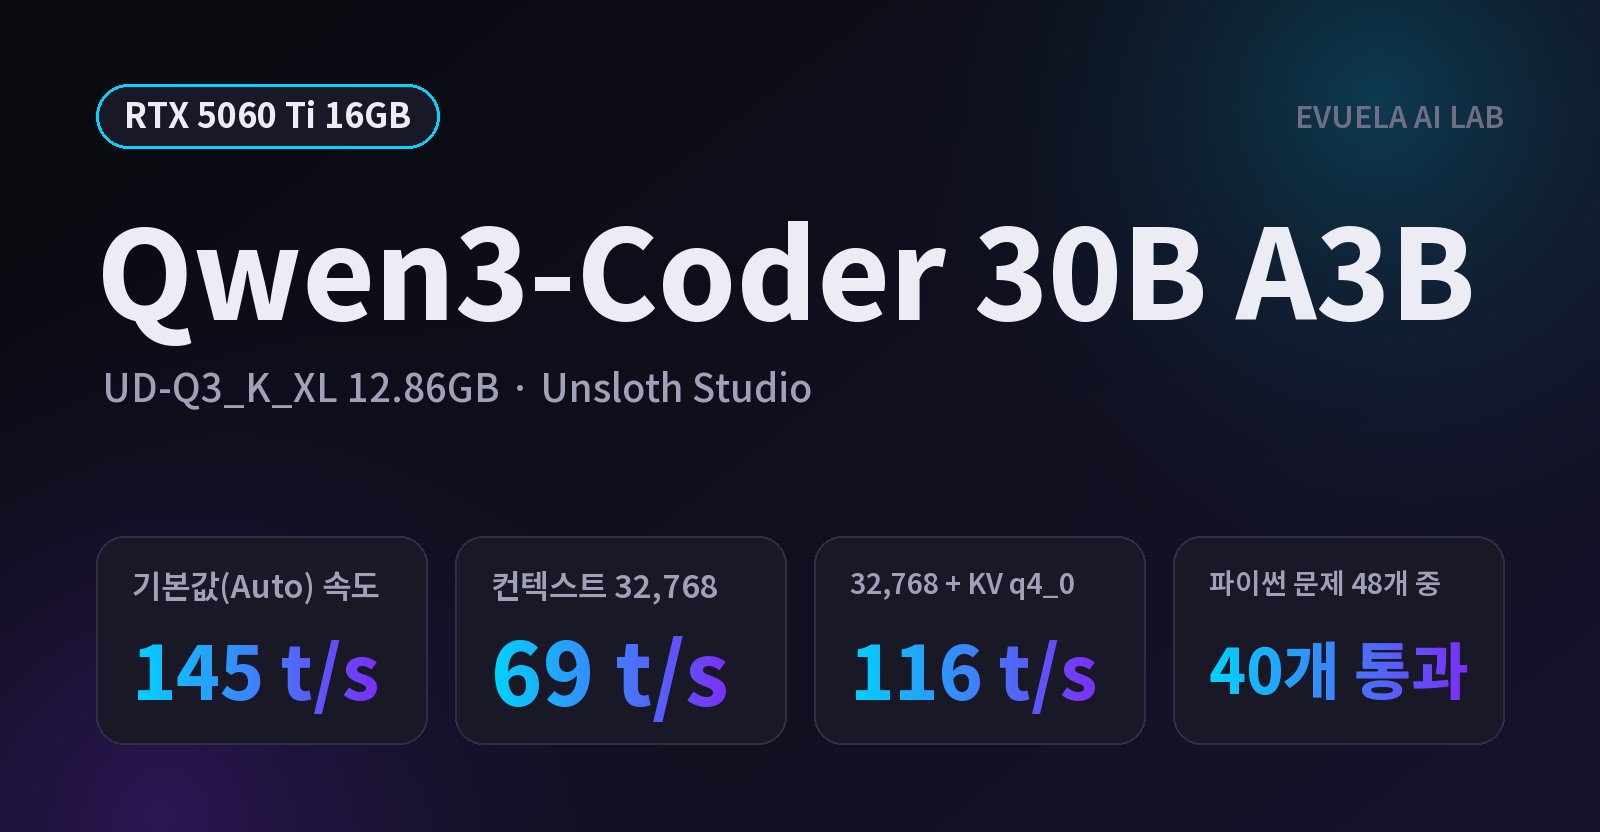
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
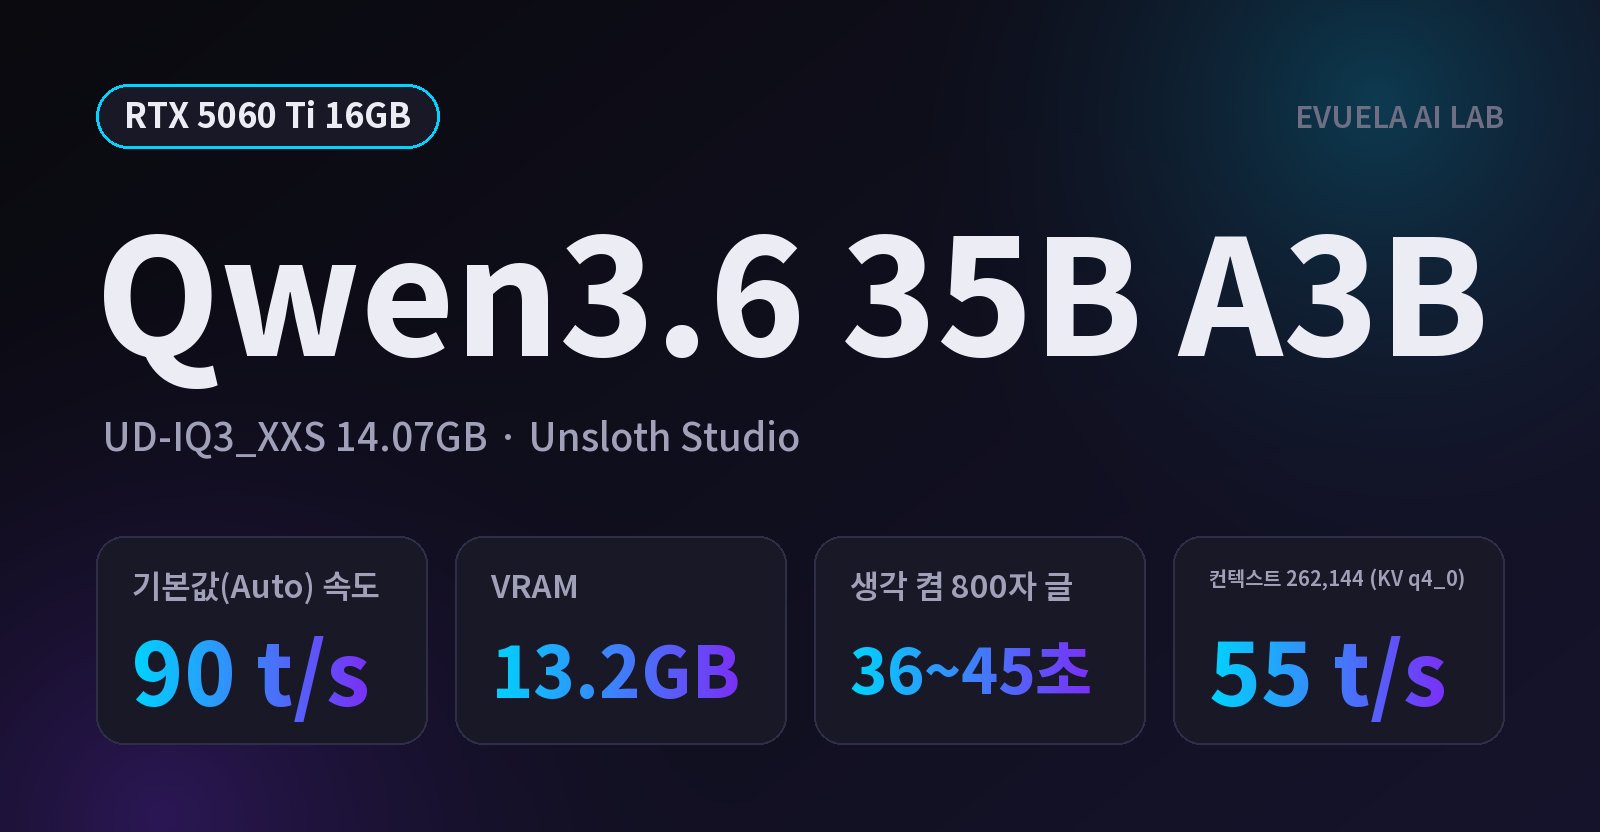
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3.6 35B A3B(UD-IQ3_XXS)를 기본값으로 돌렸습니다. VRAM 13.2GB에 다 들어갔고 초당 약 90토큰이었습니다. 컨텍스트별 속도, 설정 비교, Gemma 4 26B와의 비교를 담았습니다.
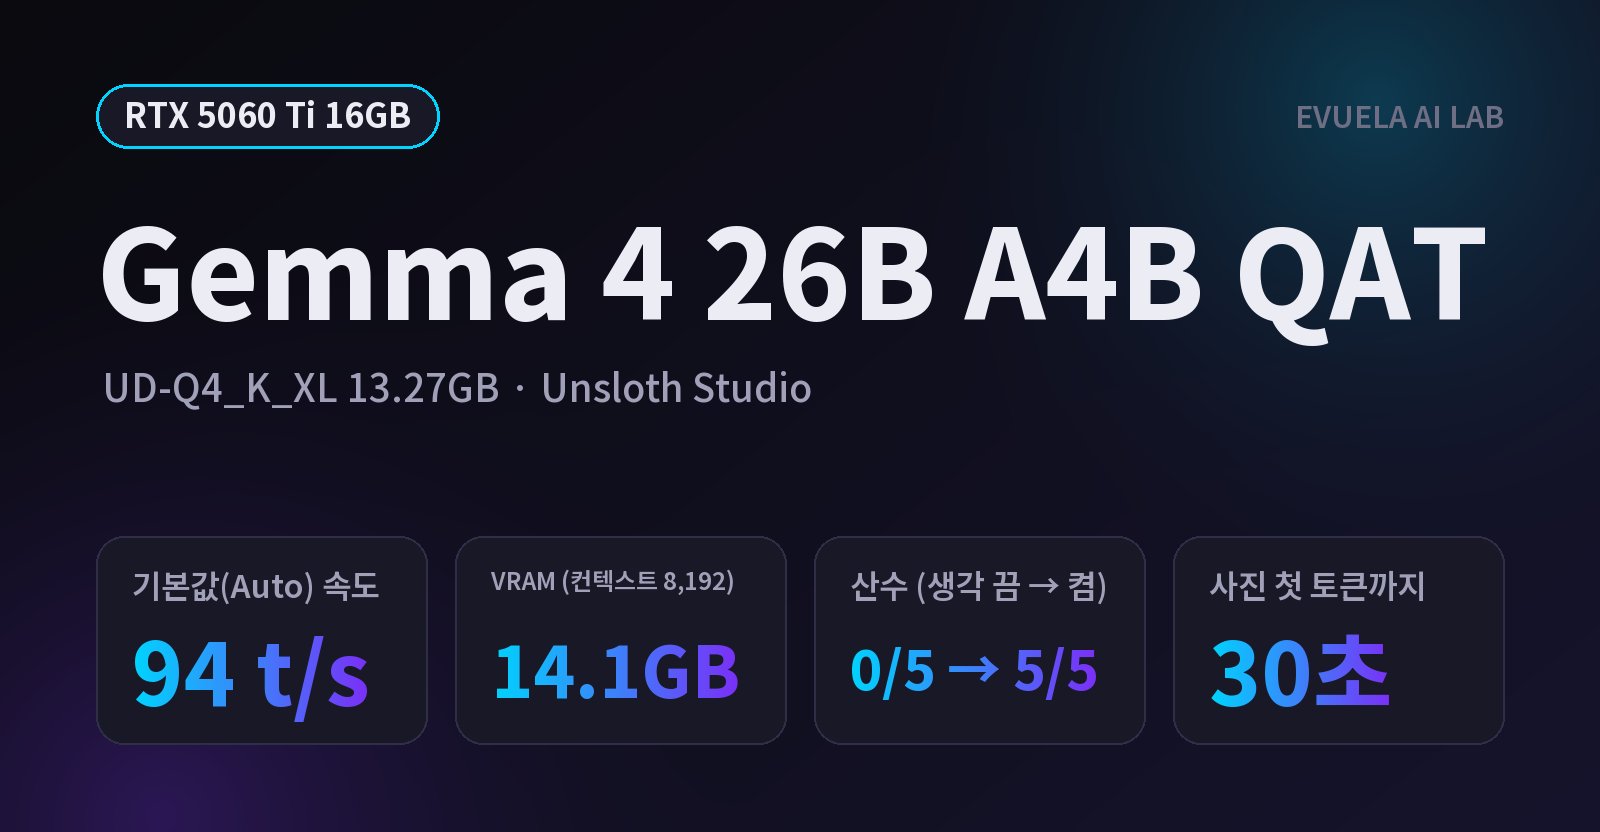
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
같은 Qwen3.8 27B 파일로 LM Studio와 Unsloth Studio를 비교했습니다. 기본값 속도는 65.4 대 65.6 t/s로 같았고, MTP를 켜면 35~44% 빨랐습니다. 생각 한도, 컨텍스트, 조심할 점과 앞으로의 측정 방법을 정리했습니다.
GitLab이 AI Gateway의 치명적 취약점 CVE-2026-90970(CVSS 9.9)을 고쳤습니다. 로그인한 사용자가 서버 명령을 실행할 수 있었습니다. 직접 설치한 곳만 해당되는지 확인하는 순서와 올릴 버전, 로컬 AI 서버에 주는 교훈을 정리했습니다.
GitHub 스타 3만 개를 받은 무료 화면 녹화·편집 앱 Recordly를 직접 설치해 써 봤습니다. 녹화, 자동 확대, 커서 효과, MP4·GIF 내보내기를 확인했고, 77초 1080p 영상은 약 12초 만에 내보냈습니다. 창 녹화 주의점과 녹화 중 로컬 AI 속도도 정리했습니다.
RTX 5060 Ti 16GB에서 Ternary Bonsai 2 27B(PQ2_0)를 PrismML llama-server로 재 봤습니다. VRAM 9.3GB, 생성 속도 약 48t/s였고, 기본 생각 단계 xhigh는 800자 글에 4~7분, medium은 14~21초였습니다.