Perplexity가 공개한 pplx-decider는 무엇이 다를까, 글 대신 확률로 답하고 바탕 모델 Qwen3.8 27B보다 11%포인트 높았다
Perplexity가 판단 모델 pplx-decider-v1-27b를 Apache 2.0으로 공개했습니다. 글 대신 확률로 답하고, 11가지 시험에서 바탕 모델 Qwen3.8 27B보다 약 11%포인트 높았습니다. 요금 계산과 RTX 5090·16GB 그래픽카드에서 돌릴 수 있는지도 정리했습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"GGUF" 검색 결과 35건
Perplexity가 판단 모델 pplx-decider-v1-27b를 Apache 2.0으로 공개했습니다. 글 대신 확률로 답하고, 11가지 시험에서 바탕 모델 Qwen3.8 27B보다 약 11%포인트 높았습니다. 요금 계산과 RTX 5090·16GB 그래픽카드에서 돌릴 수 있는지도 정리했습니다.
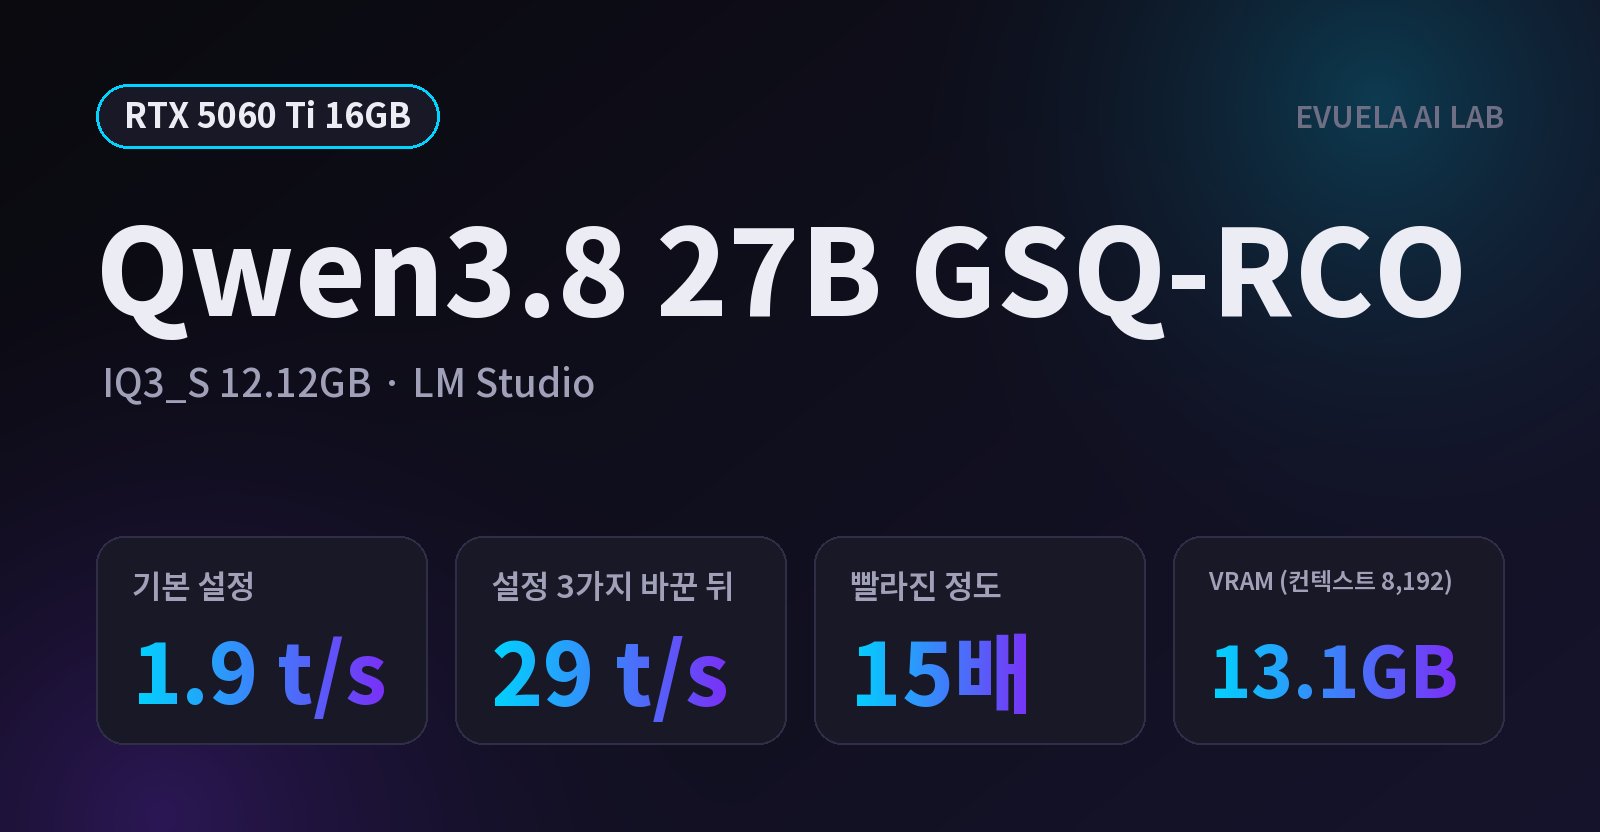
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.8 27B GSQ-RCO(IQ3_S, 12.12GB)를 재 봤습니다. 기본 설정에서는 65개 레이어 중 56~58개만 GPU에 올라가 약 1.9t/s였고, Limit Model Offload 끄기·GPU 오프로드 최대·MTP 끄기 세 가지를 바꾸자 약 29t/s가 됐습니다. VRAM은 13.1GB, 컨텍스트는 32,768까지 맞았습니다.
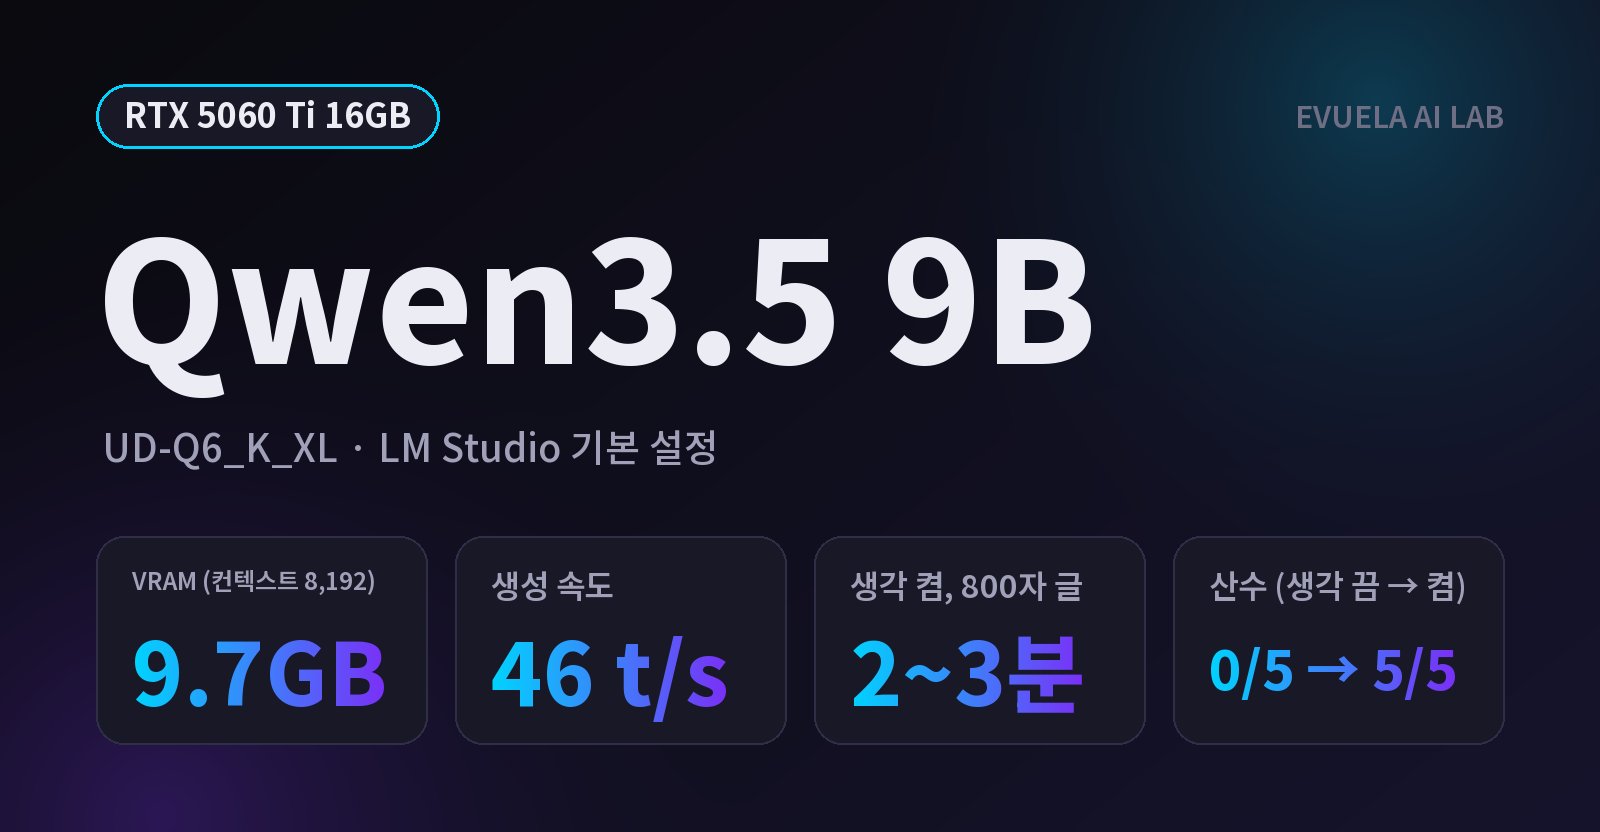
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.5 9B(UD-Q6_K_XL)를 기본 설정으로 재 봤습니다. VRAM 9.7GB, 약 46t/s였고 컨텍스트 131,072까지 VRAM에 다 들어갔습니다. 생각을 켜면 산수는 5번 모두 맞았지만 800자 글에 2~3분이 걸렸습니다. Ornith 1.5 9B와도 비교했습니다.
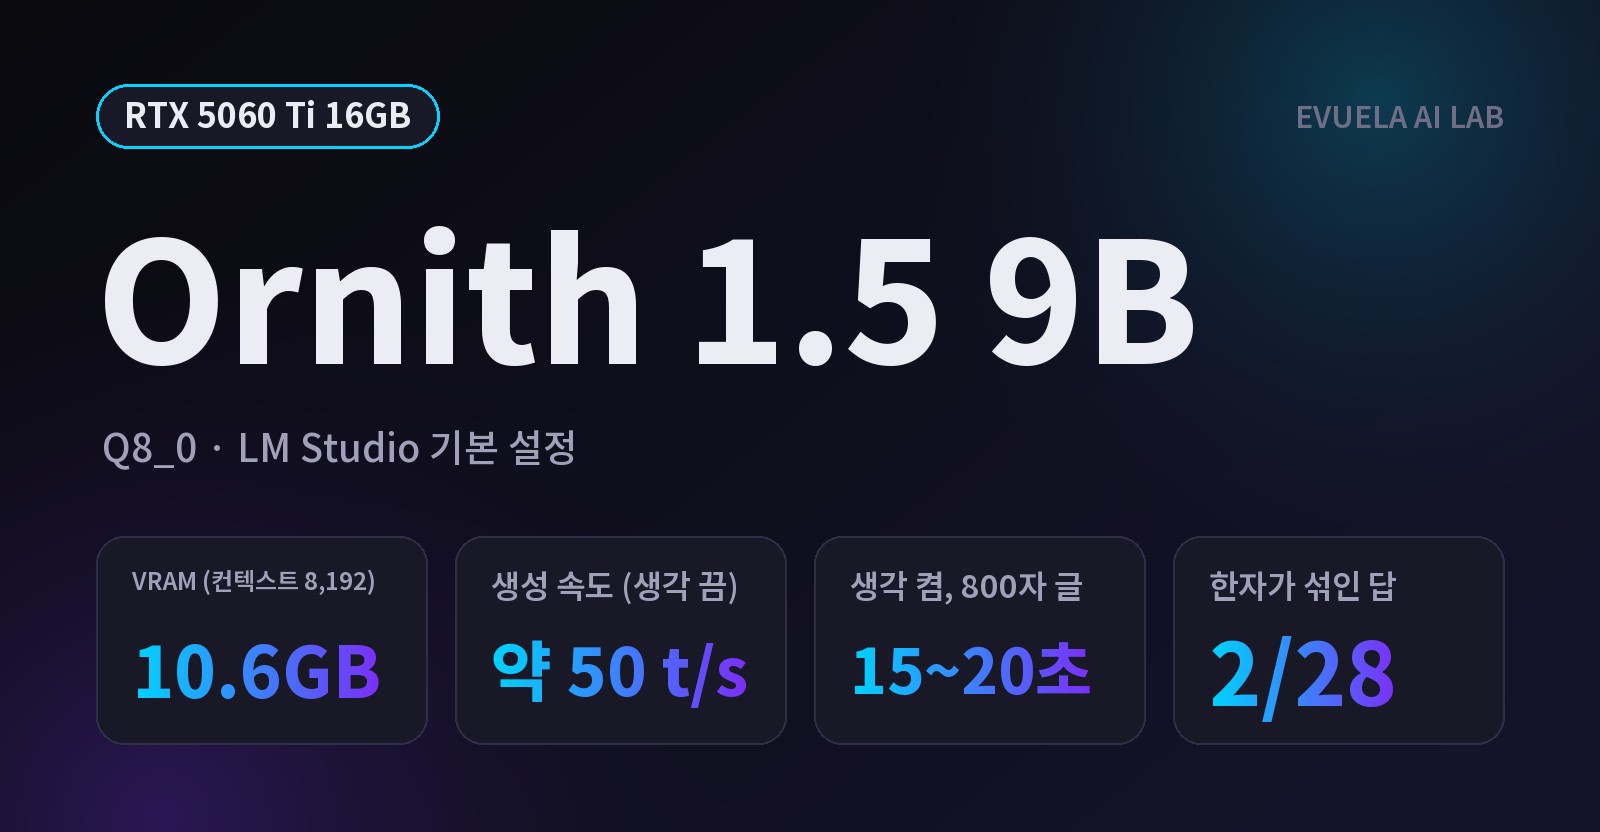
RTX 5060 Ti 16GB PC의 LM Studio에서 Ornith 1.5 9B(Q8_0, 9.79GB)를 기본 설정으로 재 봤습니다. VRAM 10.6GB, 생각 끔 약 50t/s, 생각 켬 56~65t/s였고 생각을 켜도 800자 글이 20초 안에 끝났습니다. 한국어 답 28개 중 2개에 한자가 섞였고, 형식 지시는 지키지 않았습니다.
AMD Ryzen AI Max PRO 400 시리즈가 들어간 PC가 팔리기 시작했습니다. 통합 메모리 192GB 가운데 160GB를 AI 모델에 쓸 수 있고, AMD는 300B 모델까지 돌릴 수 있다고 밝혔습니다. 공식 발표를 정리하고, 직접 잰 Qwen3.8 27B 파일 크기와 RTX 5090 속도를 가져와 300B가 정말 들어가는지, 들어가면 얼마나 빠를지 계산했습니다. 제품 가격과 RTX 5090과의 차이도 함께 담았습니다.
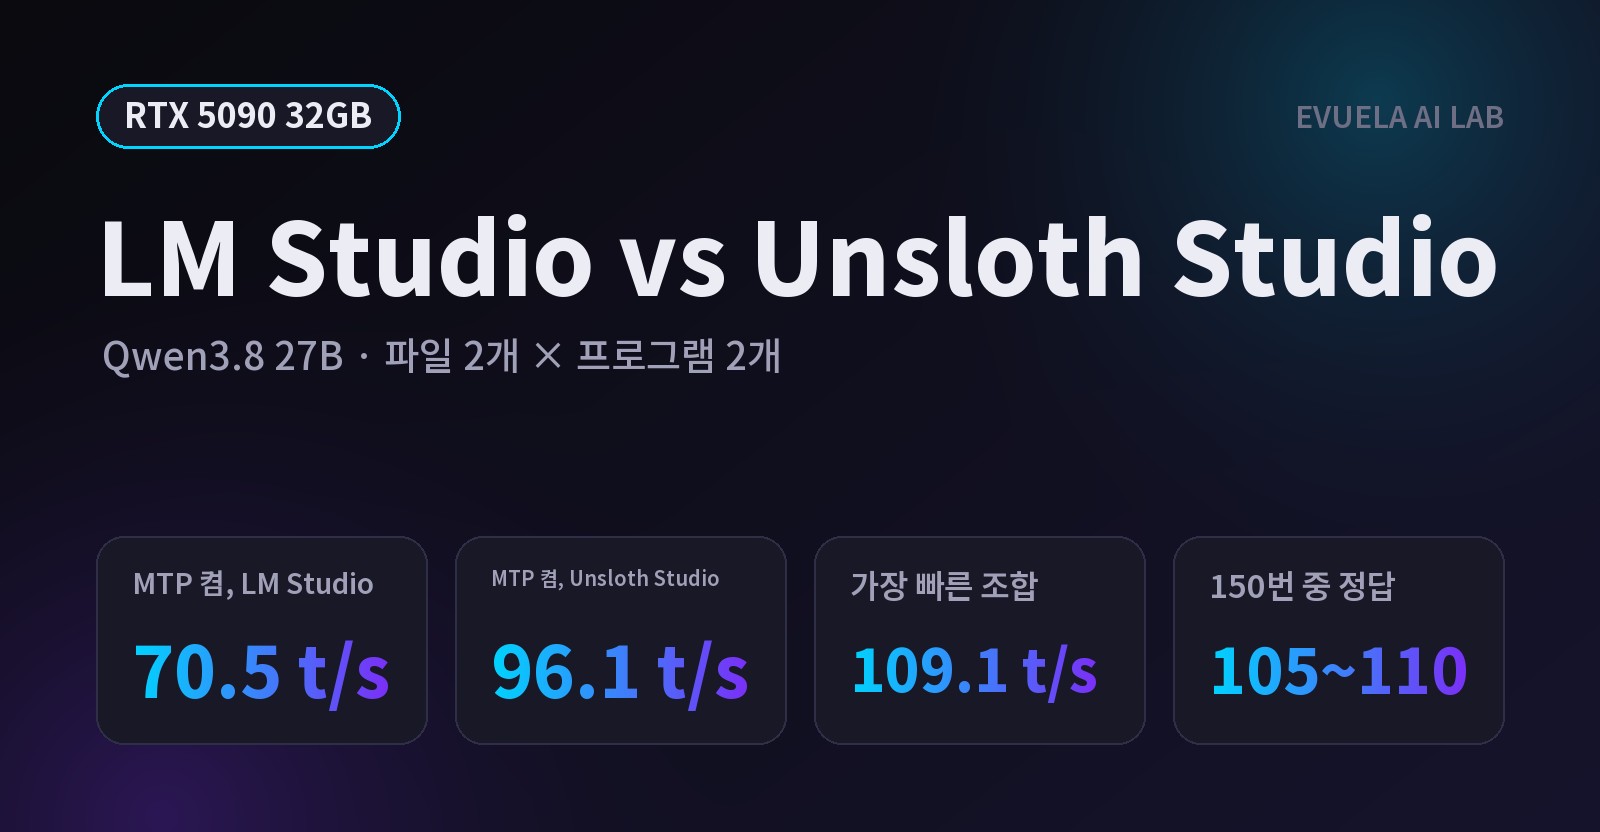
RTX 5090에서 Qwen3.8 27B 파일 두 개(lmstudio-community Q4_K_M, unsloth UD-Q4_K_XL)를 LM Studio와 Unsloth Studio에 차례로 올리고 설정을 똑같이 맞춰 쟀습니다. MTP를 끄면 두 프로그램의 속도가 거의 같았고, MTP를 켜면 Unsloth Studio가 35~36% 빨랐습니다. lmstudio-community 파일은 두 프로그램 모두에서 8~15% 더 빨랐고, 정답률은 네 조합이 같았습니다. 생각 설정의 차이와 두 프로그램 화면 캡처도 함께 정리했습니다.
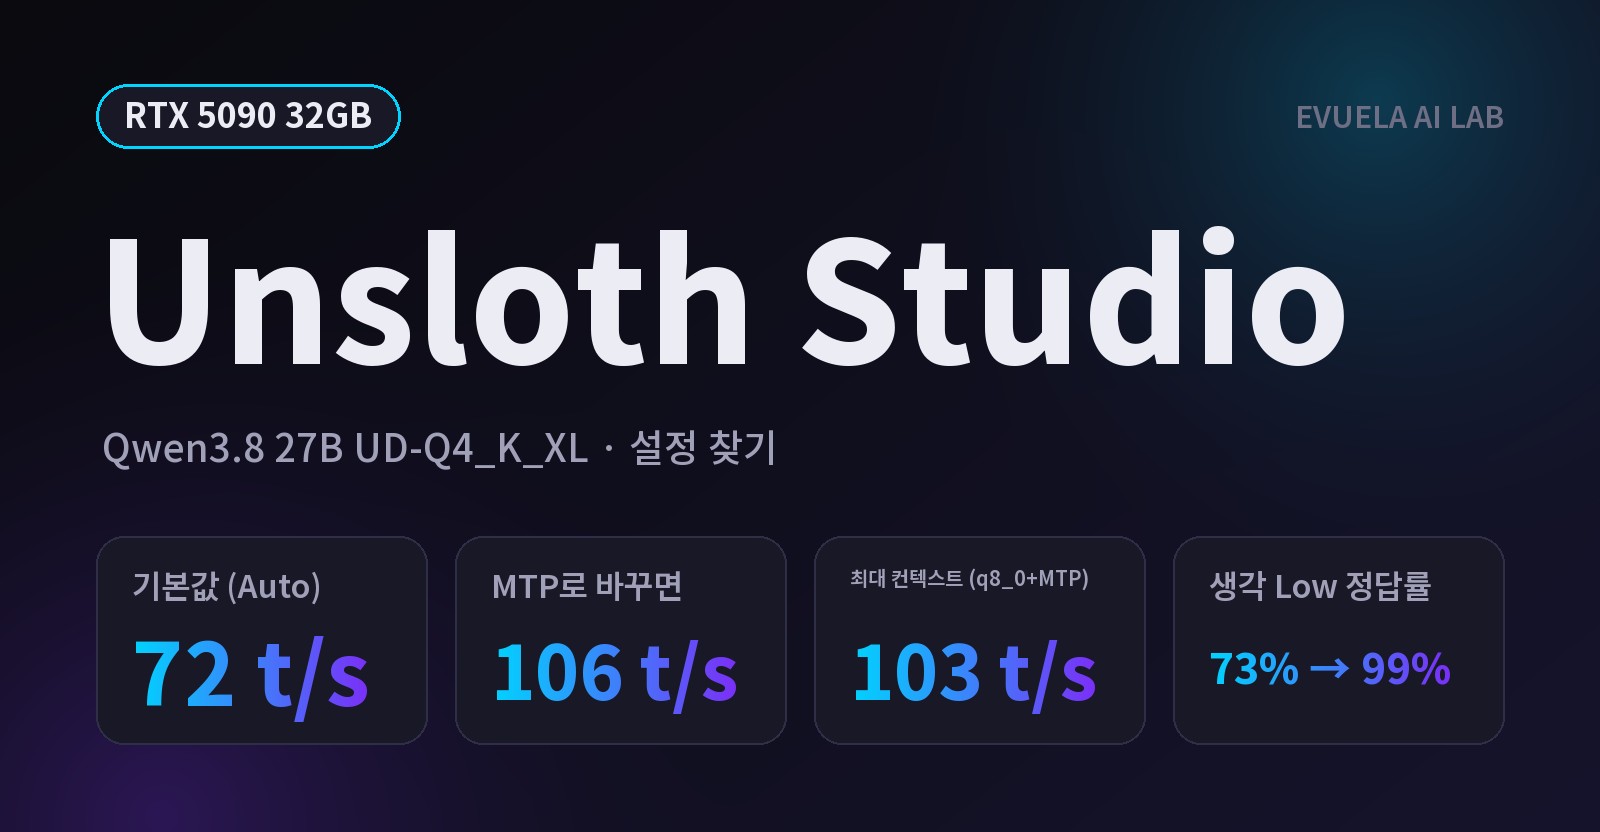
Unsloth Studio를 RTX 5090에 설치하고 Qwen3.8 27B(UD-Q4_K_XL)로 설정을 하나씩 바꿔 가며 쟀습니다. 기본값은 컨텍스트를 16만 8천 토큰으로 알아서 잡았고 초당 72토큰이었습니다. 속도 기능을 MTP로 바꾸면 48% 빨라졌고, KV 캐시를 q8_0으로 줄이면 최대 컨텍스트 262,144에서도 초당 103토큰이 나왔습니다. 생각 단계별 정답률, 화면 캡처, 쓰임새별 추천 설정을 정리했습니다.
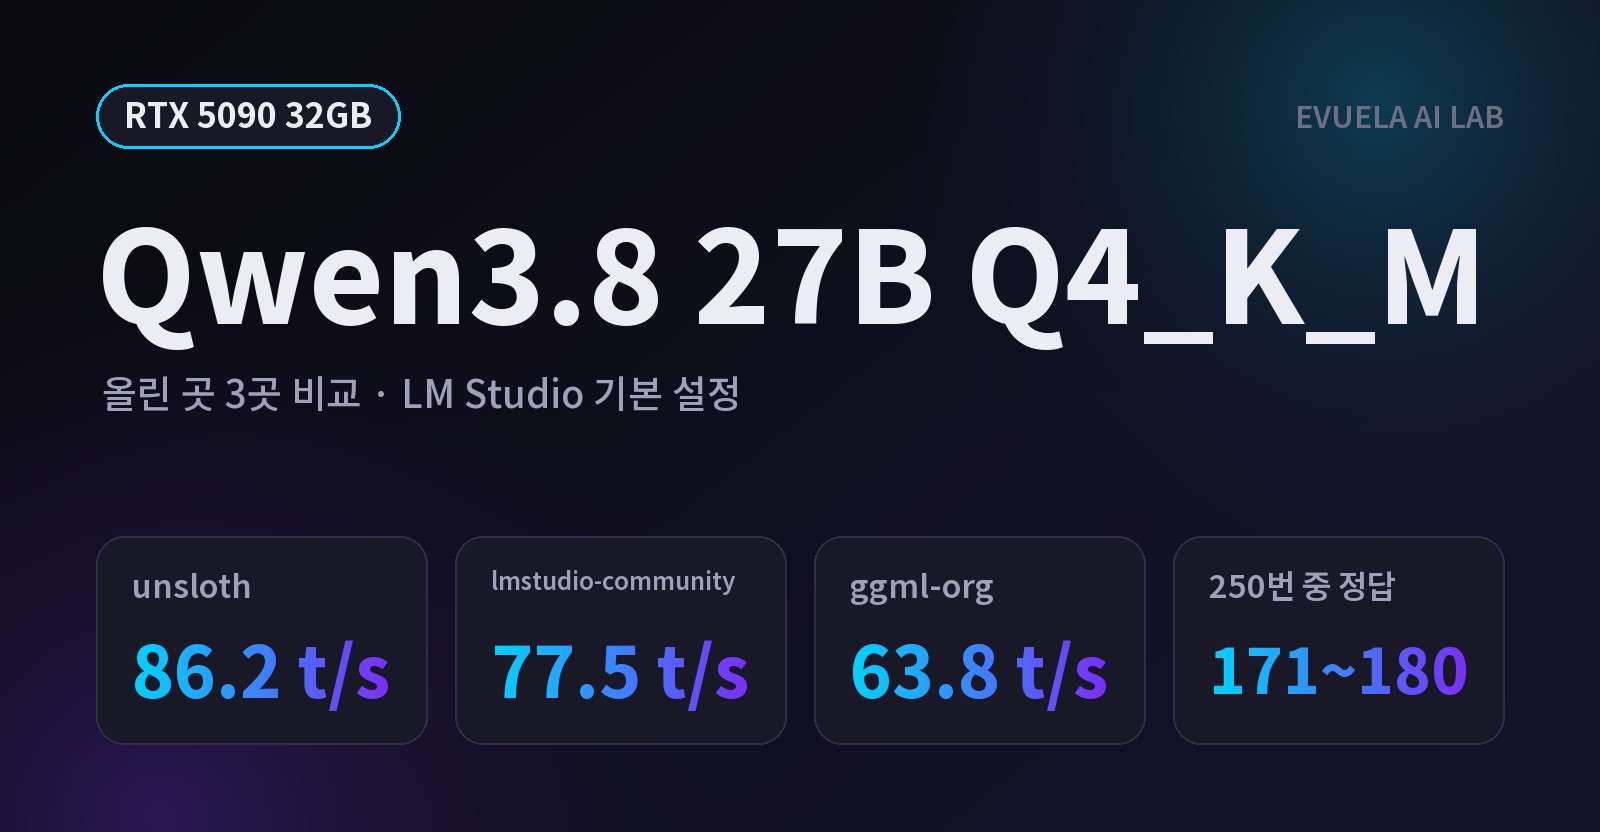
Qwen3.8 27B Q4_K_M 파일을 lmstudio-community, unsloth, ggml-org 세 곳에서 받아 RTX 5090과 LM Studio로 비교했습니다. 채점 질문 250번 중 171~180번을 맞혀 정답률은 거의 같았고, 생성 속도는 초당 63.8~86.2토큰으로 달랐습니다. 차이는 파일 안에 MTP 레이어가 있느냐에서 나왔습니다. 파일 속 양자화 구성, VRAM, MCP 도구 호출 결과와 LM Studio 캡처를 함께 정리했습니다.
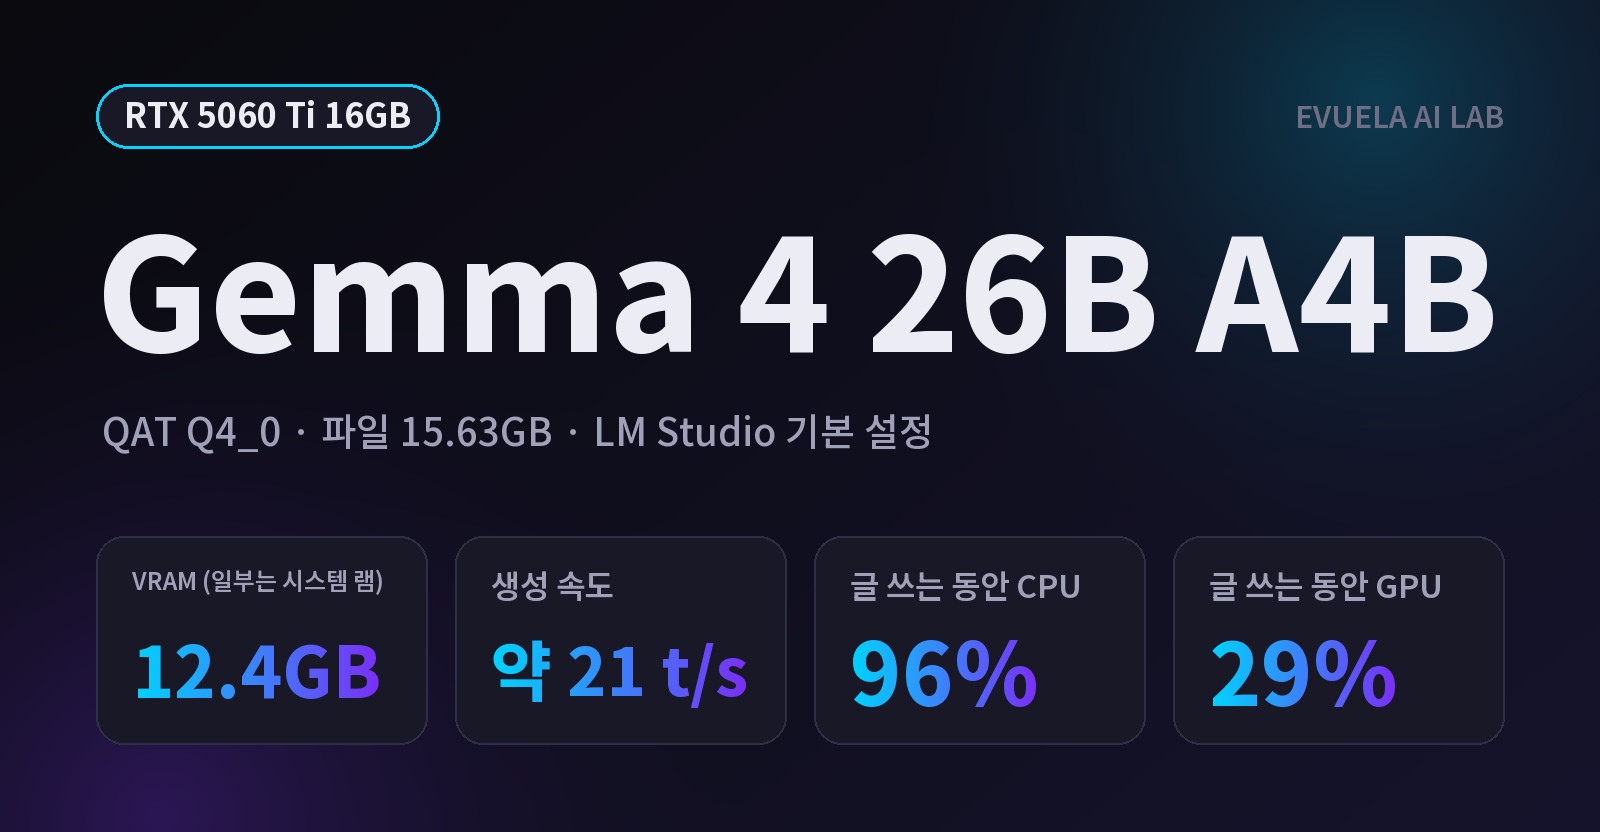
RTX 5060 Ti 16GB PC의 LM Studio에서 Gemma 4 26B A4B QAT(15.63GB)를 기본 설정 그대로 돌려 봤습니다. 모델은 로드됐지만 일부가 시스템 램에 남아, 답을 만드는 동안 CPU는 96%, GPU는 29%였습니다. 생성 속도는 약 21t/s로 같은 PC의 Gemma 4 12B의 절반이었습니다.