[RTX 5060 Ti 16GB] 16GB 그래픽카드에서 Gemma 4 26B는 얼마나 빠를까, Unsloth Studio 기본값으로 초당 94토큰이었다
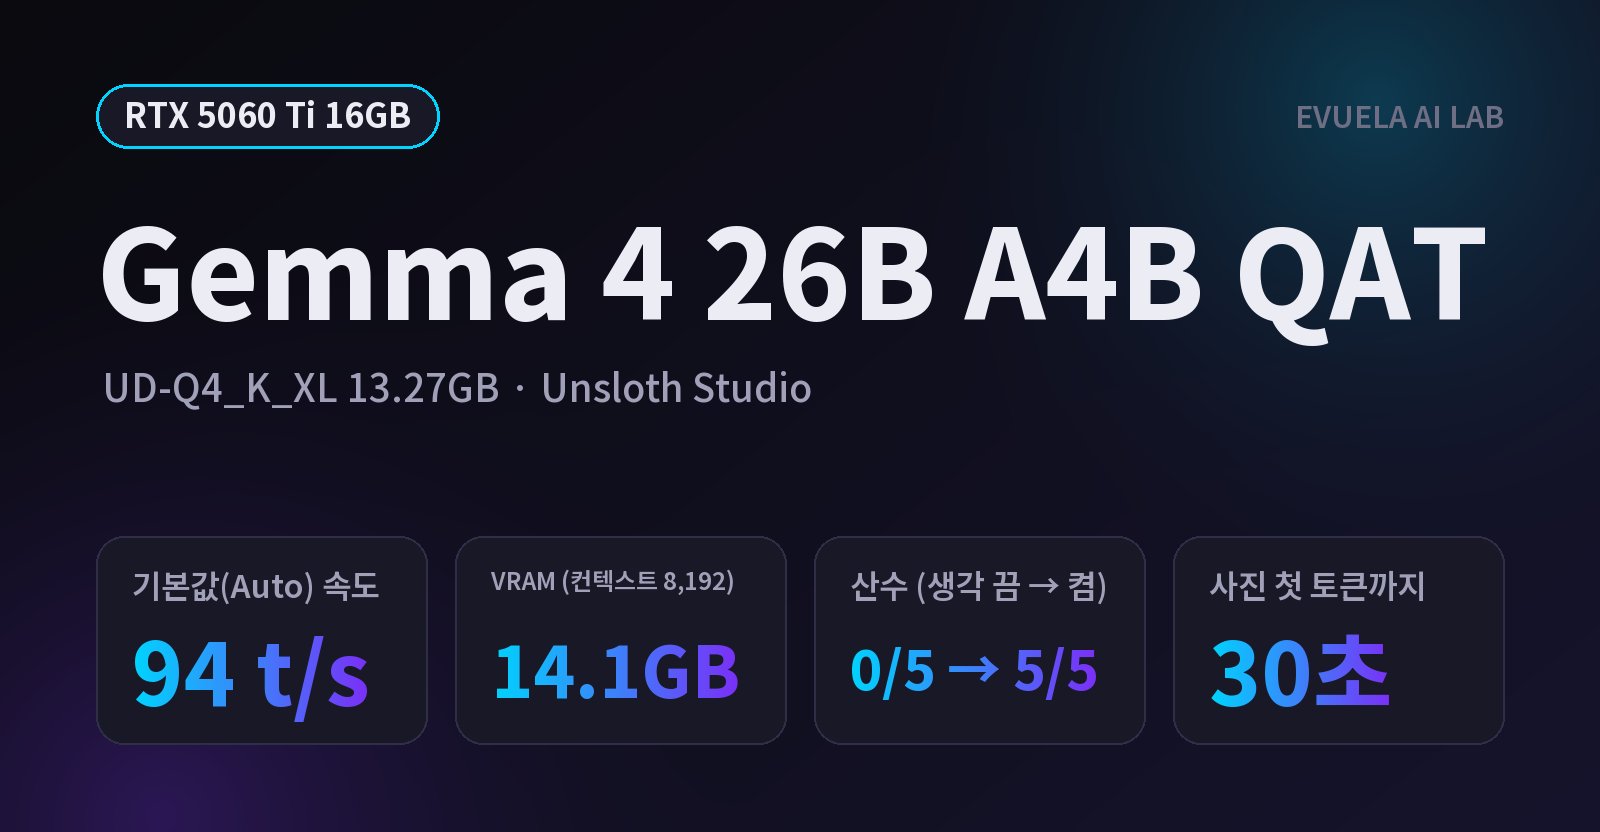
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"QAT" 검색 결과 29건
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
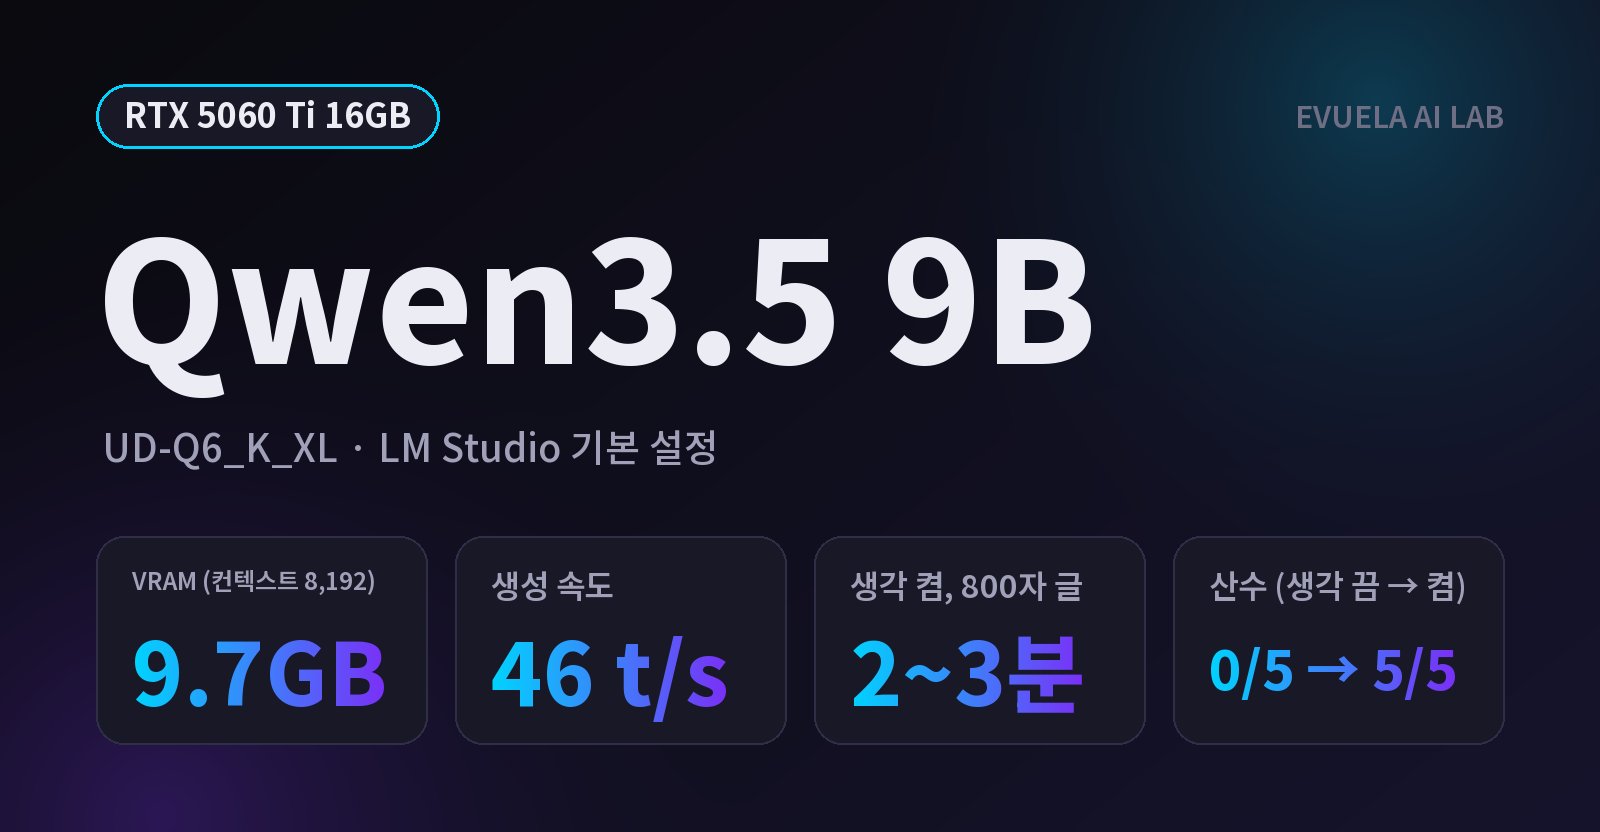
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.5 9B(UD-Q6_K_XL)를 기본 설정으로 재 봤습니다. VRAM 9.7GB, 약 46t/s였고 컨텍스트 131,072까지 VRAM에 다 들어갔습니다. 생각을 켜면 산수는 5번 모두 맞았지만 800자 글에 2~3분이 걸렸습니다. Ornith 1.5 9B와도 비교했습니다.
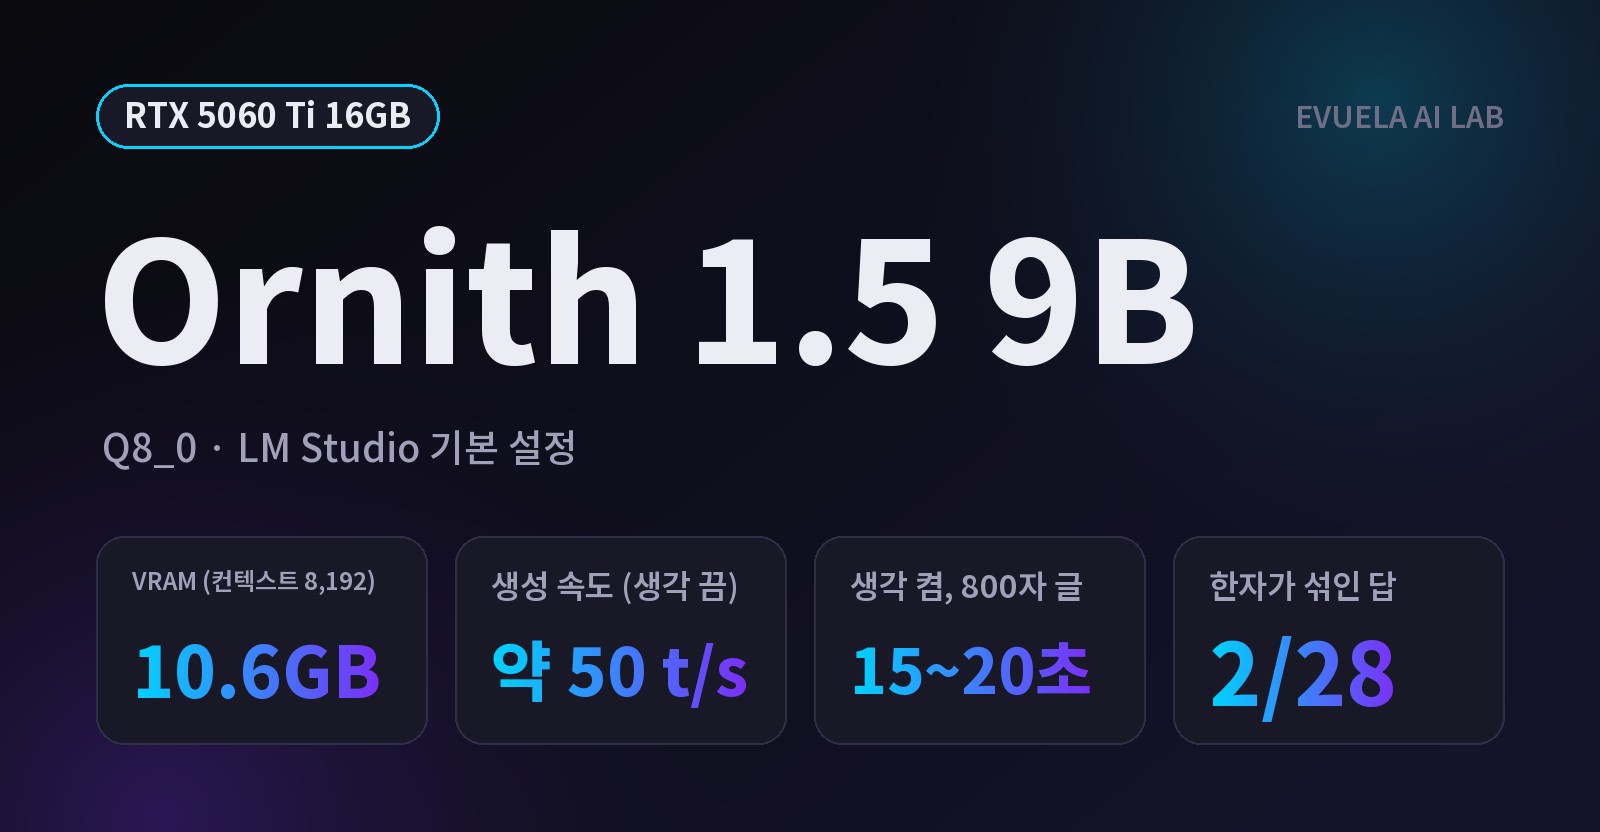
RTX 5060 Ti 16GB PC의 LM Studio에서 Ornith 1.5 9B(Q8_0, 9.79GB)를 기본 설정으로 재 봤습니다. VRAM 10.6GB, 생각 끔 약 50t/s, 생각 켬 56~65t/s였고 생각을 켜도 800자 글이 20초 안에 끝났습니다. 한국어 답 28개 중 2개에 한자가 섞였고, 형식 지시는 지키지 않았습니다.
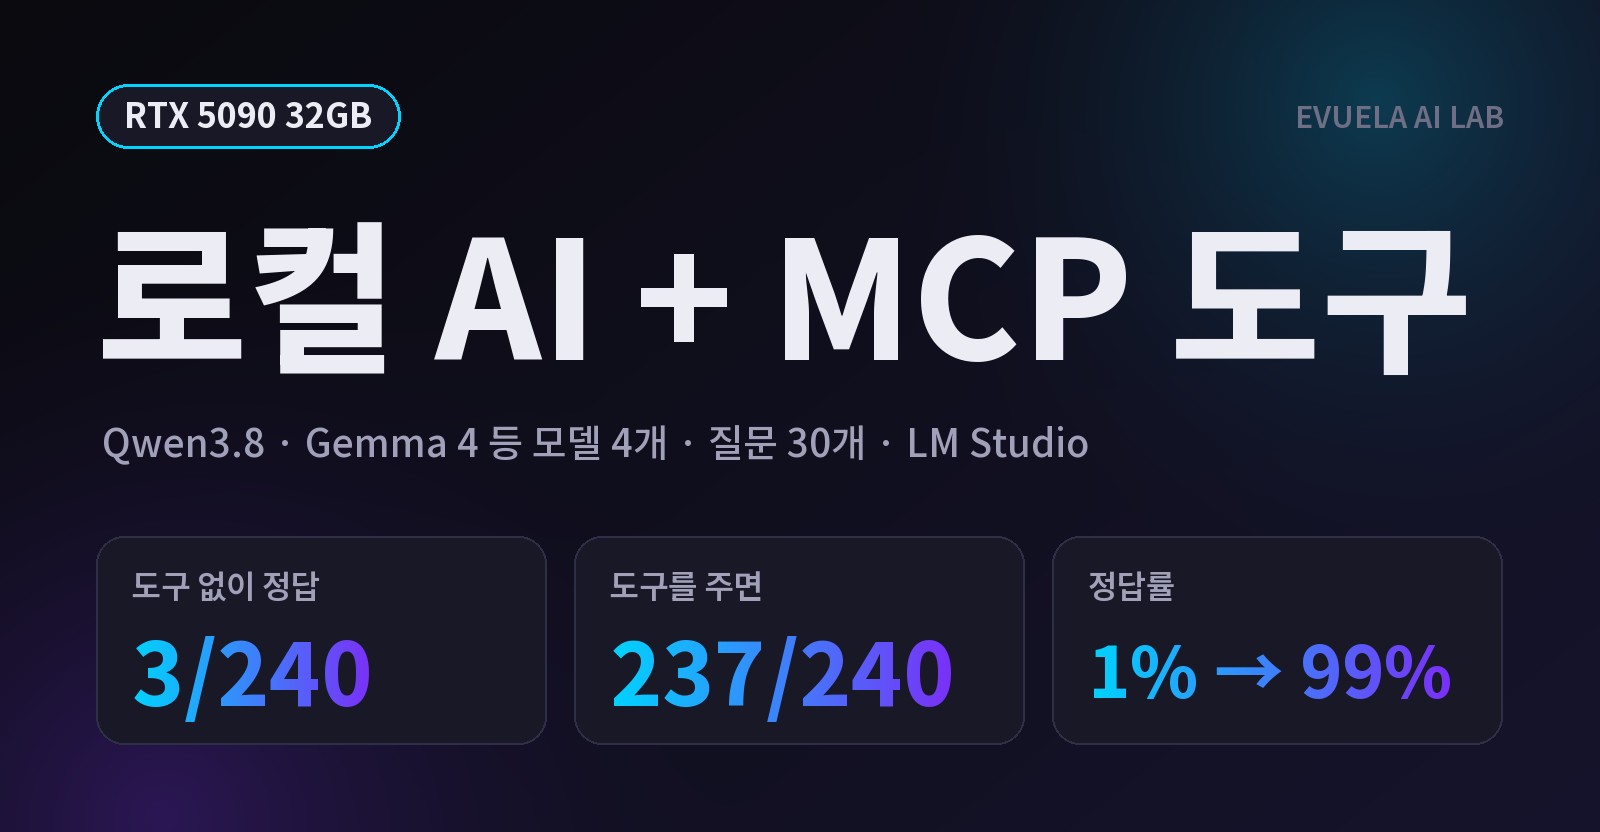
로컬 AI 모델 4개(Qwen3.8 27B, Gemma 4 26B A4B, Gemma 4 31B, Muse Glimmer)에 MCP 도구 3개(웹 페이지 읽기, 현재 시간, 파일 읽기)를 붙이고 같은 질문 30개를 물었습니다. 최신 정보와 파일 질문에서 240번 중 3번이던 정답이 237번이 됐고, 도구가 없을 때는 문서를 읽은 척 틀린 답을 하기도 했습니다. LM Studio 설정 방법과 캡처, 모델별 결과를 정리했습니다.
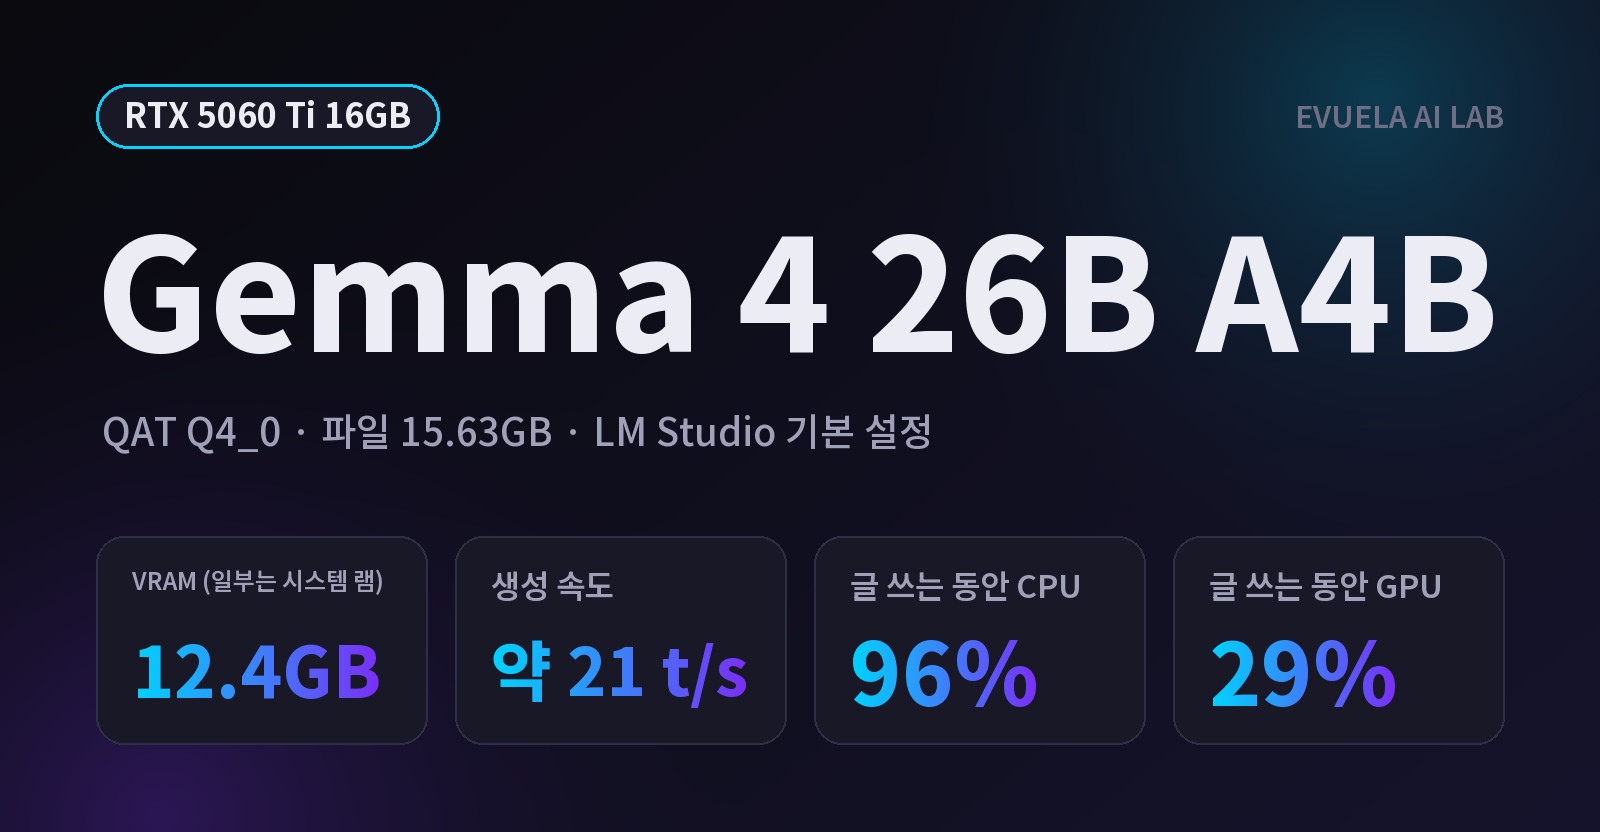
RTX 5060 Ti 16GB PC의 LM Studio에서 Gemma 4 26B A4B QAT(15.63GB)를 기본 설정 그대로 돌려 봤습니다. 모델은 로드됐지만 일부가 시스템 램에 남아, 답을 만드는 동안 CPU는 96%, GPU는 29%였습니다. 생성 속도는 약 21t/s로 같은 PC의 Gemma 4 12B의 절반이었습니다.
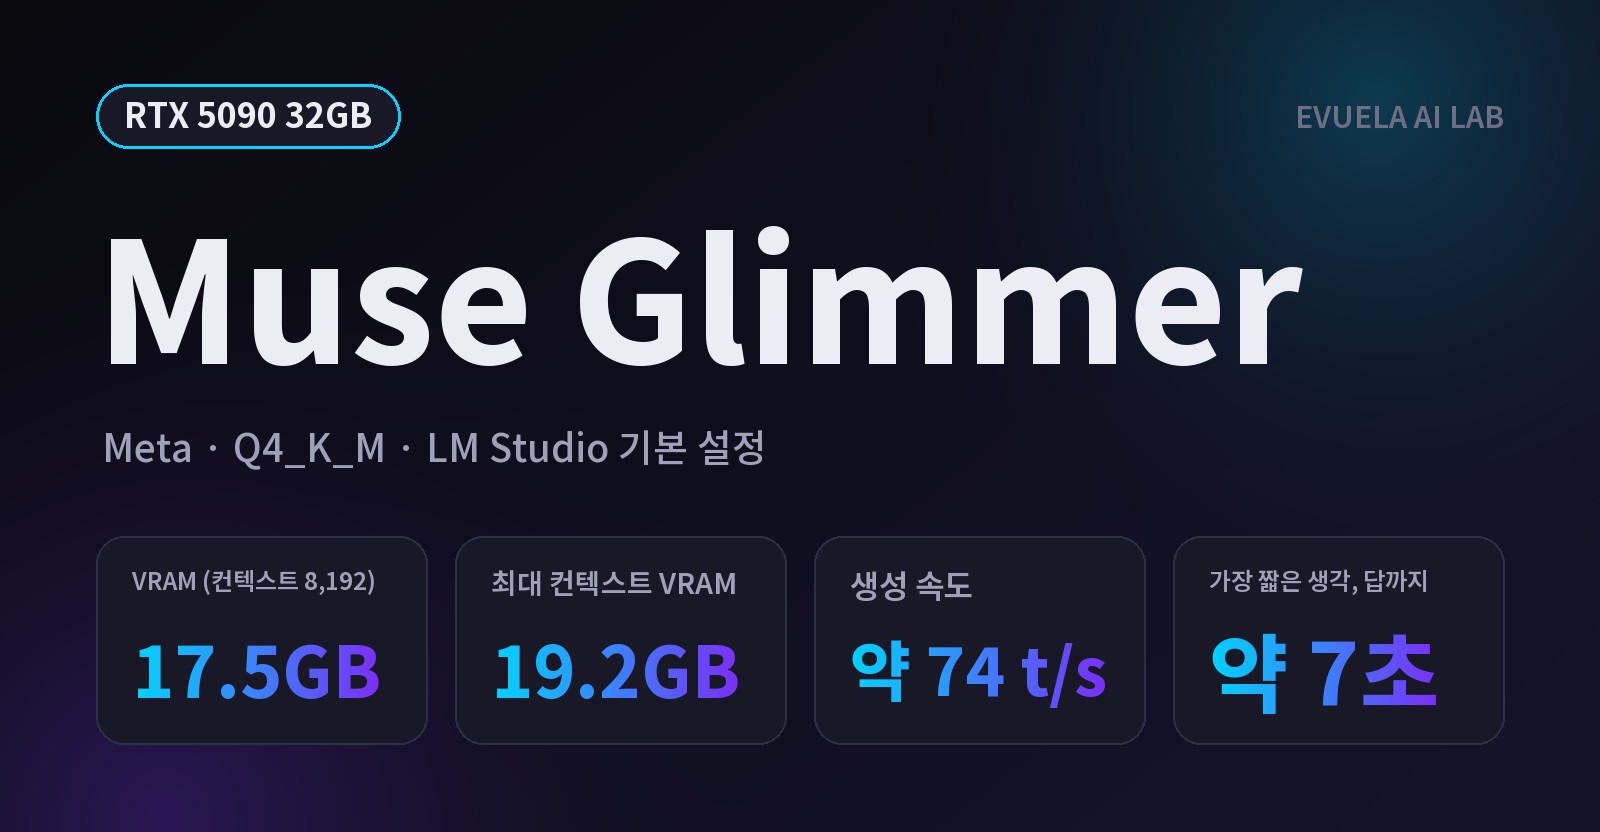
Meta가 공개한 약 300억 파라미터 모델 Muse Glimmer를 RTX 5090의 LM Studio 기본 설정으로 재 봤습니다. 컨텍스트를 16배 늘려도 VRAM은 17.5GB에서 19.2GB로 1.7GB만 늘었고, 기본 설정에서 27번 모두 답했습니다. 속도, 생각 단계, 한국어 품질, 이미지 입력까지 정리했습니다.
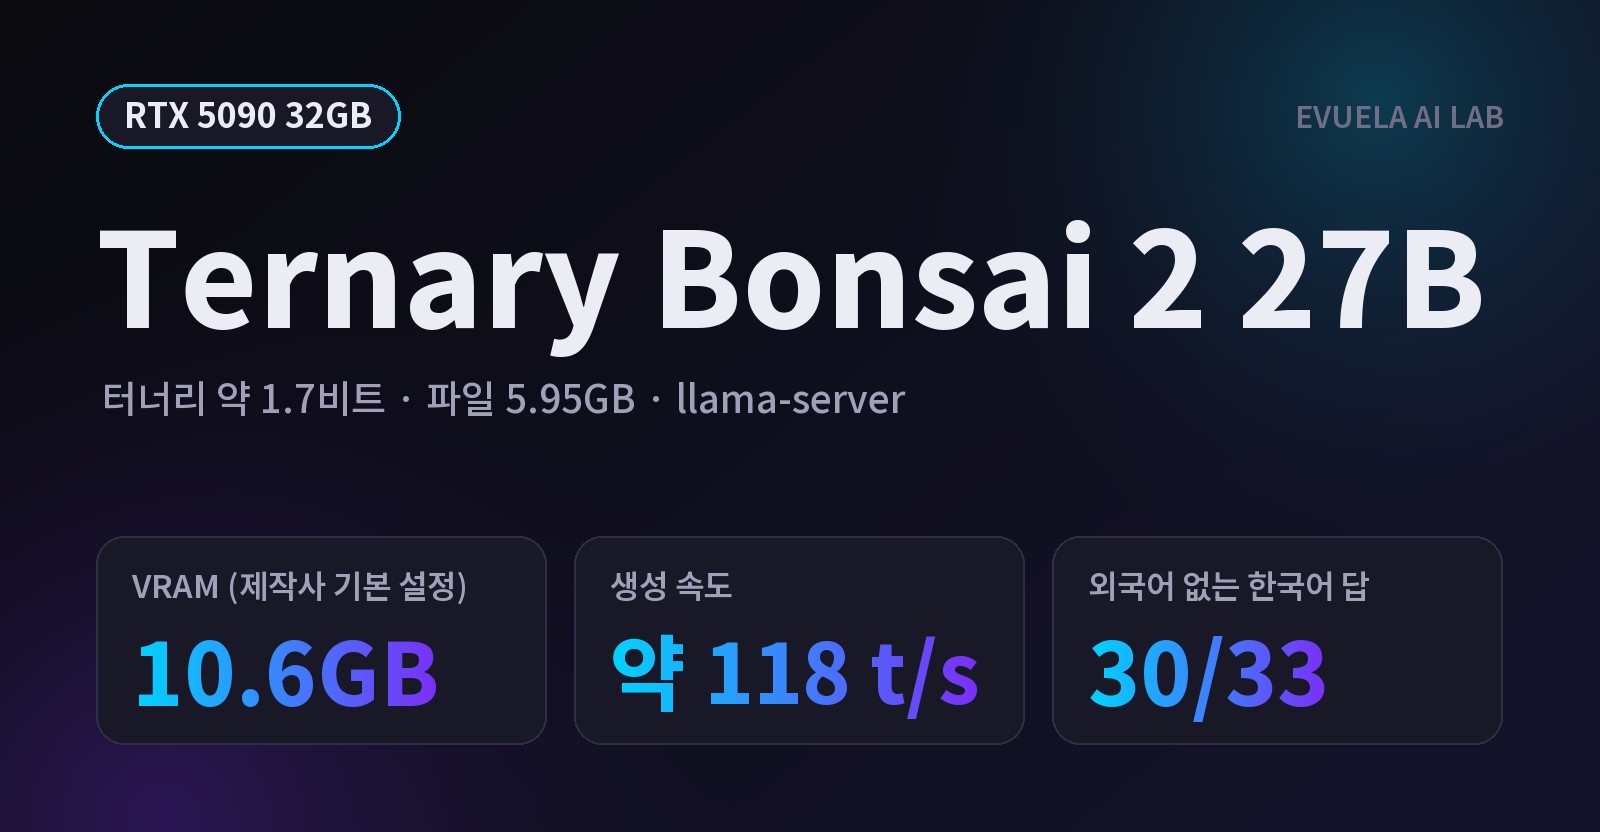
Qwen3.8 27B를 약 1.7비트로 줄인 PrismML Ternary Bonsai 2 27B(5.95GB)를 RTX 5090에서 재 봤습니다. LM Studio로는 아직 열리지 않아 제작사 llama.cpp로 돌렸고, 한국어 답 33개 중 30개에 외국어가 섞이지 않았습니다. VRAM 10.6GB, 약 118 t/s(초당 토큰 수), 생각 단계별 결과를 정리했습니다.
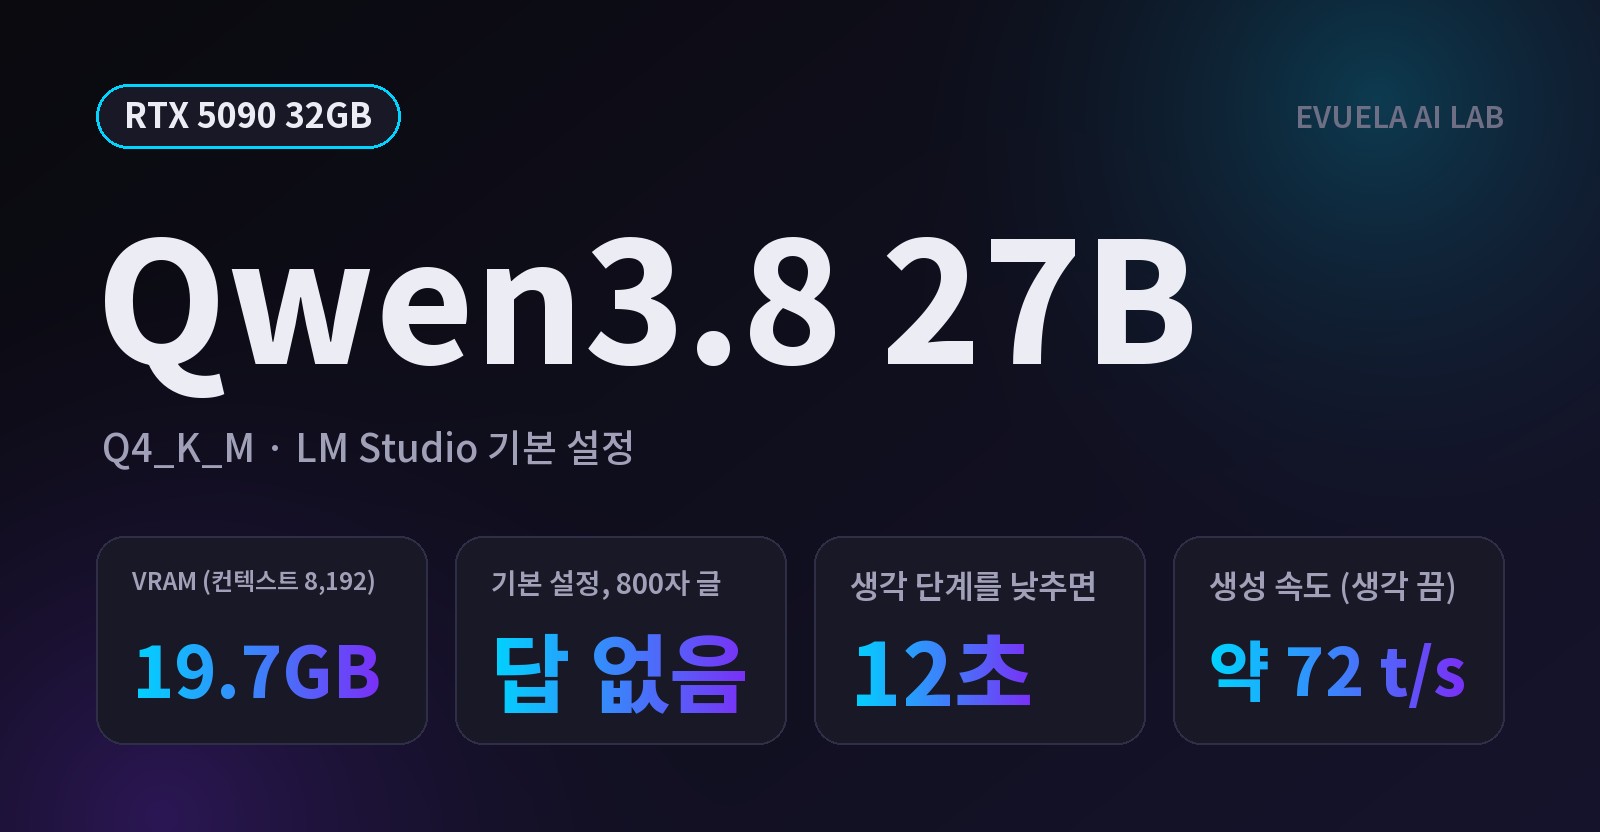
LM Studio 기본 설정으로 Qwen3.8 27B에 800자 글을 부탁하자 1분 넘게 생각만 하다 답 없이 멈췄습니다. 생각 단계를 낮추자 12초 만에 답이 나왔습니다. VRAM 19.7GB, 산수, 없는 소설, 이미지 입력, MTP 속도까지 RTX 5090에서 잰 결과입니다.
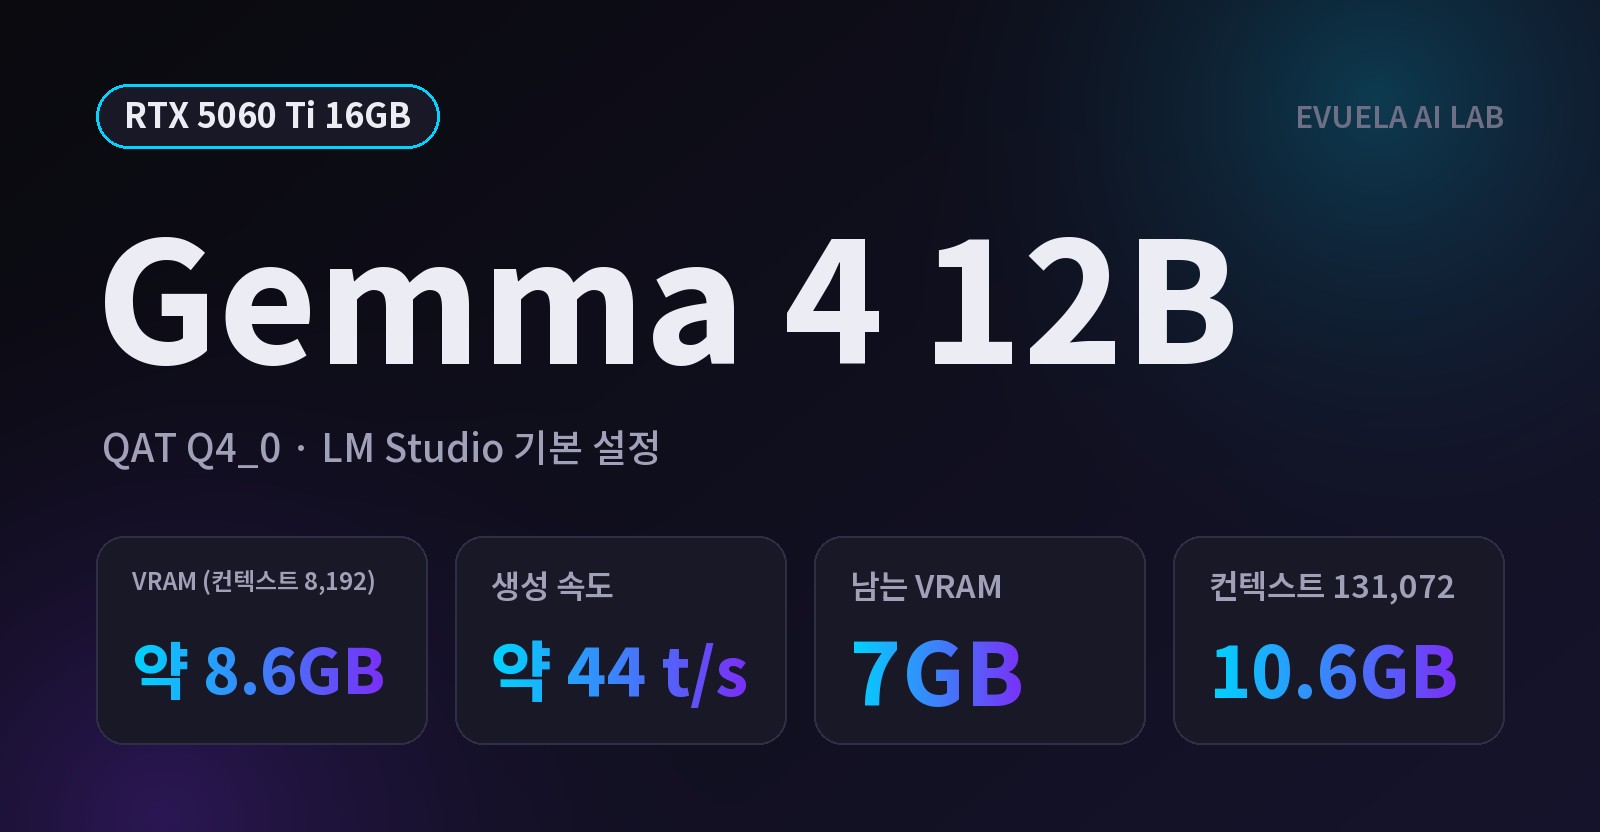
RTX 5060 Ti 16GB PC의 LM Studio에서 Gemma 4 12B QAT를 기본 설정 그대로 돌려 본 실측 기록입니다. 초당 약 44토큰, VRAM 약 8.6GB였고, 생각 기능을 끄면 산수를 5번 모두 틀렸습니다. 같은 방법으로 잰 RTX 5090 결과와 함께 비교합니다.