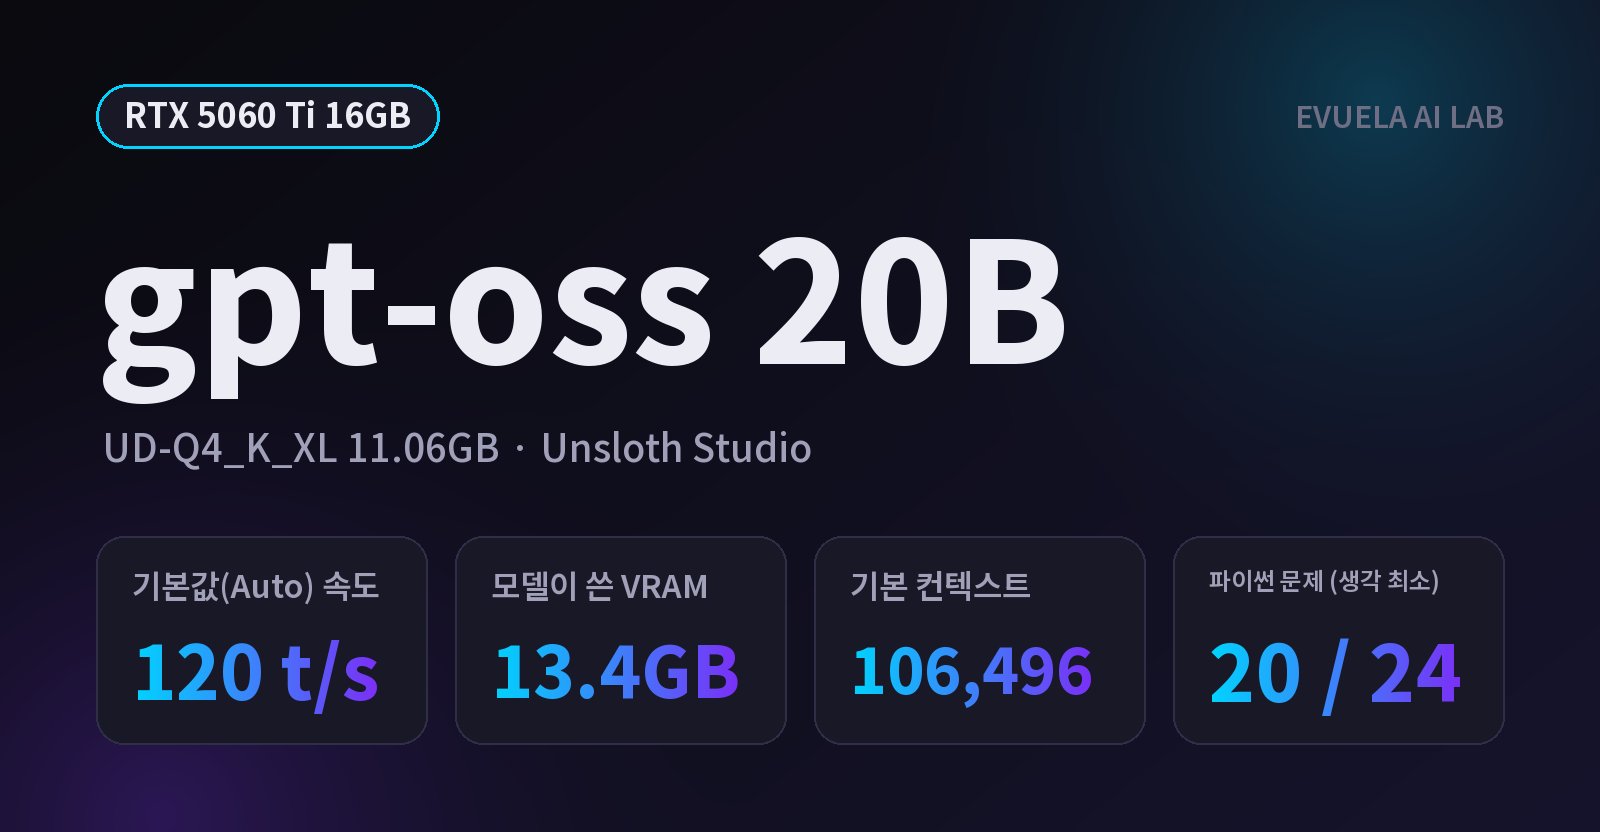
[RTX 5060 Ti 16GB] OpenAI의 gpt-oss 20B를 16GB에서 돌리면, 컨텍스트 10만에서도 초당 120토큰이 나왔다
RTX 5060 Ti 16GB의 Unsloth Studio에서 OpenAI의 gpt-oss 20B(UD-Q4_K_XL 11.06GB)를 기본값으로 돌렸습니다. 초당 약 120토큰, 컨텍스트 65,536까지 같은 속도였고, 생각 단계에 따라 시간과 코딩 결과가 크게 달랐습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Mixture of Experts" 검색 결과 8건
RTX 5060 Ti 16GB의 Unsloth Studio에서 OpenAI의 gpt-oss 20B(UD-Q4_K_XL 11.06GB)를 기본값으로 돌렸습니다. 초당 약 120토큰, 컨텍스트 65,536까지 같은 속도였고, 생각 단계에 따라 시간과 코딩 결과가 크게 달랐습니다.
모델 이름의 12B, A3B, QAT, GGUF, Q4_K_M이 무슨 뜻인지 조각별로 풀었습니다. 같은 Qwen3.8 27B도 4비트 파일은 17.74GB, 2비트 파일은 9.30GB였고, 같은 Q4_K_M도 올린 곳에 따라 16.46GB에서 18.97GB까지 달랐습니다.
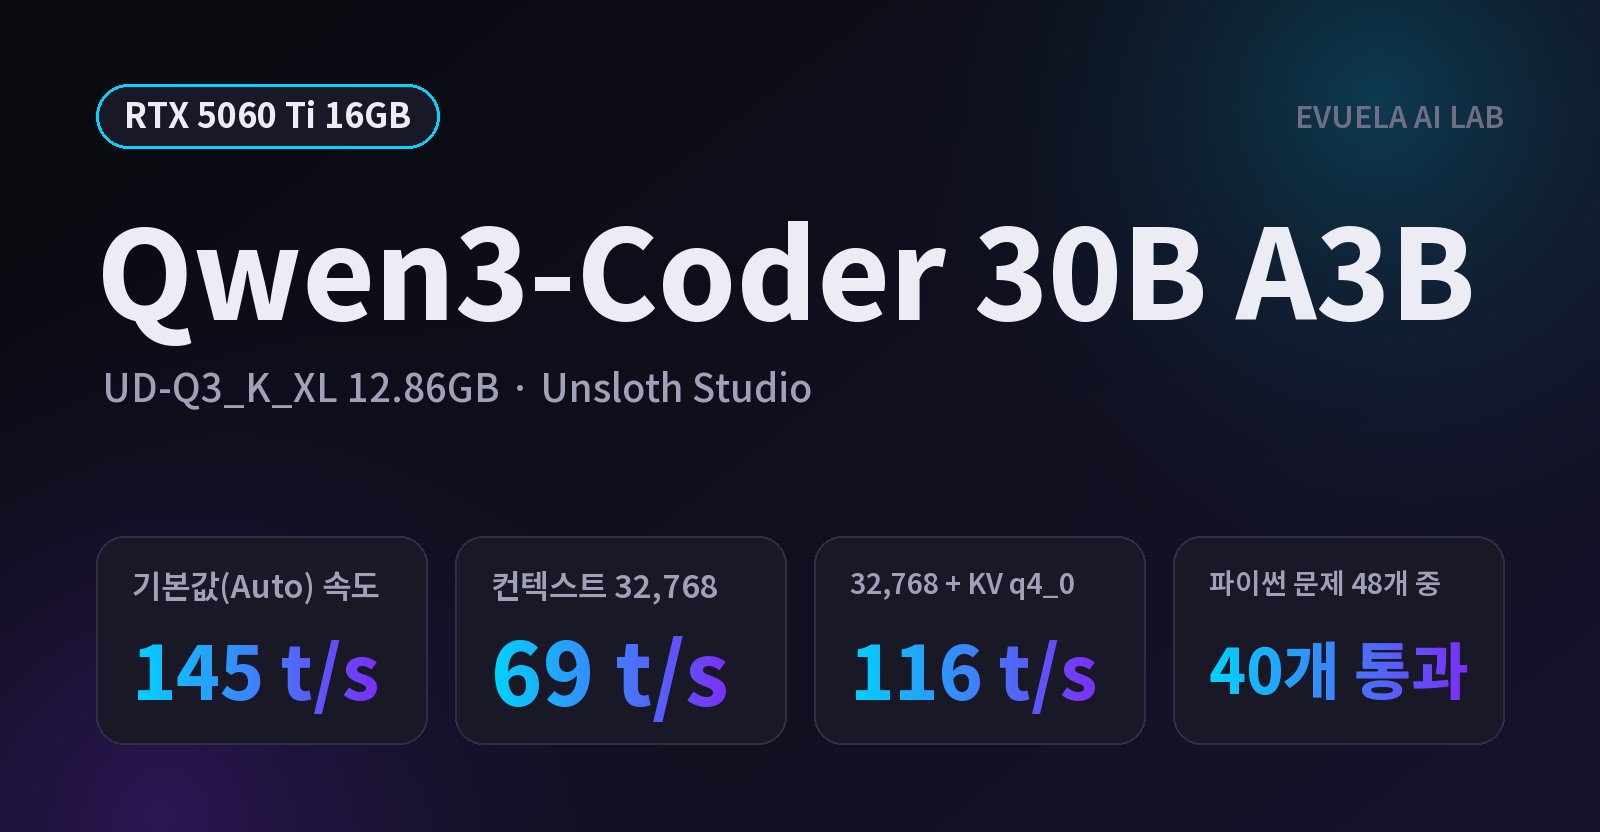
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
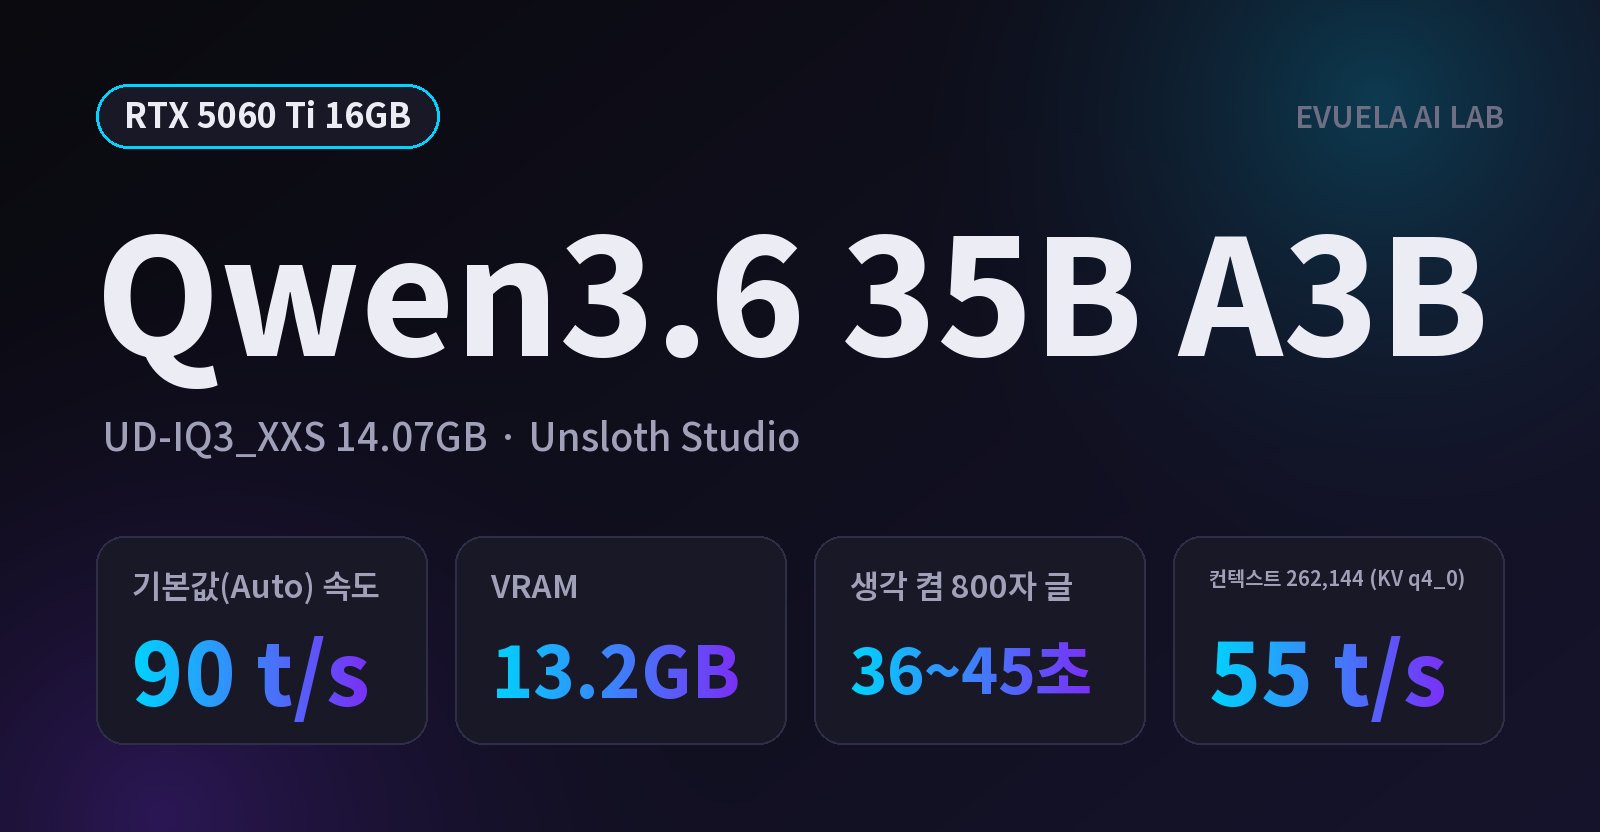
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3.6 35B A3B(UD-IQ3_XXS)를 기본값으로 돌렸습니다. VRAM 13.2GB에 다 들어갔고 초당 약 90토큰이었습니다. 컨텍스트별 속도, 설정 비교, Gemma 4 26B와의 비교를 담았습니다.
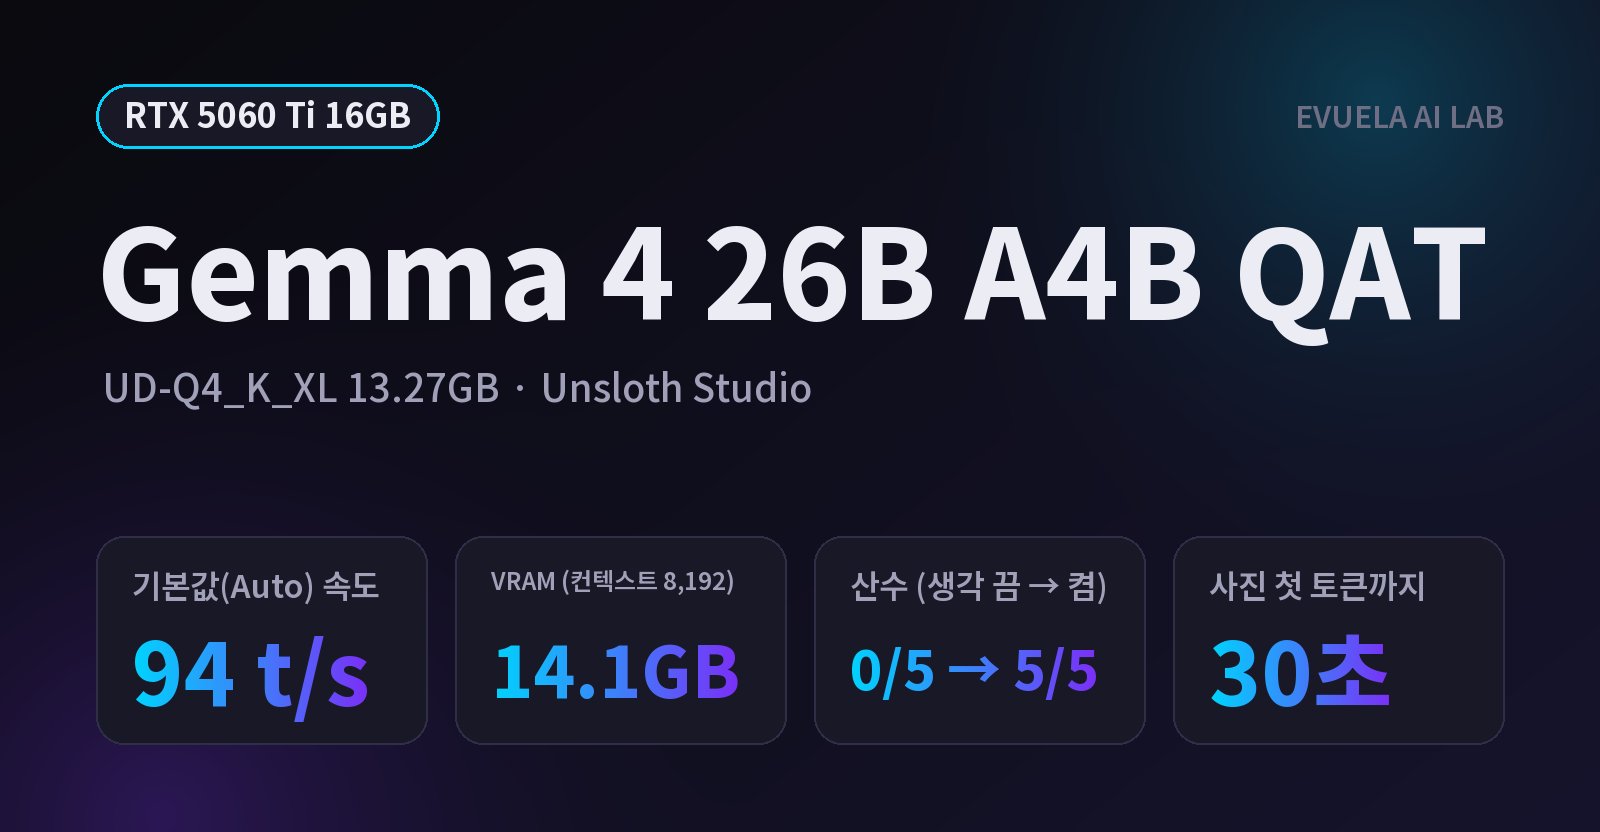
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
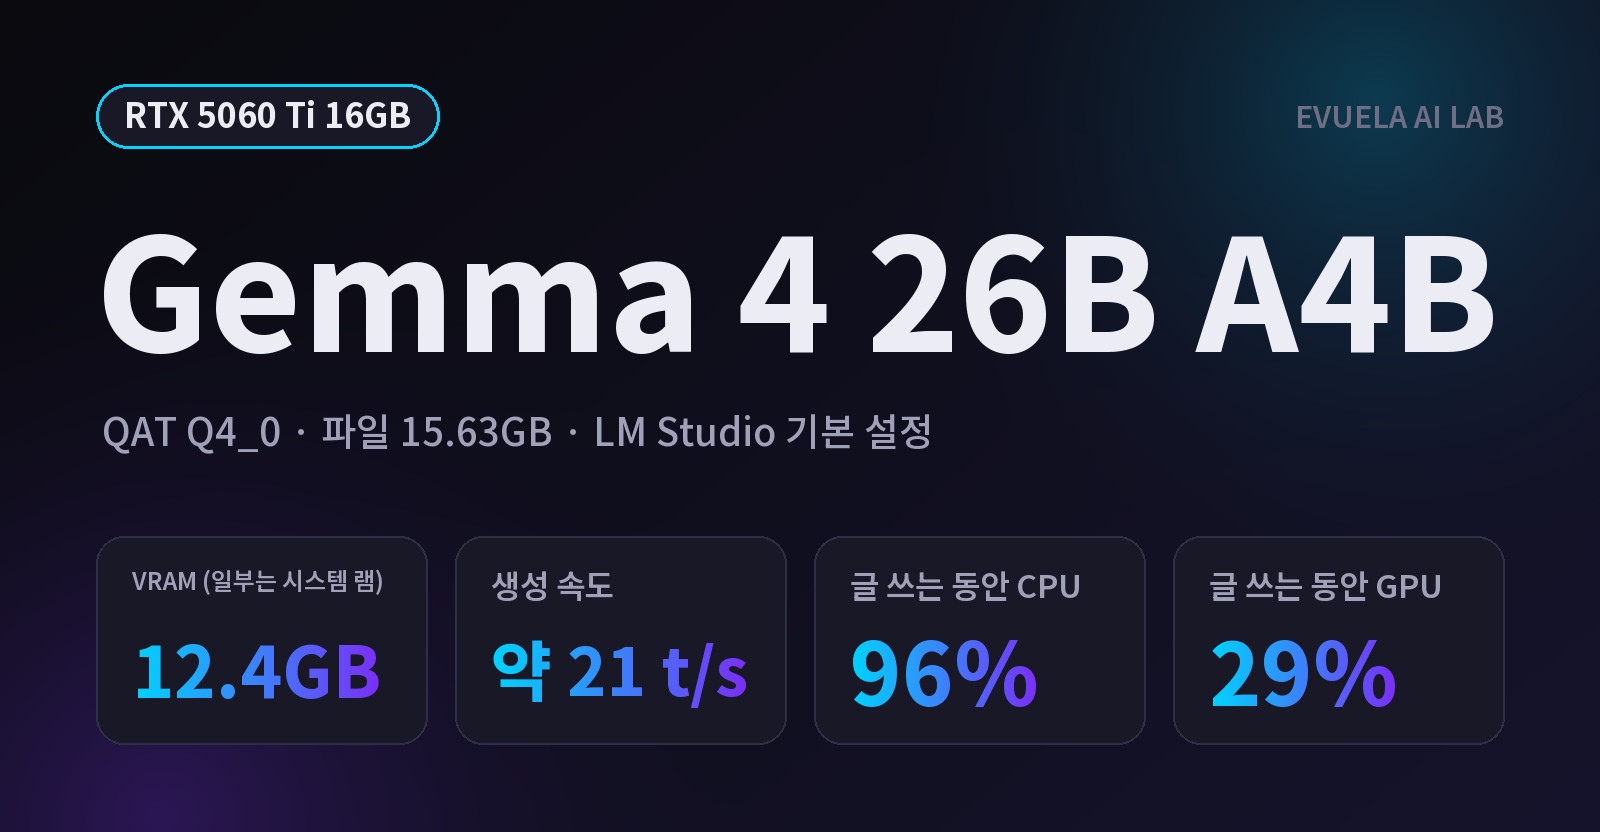
RTX 5060 Ti 16GB PC의 LM Studio에서 Gemma 4 26B A4B QAT(15.63GB)를 기본 설정 그대로 돌려 봤습니다. 모델은 로드됐지만 일부가 시스템 램에 남아, 답을 만드는 동안 CPU는 96%, GPU는 29%였습니다. 생성 속도는 약 21t/s로 같은 PC의 Gemma 4 12B의 절반이었습니다.
2026년 8월 출시된 Qwen3.8-27B는 270억 파라미터의 개방형 멀티모달 모델로, Apache 2.0 라이선스 기반의 강력한 에이전트 코딩 및 실무 작업 성능을 제공한다. 로컬 LLM 환경에서의 VRAM 요구사항과 실무 적용 가능성을 깊이 있게 분석한다.
Dense 모델과 Mixture of Experts (MoE) 모델의 차이점을 파악하고, LLM 아키텍처가 실무에 미치는 영향을 기술적 관점에서 분석합니다. 로컬 AI, SI 환경에서의 활용 전략을 다룹니다.