[RTX 5090] VRAM 5.5GB 로컬 AI 에이전트는 어디까지 될까, LFM3-1.7B + Hermes Agent 한국어 과제 33번 중 28번 성공
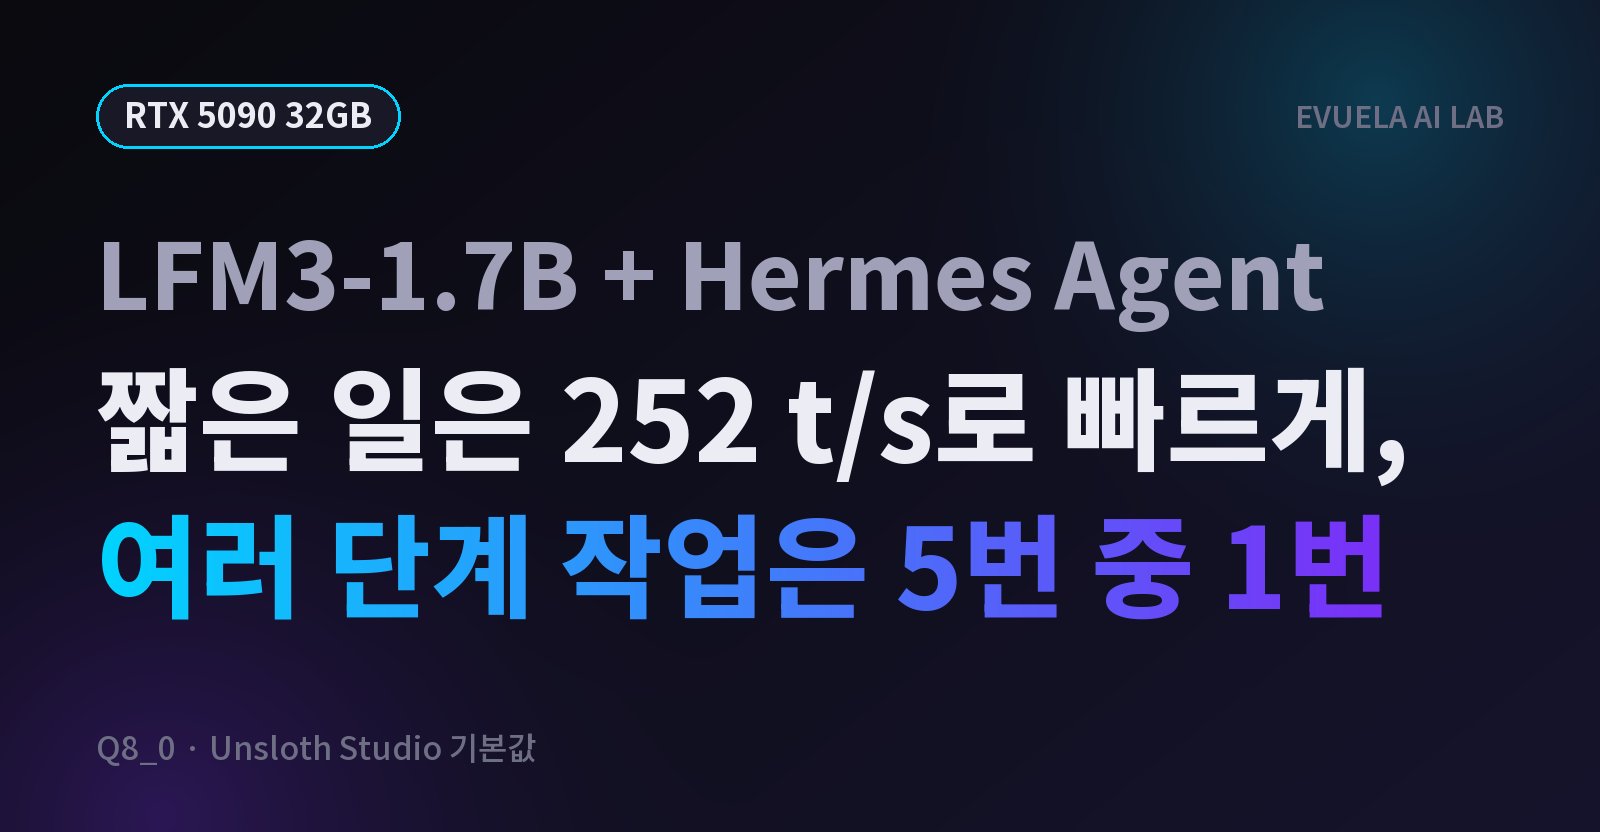
에이전트용 1.7B 모델 LFM3-1.7B를 Hermes Agent에 붙여 RTX 5090에서 과제 7가지를 시켰습니다. 33번 중 28번 성공, VRAM 5.5GB, 초당 252토큰. 짧은 일은 Qwen3.8 27B보다 빨랐지만 여러 단계 작업은 5번 중 1번만 성공했습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"ggml-org" 검색 결과 6건
에이전트용 1.7B 모델 LFM3-1.7B를 Hermes Agent에 붙여 RTX 5090에서 과제 7가지를 시켰습니다. 33번 중 28번 성공, VRAM 5.5GB, 초당 252토큰. 짧은 일은 Qwen3.8 27B보다 빨랐지만 여러 단계 작업은 5번 중 1번만 성공했습니다.
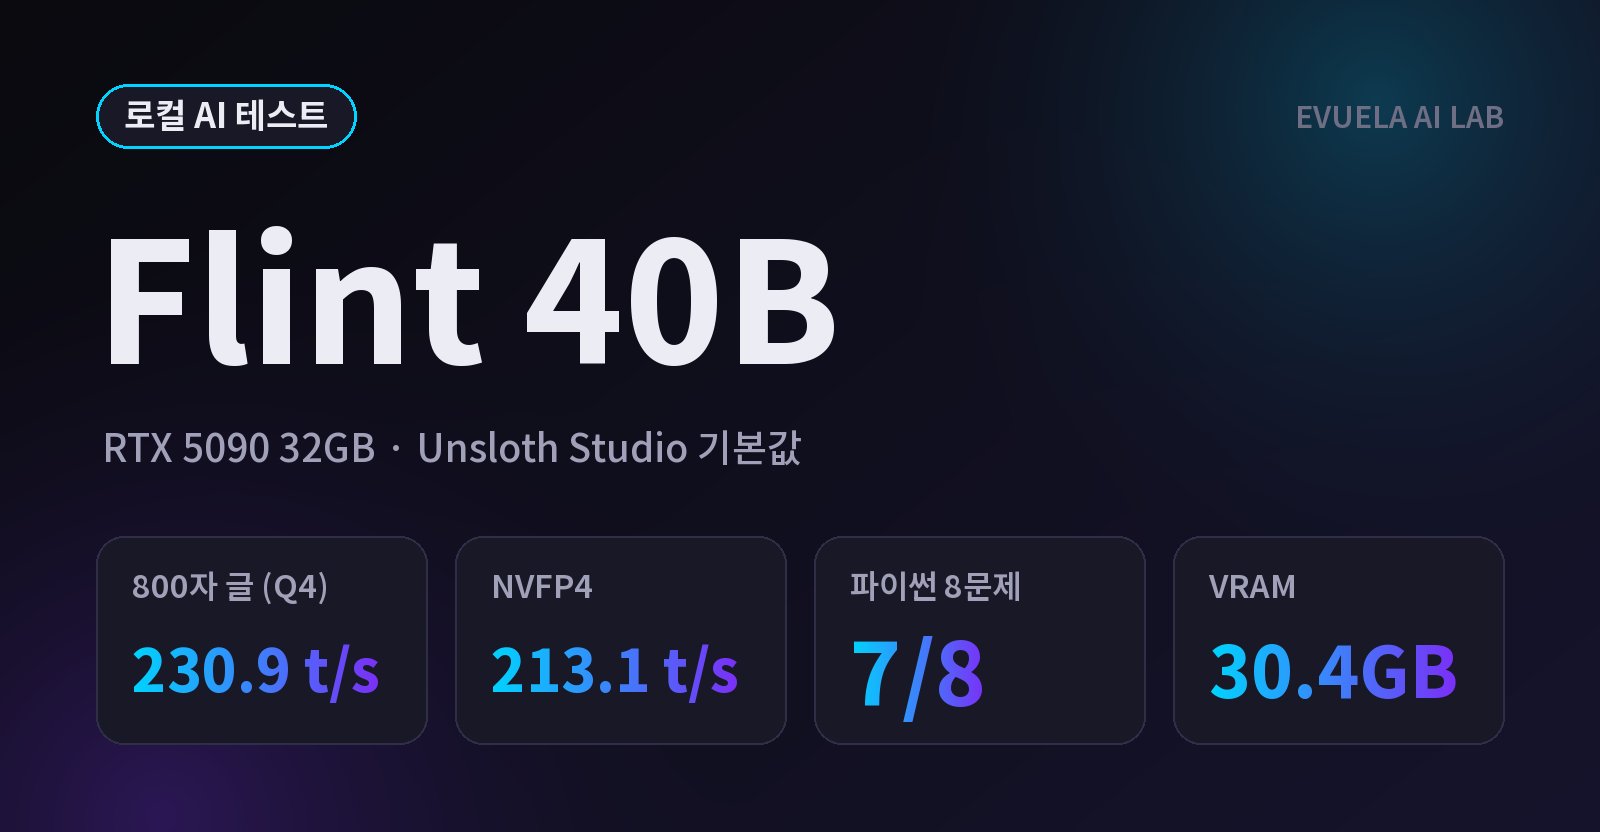
Recursive SI의 공개 코딩 모델 Flint 40B를 RTX 5090 32GB의 Unsloth Studio에서 Q4와 공식 NVFP4로 쟀습니다. 초당 230.9토큰, VRAM 30.4GB, 파이썬 8문제 중 7문제를 풀었고, 생각은 끌 수 없었으며 37만 8천 원을 3만 7,800원으로 읽었습니다.
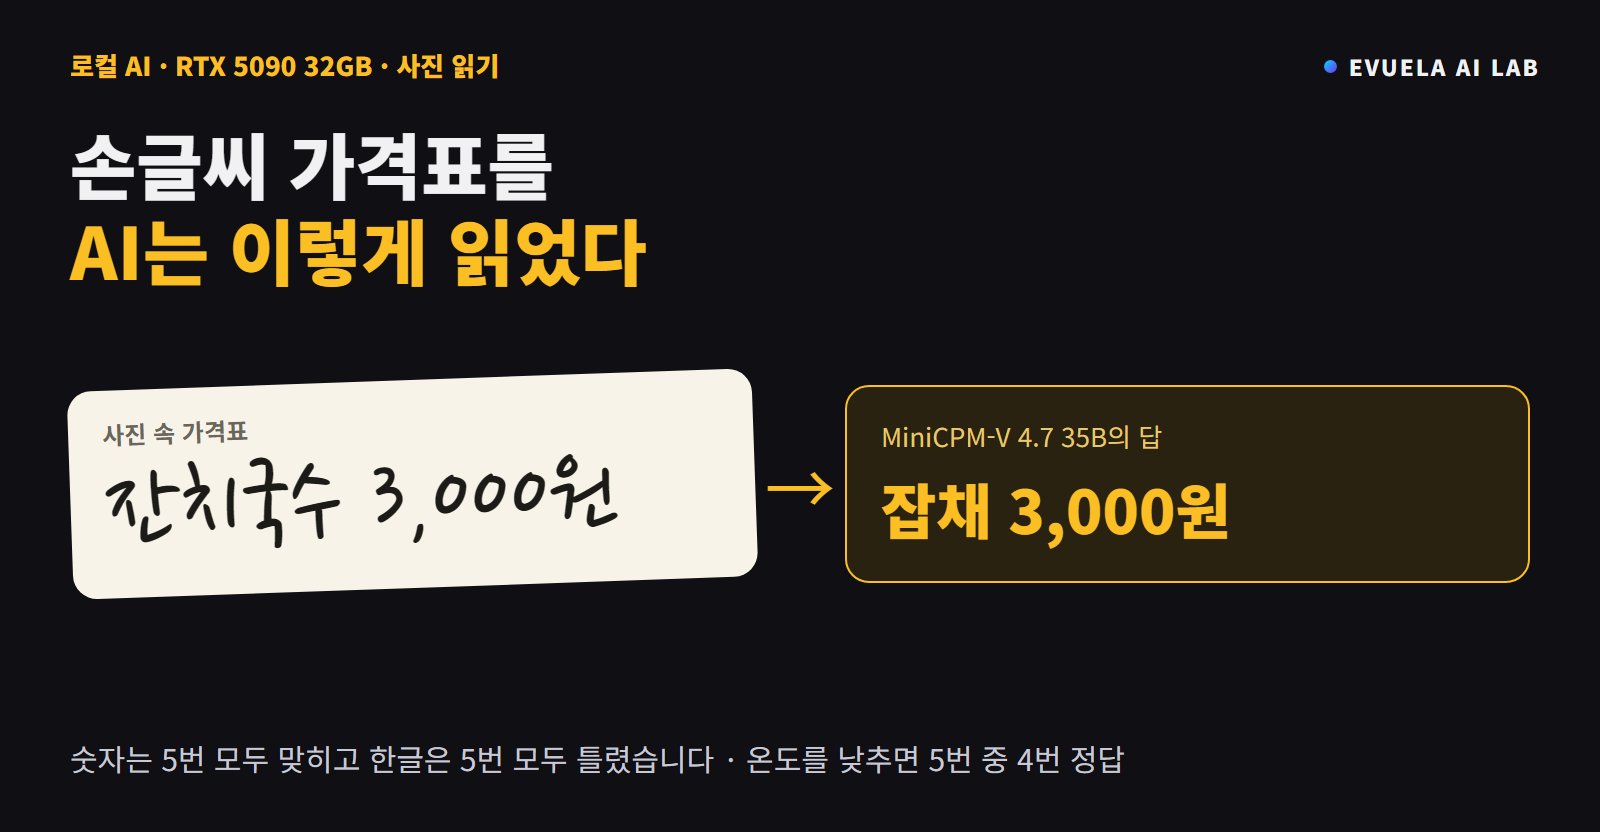
사진과 영상을 읽는 공개 모델 MiniCPM-V 4.7 35B A3B를 RTX 5090에서 쟀습니다. 속도는 초당 269토큰, 표와 화면 캡처는 70번 중 65번, Pixabay 실제 사진은 55번 중 29번 맞혔습니다. Unsloth Studio에서 사진이 안 된 이유와 한글 간판을 틀린 모습, 나아지는 설정도 적었습니다.
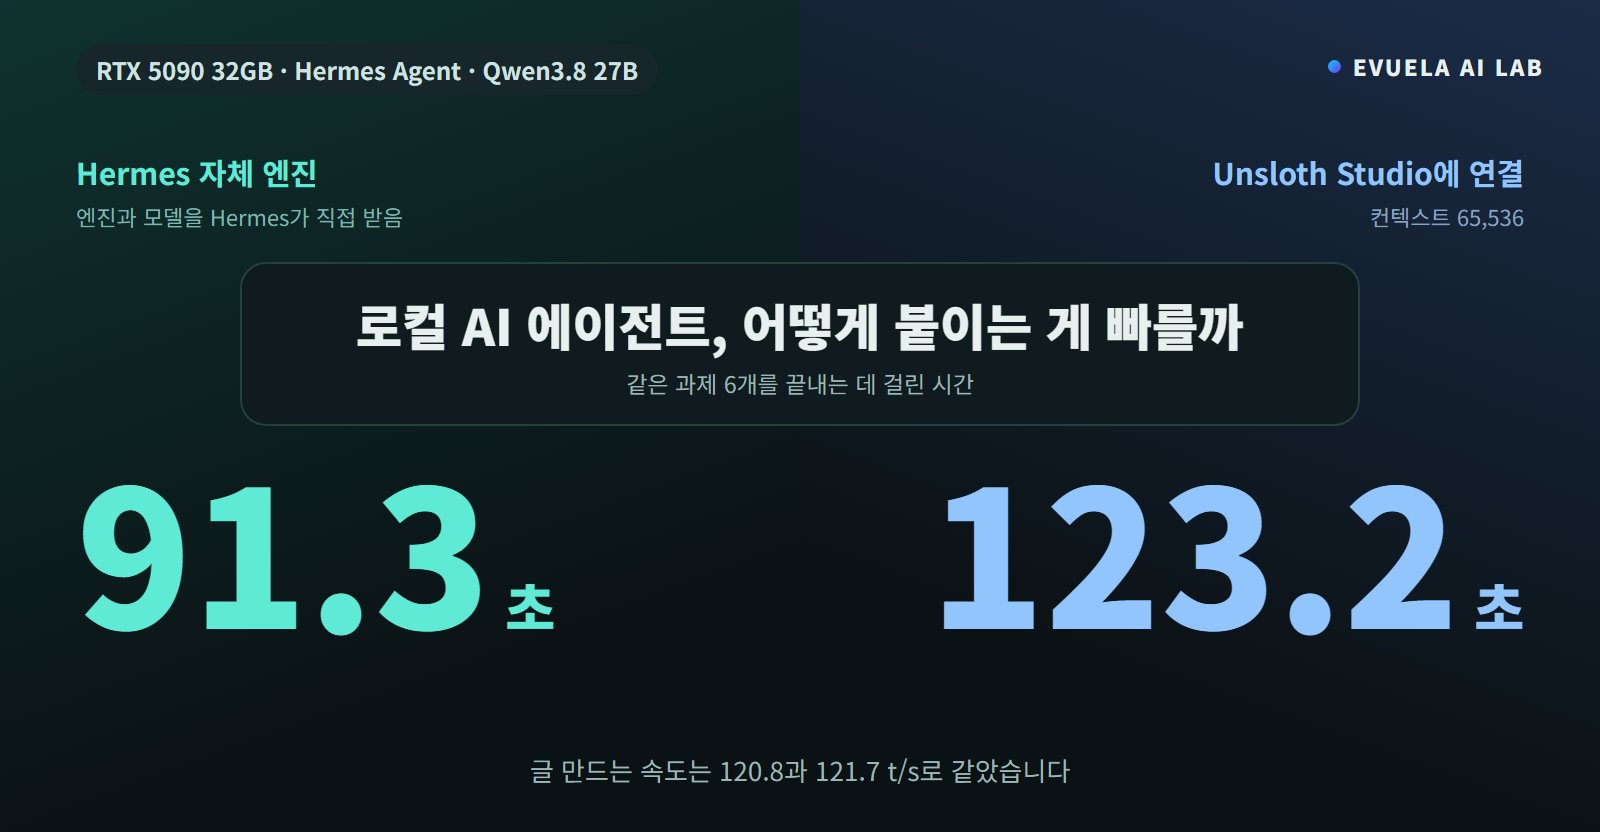
Hermes Agent를 로컬 모델에 붙이는 두 방식을 RTX 5090에서 Qwen3.8 27B로 비교했습니다. 글 만드는 속도는 120.8과 121.7 t/s로 같았지만 과제 6개는 91.3초와 123.2초였습니다. 차이는 프롬프트를 다시 읽는 양에서 났습니다.
모델 이름의 12B, A3B, QAT, GGUF, Q4_K_M이 무슨 뜻인지 조각별로 풀었습니다. 같은 Qwen3.8 27B도 4비트 파일은 17.74GB, 2비트 파일은 9.30GB였고, 같은 Q4_K_M도 올린 곳에 따라 16.46GB에서 18.97GB까지 달랐습니다.
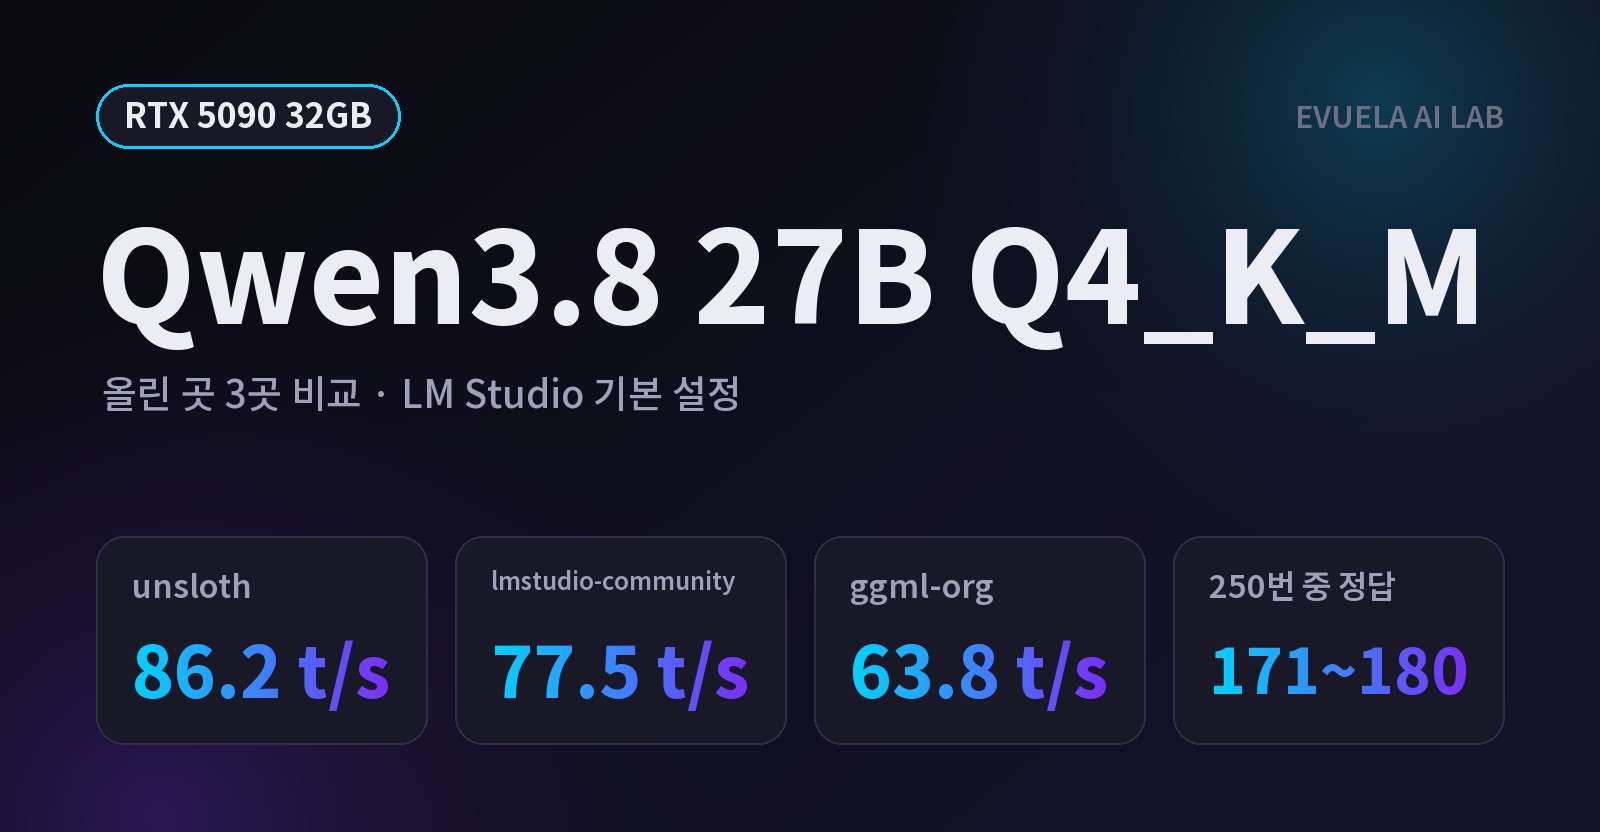
Qwen3.8 27B Q4_K_M 파일을 lmstudio-community, unsloth, ggml-org 세 곳에서 받아 RTX 5090과 LM Studio로 비교했습니다. 채점 질문 250번 중 171~180번을 맞혀 정답률은 거의 같았고, 생성 속도는 초당 63.8~86.2토큰으로 달랐습니다. 차이는 파일 안에 MTP 레이어가 있느냐에서 나왔습니다. 파일 속 양자화 구성, VRAM, MCP 도구 호출 결과와 LM Studio 캡처를 함께 정리했습니다.