[RTX 5090 32GB] 로컬 AI 에이전트 Hermes Agent, Qwen3.8 27B는 직접 받는 쪽과 Unsloth 연결 중 무엇이 빠를까, 속도는 같았는데 끝나는 시간은 91초와 123초였다 RTX 5090 32GB

[RTX 5090 32GB] 로컬 AI 에이전트 Hermes Agent, Qwen3.8 27B는 직접 받는 쪽과 Unsloth 연결 중 무엇이 빠를까, 속도는 같았는데 끝나는 시간은 91초와 123초였다

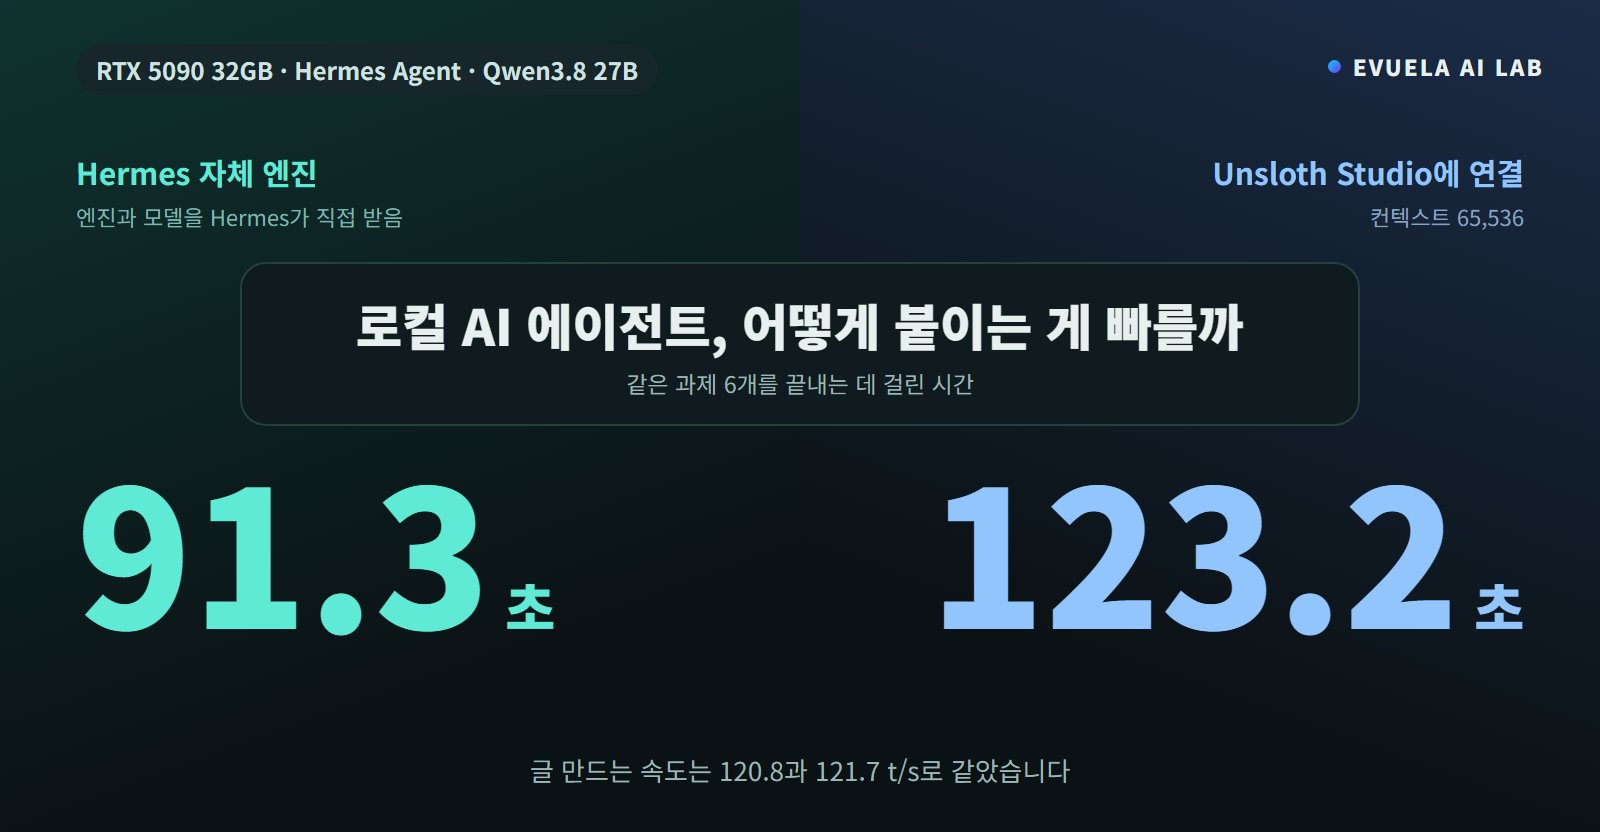
Hermes Agent를 로컬 모델에 붙이는 두 방식을 RTX 5090에서 Qwen3.8 27B로 비교했습니다. 글 만드는 속도는 120.8과 121.7 t/s로 같았지만 과제 6개는 91.3초와 123.2초였습니다. 차이는 프롬프트를 다시 읽는 양에서 났습니다.

2026.10.09 104
[RTX 5090 32GB] 로컬 AI 임베딩 모델 EmbeddingGemma 2 한국어 검색, 다르게 물으면 낱말 검색의 두 배를 찾았고 VRAM은 0.5GB였다 RTX 5090 32GB

[RTX 5090 32GB] 로컬 AI 임베딩 모델 EmbeddingGemma 2 한국어 검색, 다르게 물으면 낱말 검색의 두 배를 찾았고 VRAM은 0.5GB였다

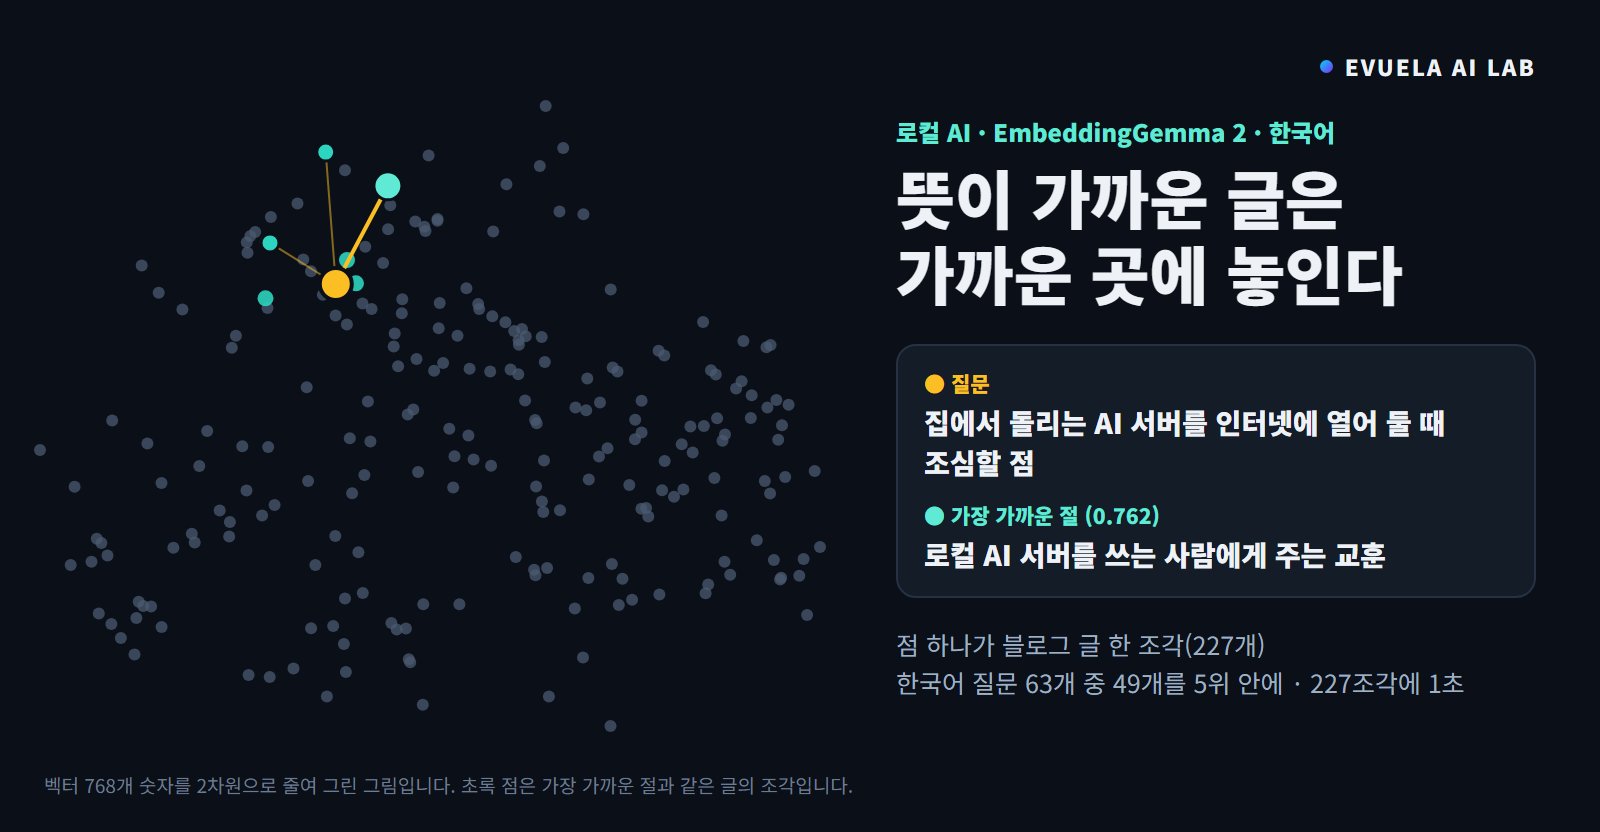
구글 EmbeddingGemma 2로 이 블로그 글 227조각을 한국어 질문 63개로 검색했습니다. 다른 낱말로 바꿔 물은 질문은 17개를 1위로 찾아 낱말 검색(9개)의 약 두 배였고, 영어로 물어도 34개를 찾았습니다. 227조각을 벡터로 바꾸는 데 1.06초, VRAM은 0.5GB였습니다.

2026.10.07 54