 AI 뉴스
Claude Code가 내 이메일을 웹사이트에 보냈을까, 기록 8만 번을 뒤지고 120번 시켜 보니 3번 넣었다
Claude Code가 curl 명령의 User-Agent에 계정 이메일을 넣었다는 신고가 나왔습니다. 원인과 2.1.317 보호 모드가 못 막는 것을 정리하고, 내 PC 기록 81,195번을 점검한 뒤 실행을 막은 채 120번 재현해 봤습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"도구 호출" 검색 결과 20건
AI 뉴스
Claude Code가 curl 명령의 User-Agent에 계정 이메일을 넣었다는 신고가 나왔습니다. 원인과 2.1.317 보호 모드가 못 막는 것을 정리하고, 내 PC 기록 81,195번을 점검한 뒤 실행을 막은 채 120번 재현해 봤습니다.
 RTX 5090 32GB
에이전트용 1.7B 모델 LFM3-1.7B를 Hermes Agent에 붙여 RTX 5090에서 과제 7가지를 시켰습니다. 33번 중 28번 성공, VRAM 5.5GB, 초당 252토큰. 짧은 일은 Qwen3.8 27B보다 빨랐지만 여러 단계 작업은 5번 중 1번만 성공했습니다.
 RTX 5090 32GB
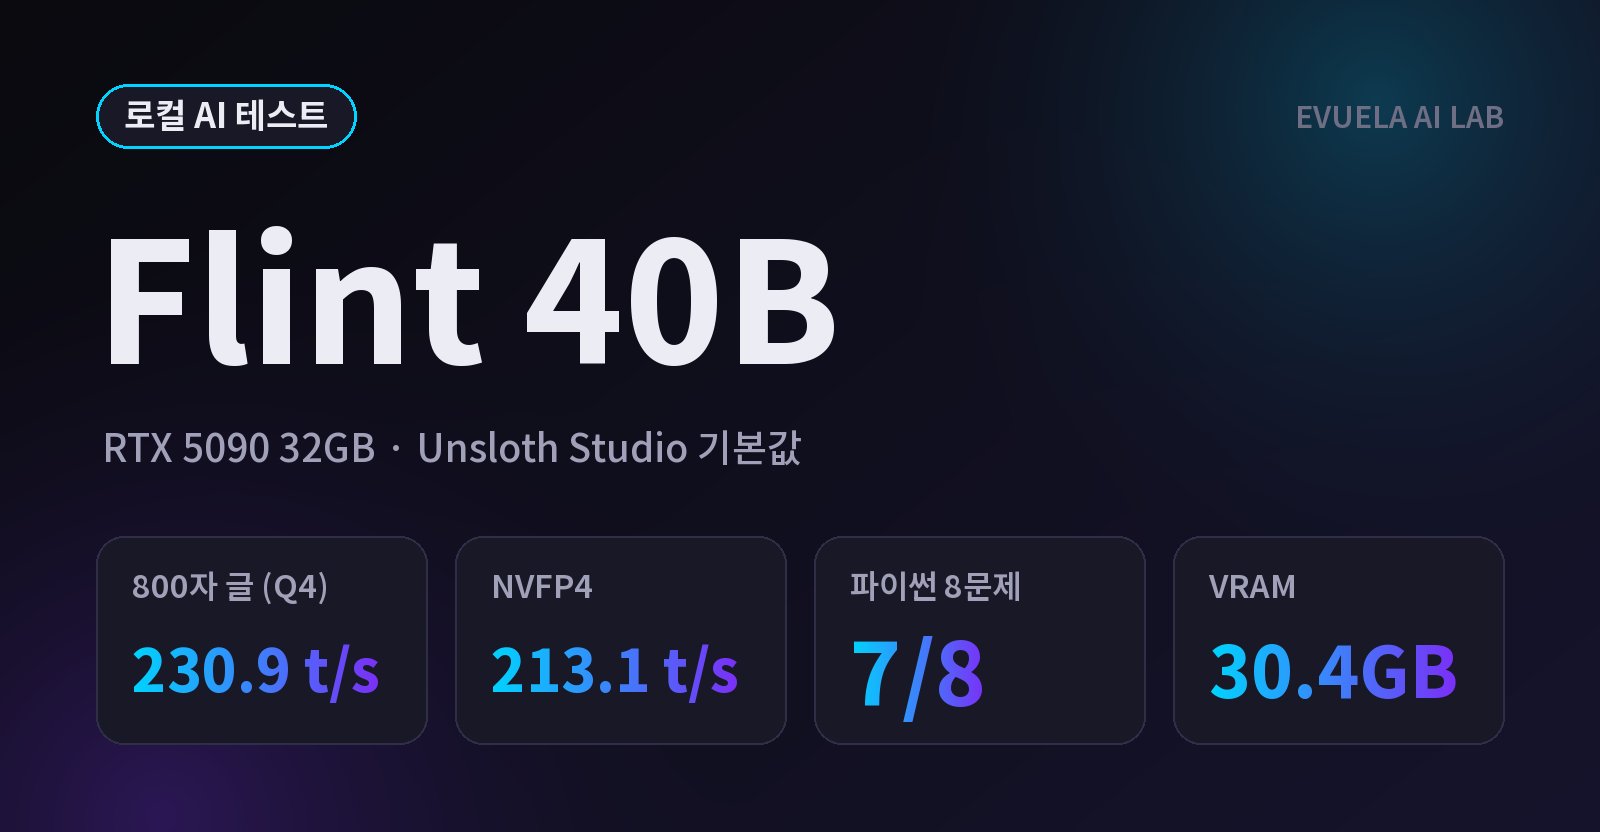
Recursive SI의 공개 코딩 모델 Flint 40B를 RTX 5090 32GB의 Unsloth Studio에서 Q4와 공식 NVFP4로 쟀습니다. 초당 230.9토큰, VRAM 30.4GB, 파이썬 8문제 중 7문제를 풀었고, 생각은 끌 수 없었으며 37만 8천 원을 3만 7,800원으로 읽었습니다.
 RTX 5060 Ti 16GB
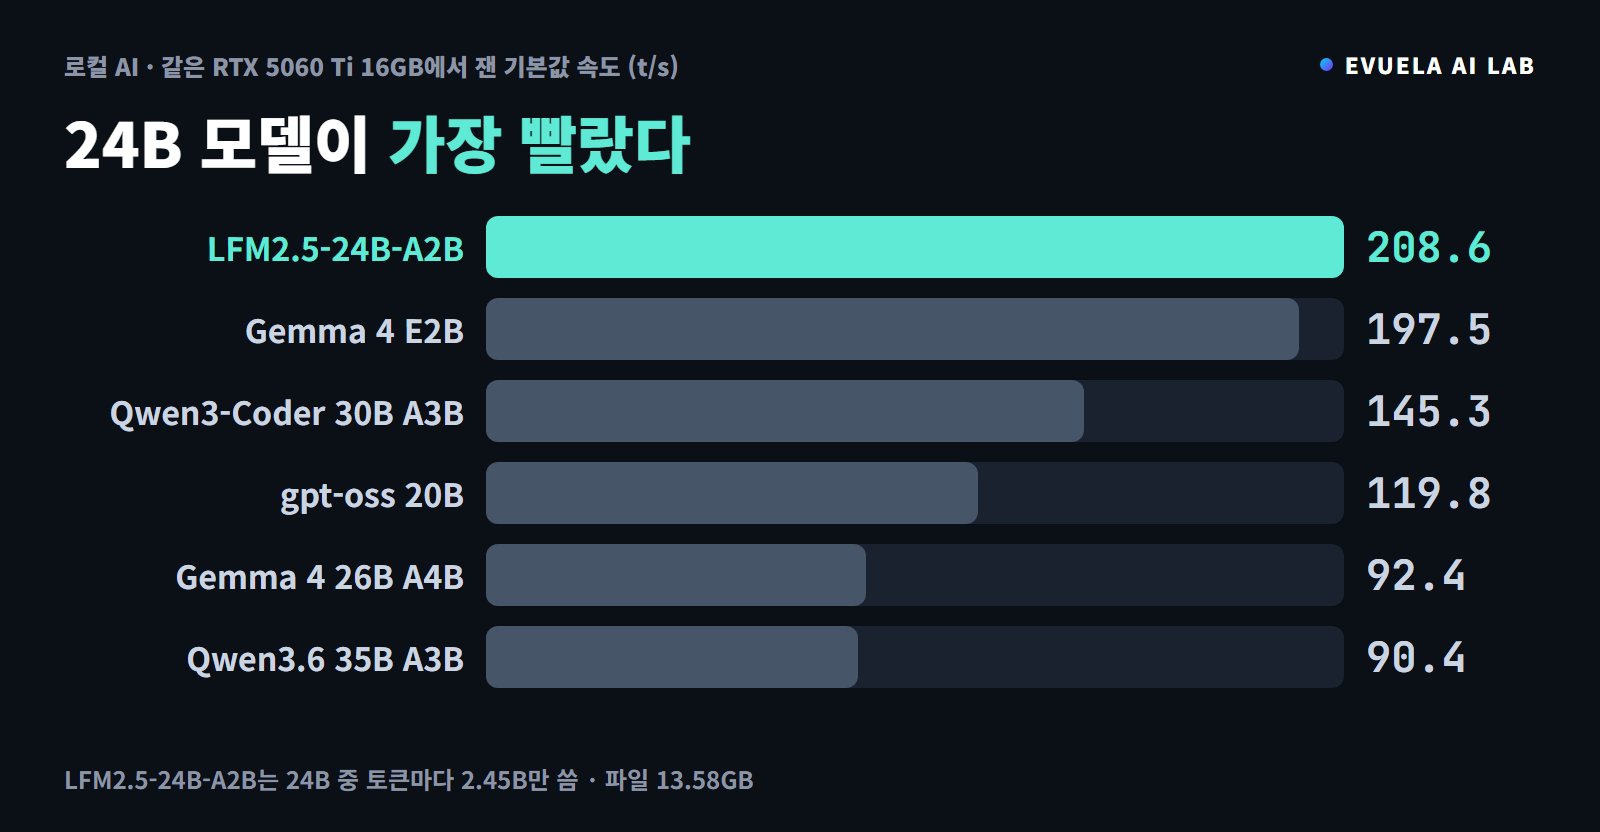
24B 중 토큰마다 2.45B만 쓰는 Liquid AI의 LFM2.5-24B-A2B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 208.6토큰으로 이 PC에서 가장 빨랐고, 100,000자 요약은 20.7초, 생각은 끌 수 없었습니다.
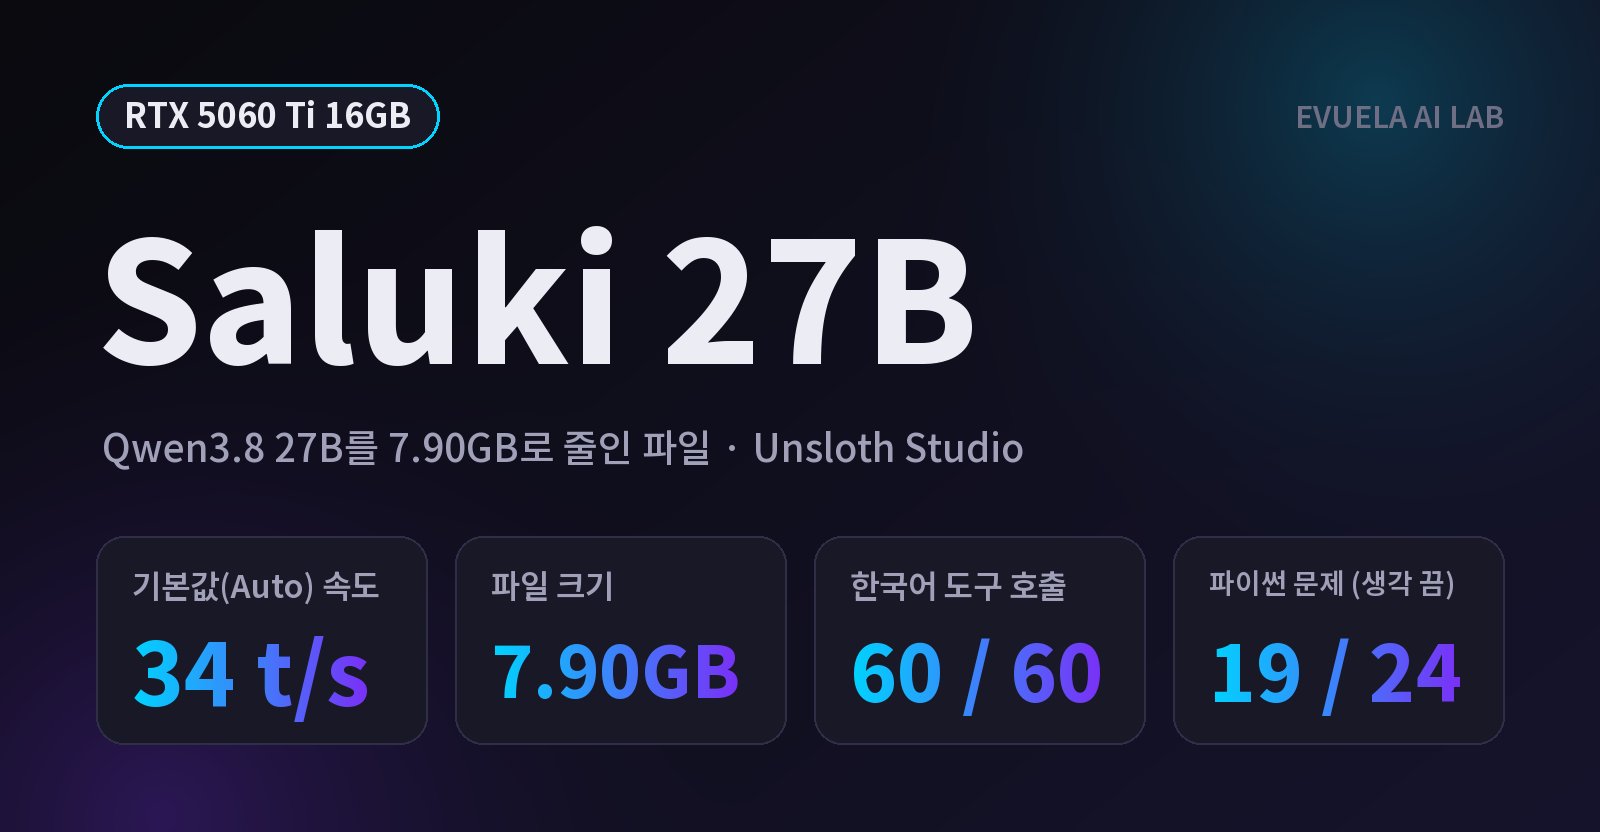 RTX 5060 Ti 16GB
Qwen3.8 27B를 7.90GB로 줄인 Saluki 27B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 34토큰, 한국어 도구 호출 60번 모두 정답이었고, 생각 단계를 정하지 않으면 15번 중 6번은 답이 나오지 않았습니다.
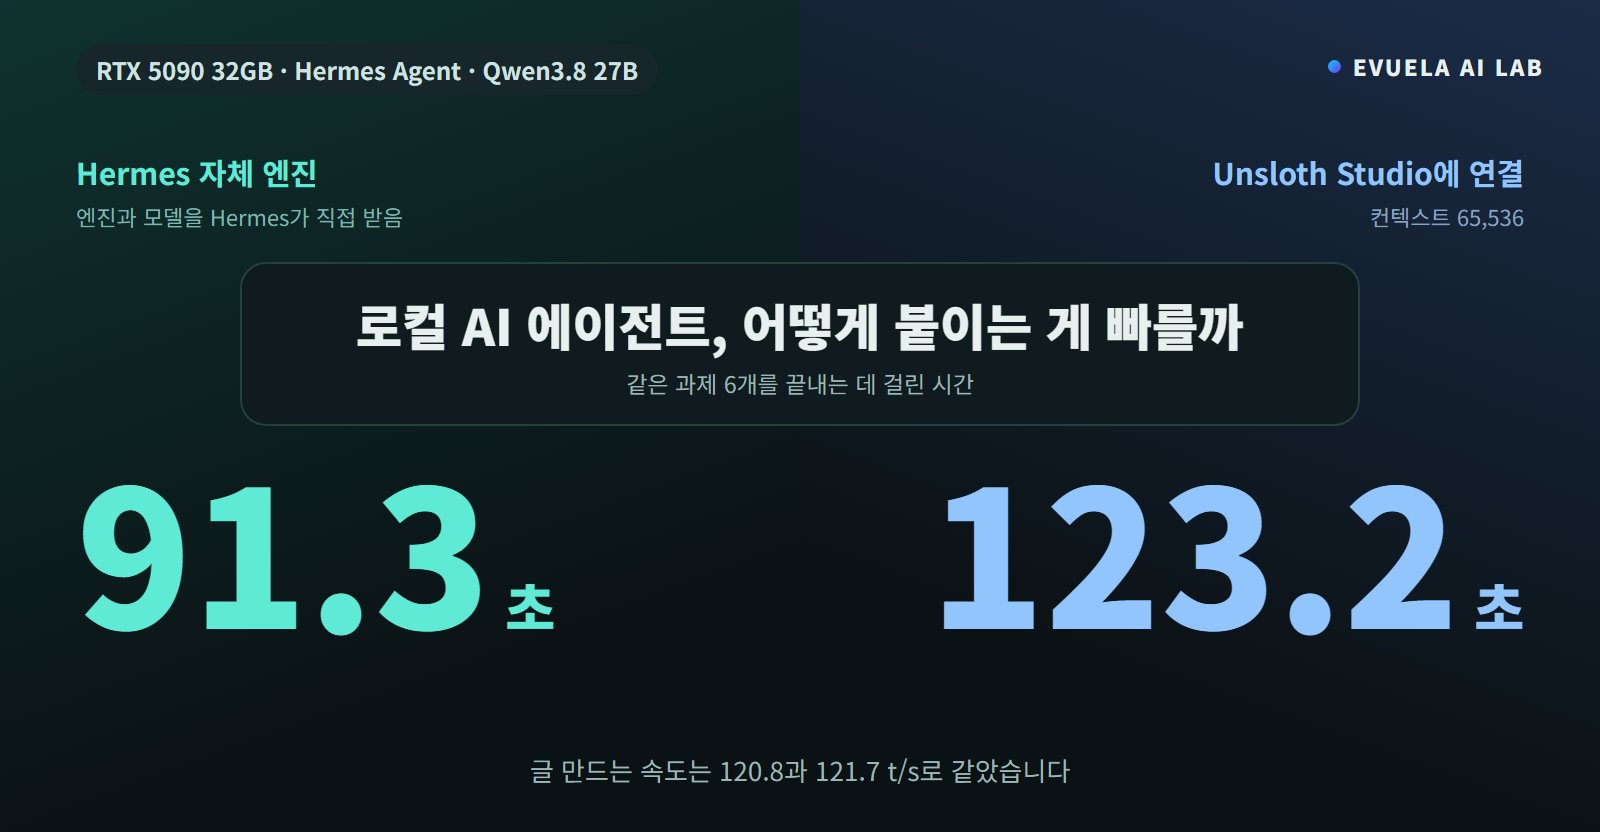 RTX 5090 32GB
Hermes Agent를 로컬 모델에 붙이는 두 방식을 RTX 5090에서 Qwen3.8 27B로 비교했습니다. 글 만드는 속도는 120.8과 121.7 t/s로 같았지만 과제 6개는 91.3초와 123.2초였습니다. 차이는 프롬프트를 다시 읽는 양에서 났습니다.
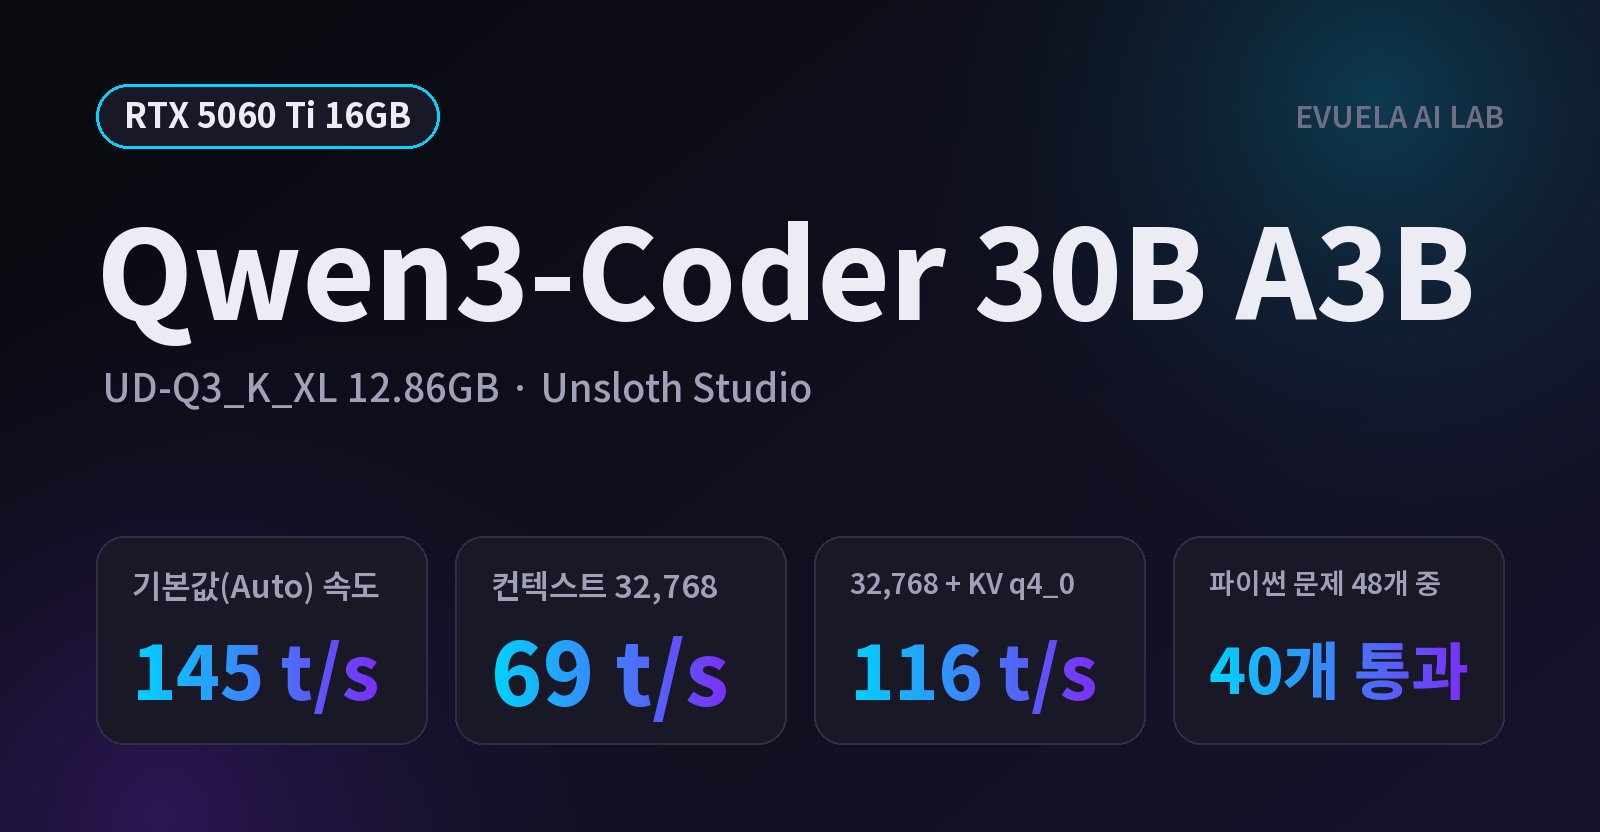 RTX 5060 Ti 16GB
의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
 AI 뉴스
업스테이지 솔라 미니 4의 'GPU 1장 구동'을 공식 발표로 확인했습니다. 양자화한 모델이 H100 80GB 한 장에 올라간다는 뜻이고, 모델 파일은 공개되지 않았습니다. 같은 크기 공개 모델로 그래픽카드별 크기를 가늠했습니다.
 RTX 5060 Ti 16GB
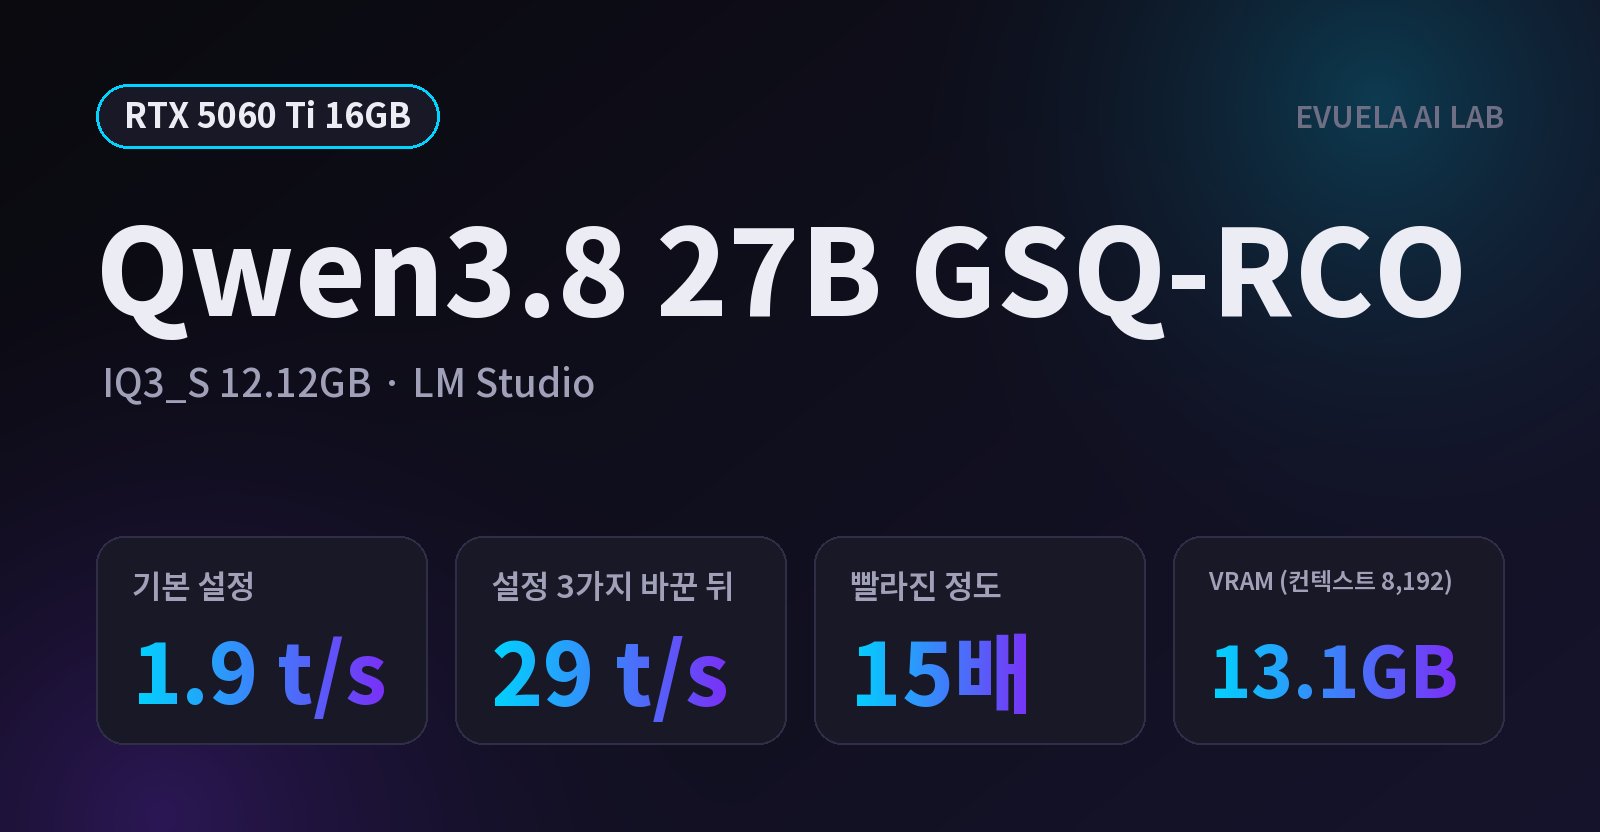
 PC의 LM Studio에서 Qwen3.8 27B GSQ-RCO(IQ3_S, 12.12GB)를 재 봤습니다. 기본 설정에서는 65개 레이어 중 56~58개만 GPU에 올라가 약 1.9t/s였고, Limit Model Offload 끄기·GPU 오프로드 최대·MTP 끄기 세 가지를 바꾸자 약 29t/s가 됐습니다. VRAM은 13.1GB, 컨텍스트는 32,768까지 맞았습니다.