 로컬 AI 시작하기
 6편, 로컬 AI가 느리거나 답이 안 나올 때 무엇을 볼까, Qwen3.8 27B는 설정 세 가지로 1.9토큰이 28.7토큰이 됐다
로컬 AI가 느리거나 답이 안 나올 때 볼 것을 증상별로 정리했습니다. 같은 3비트 파일이 레이어를 모두 그래픽카드에 올리자 초당 1.9토큰에서 28.7토큰이 됐고, 답이 멈출 때는 컨텍스트를 늘리거나 생각 단계를 낮추면 풀렸습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"한국어" 검색 결과 49건
로컬 AI 시작하기
로컬 AI가 느리거나 답이 안 나올 때 볼 것을 증상별로 정리했습니다. 같은 3비트 파일이 레이어를 모두 그래픽카드에 올리자 초당 1.9토큰에서 28.7토큰이 됐고, 답이 멈출 때는 컨텍스트를 늘리거나 생각 단계를 낮추면 풀렸습니다.
 로컬 AI 시작하기
처음에 알아야 할 설정을 컨텍스트, 생각(Thinking), 온도 세 가지로 정리했습니다. Qwen3.8 27B는 생각을 Low만 켜도 정답률이 73%에서 99%가 됐고, 16GB에서는 컨텍스트를 숫자로 정하자 초당 약 52토큰이 약 94토큰이 됐습니다.
 로컬 AI 시작하기
모델 이름의 12B, A3B, QAT, GGUF, Q4_K_M이 무슨 뜻인지 조각별로 풀었습니다. 같은 Qwen3.8 27B도 4비트 파일은 17.74GB, 2비트 파일은 9.30GB였고, 같은 Q4_K_M도 올린 곳에 따라 16.46GB에서 18.97GB까지 달랐습니다.
 로컬 AI 시작하기
Unsloth Studio를 설치하고 Gemma 4 12B를 받아 첫 질문을 하기까지를 네 단계로 정리했습니다. 기본값으로 RTX 5090 32GB는 초당 약 233토큰, RTX 5060 Ti 16GB는 약 52토큰이었고, 16GB는 컨텍스트를 숫자로 정하면 약 94토큰이 됩니다.
 로컬 AI 시작하기
로컬 AI는 모델을 내 PC의 그래픽카드에서 돌리는 것입니다. 필요한 것 세 가지와 VRAM 확인하는 법을 정리하고, RTX 5060 Ti 16GB와 RTX 5090 32GB에서 직접 잰 속도와 VRAM을 한 표로 모았습니다. 가이드 일곱 편의 첫 편입니다.
 AI 뉴스
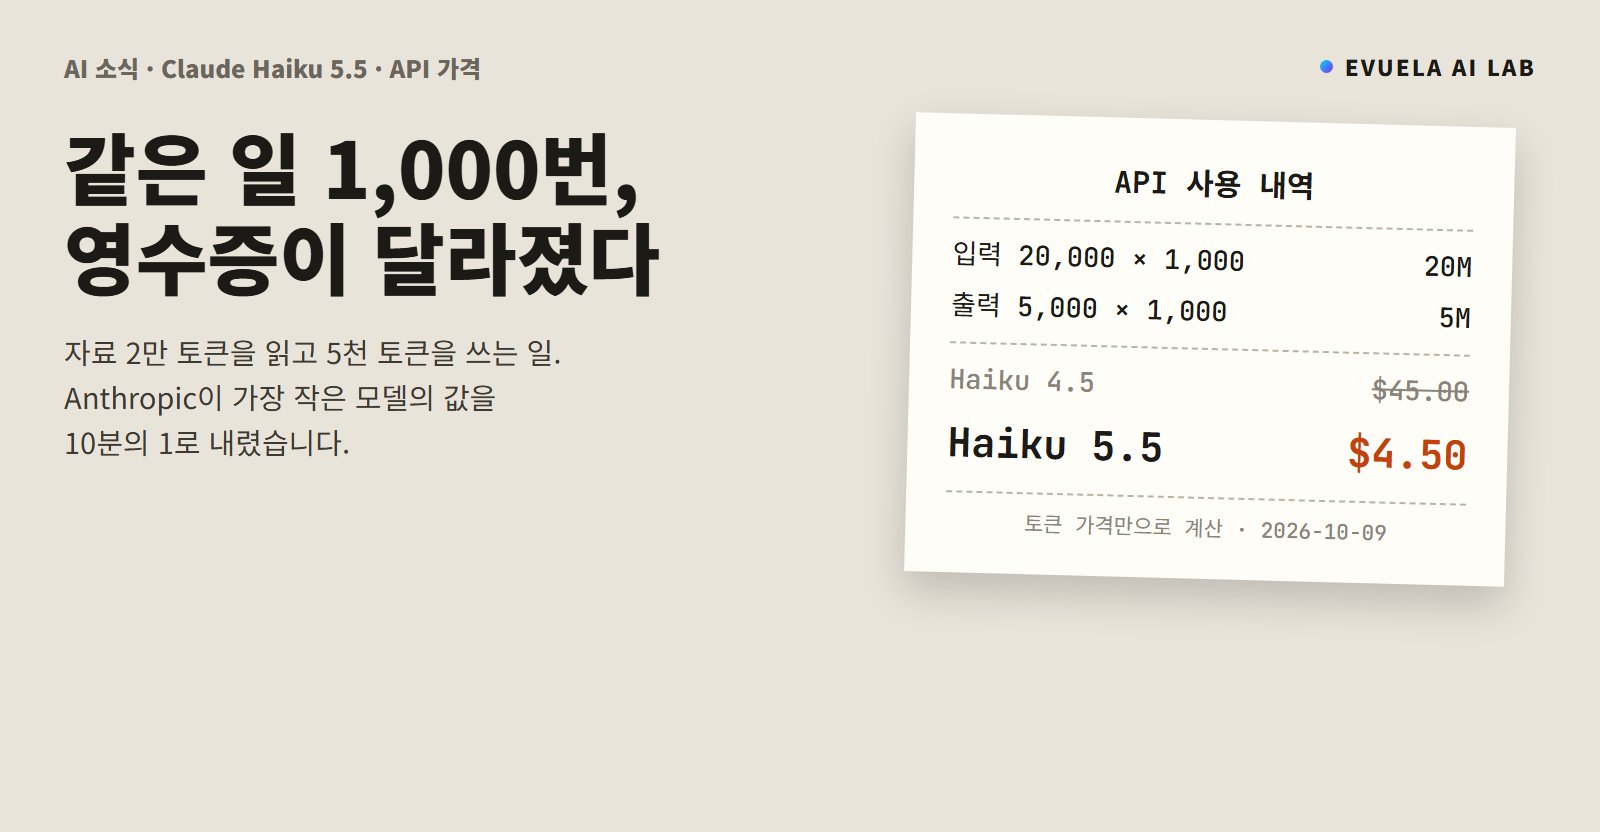
Anthropic이 10월 7일 Claude Haiku 5.5를 냈습니다. 입력 100만 토큰 0.10달러, 출력 0.50달러로 Haiku 4.5의 10분의 1이고 GPT-6 Luna와 같습니다. 프롬프트가 10만 토큰을 넘으면 값이 다섯 배가 되는 규칙과 로컬 AI 전기요금 비교까지 계산했습니다.
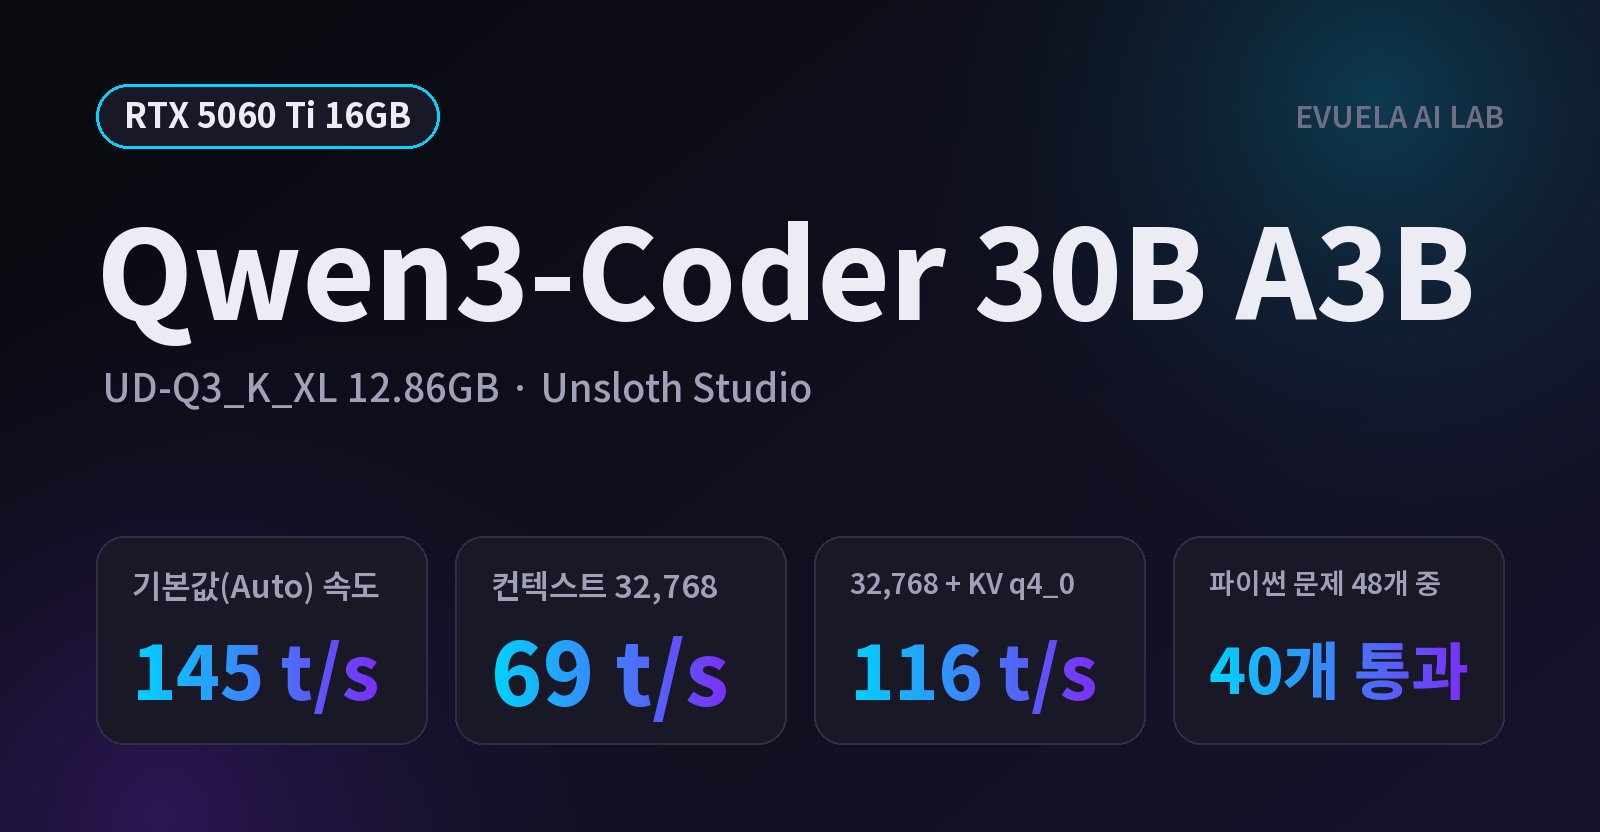 RTX 5060 Ti 16GB
의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
 RTX 5090 32GB
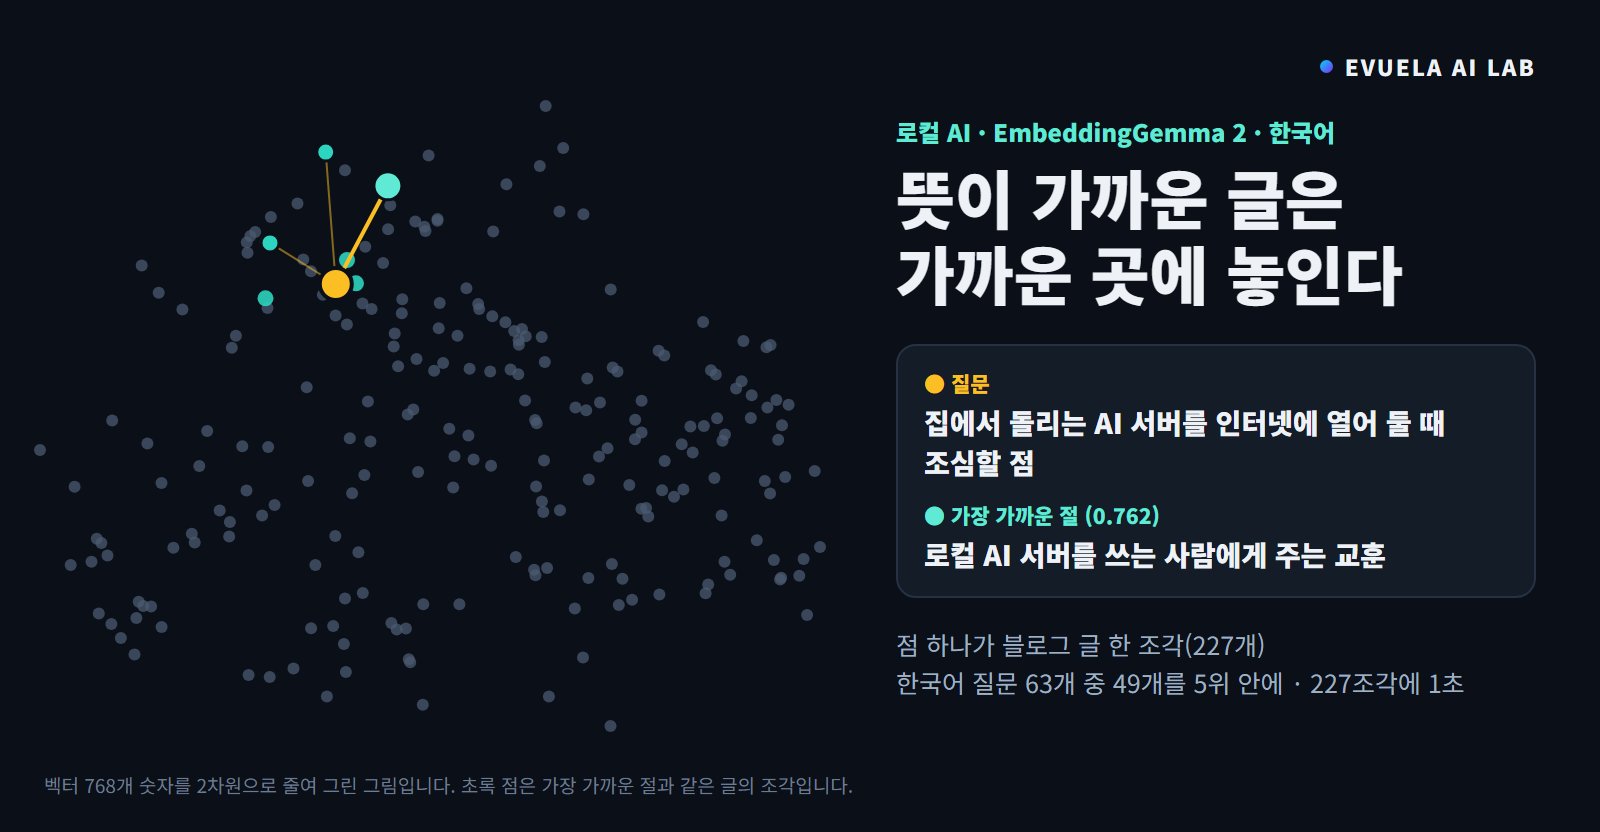
구글 EmbeddingGemma 2로 이 블로그 글 227조각을 한국어 질문 63개로 검색했습니다. 다른 낱말로 바꿔 물은 질문은 17개를 1위로 찾아 낱말 검색(9개)의 약 두 배였고, 영어로 물어도 34개를 찾았습니다. 227조각을 벡터로 바꾸는 데 1.06초, VRAM은 0.5GB였습니다.
 RTX 5090 32GB
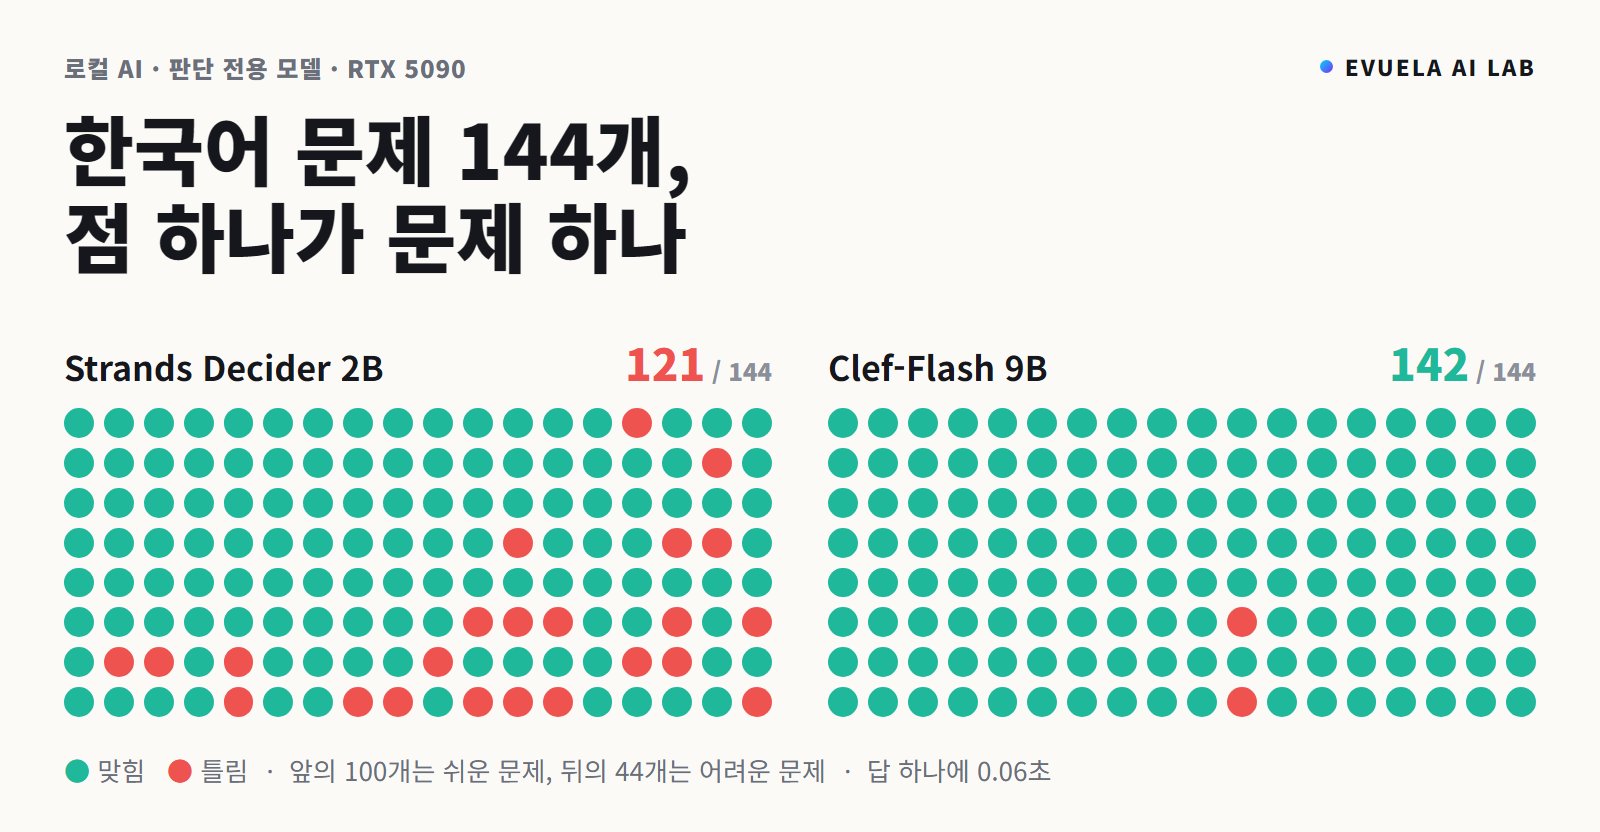
글을 쓰지 않고 보기 가운데 답을 확률로 고르는 판단 전용 모델 Strands Decider 2B와 Clef-Flash 9B를 RTX 5090에서 한국어 144문제로 비교했습니다. 쉬운 문제는 95개와 100개, 어려운 문제는 26개와 42개를 맞혔고 답 하나에 0.05~0.07초였습니다.