 AI 도구
Claude Code에 개인정보가 넘어가지 않게 하려면, 요청문 하나로 훅을 만들어 보니 원래 값 7개가 0개로
Claude Code에 요청문 하나를 붙여 넣어 파일·명령 결과·메시지 속 이메일과 전화번호를 PC에서 먼저 가리는 훅을 만들었습니다. 가짜 명단 시험에서 원래 값 7개가 0개가 됐고, 화면 안내와 못 가리는 것까지 정리했습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"파이썬" 검색 결과 22건
AI 도구
Claude Code에 요청문 하나를 붙여 넣어 파일·명령 결과·메시지 속 이메일과 전화번호를 PC에서 먼저 가리는 훅을 만들었습니다. 가짜 명단 시험에서 원래 값 7개가 0개가 됐고, 화면 안내와 못 가리는 것까지 정리했습니다.
 AI 뉴스
Claude Code가 curl 명령의 User-Agent에 계정 이메일을 넣었다는 신고가 나왔습니다. 원인과 2.1.317 보호 모드가 못 막는 것을 정리하고, 내 PC 기록 81,195번을 점검한 뒤 실행을 막은 채 120번 재현해 봤습니다.
 RTX 5090 32GB
에이전트용 1.7B 모델 LFM3-1.7B를 Hermes Agent에 붙여 RTX 5090에서 과제 7가지를 시켰습니다. 33번 중 28번 성공, VRAM 5.5GB, 초당 252토큰. 짧은 일은 Qwen3.8 27B보다 빨랐지만 여러 단계 작업은 5번 중 1번만 성공했습니다.
 RTX 5090 32GB
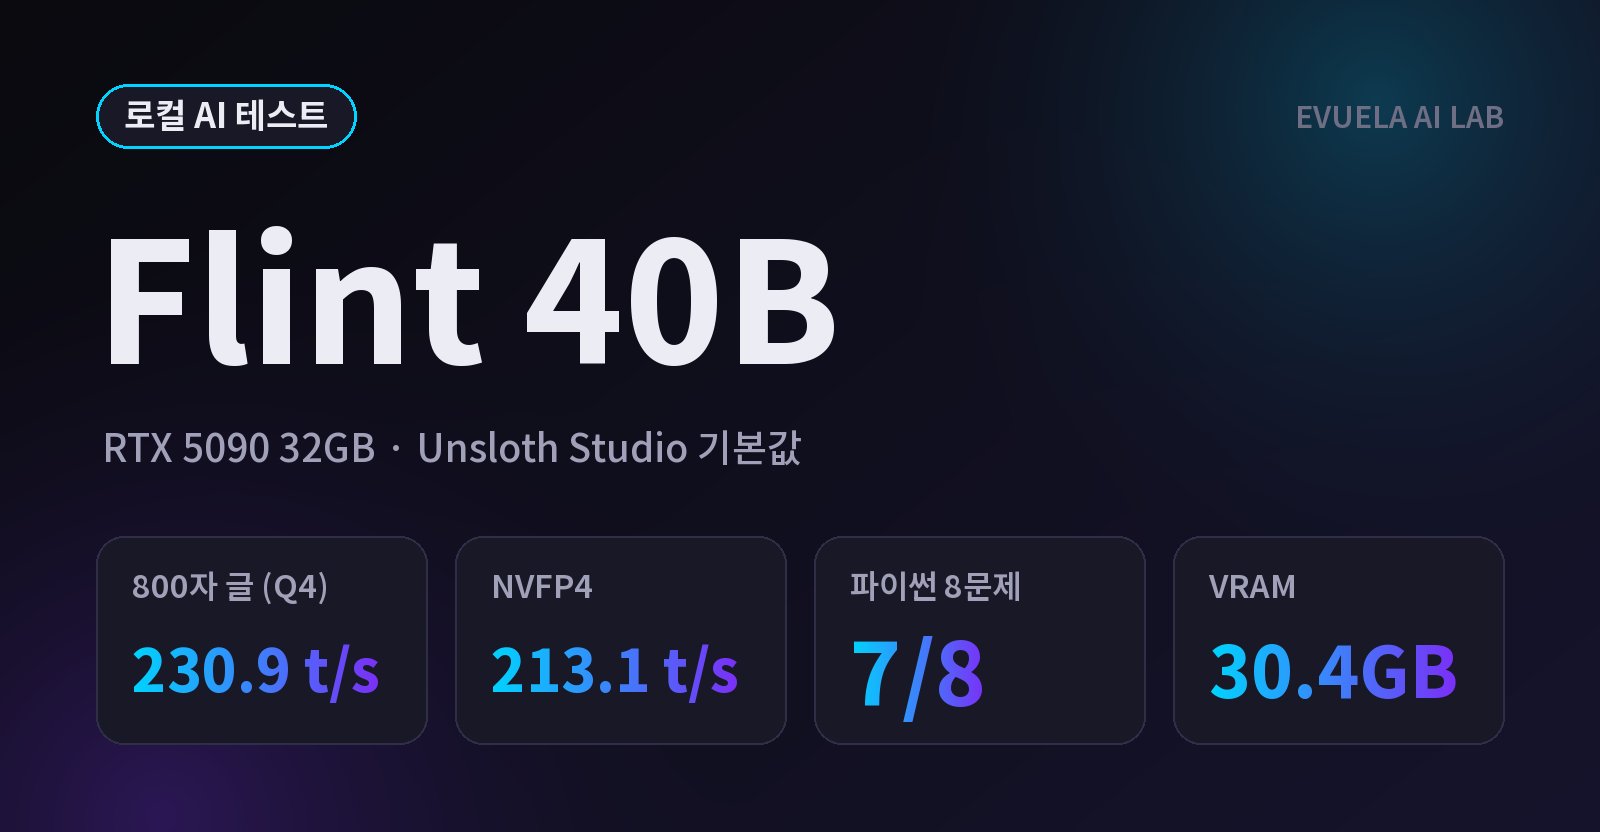
Recursive SI의 공개 코딩 모델 Flint 40B를 RTX 5090 32GB의 Unsloth Studio에서 Q4와 공식 NVFP4로 쟀습니다. 초당 230.9토큰, VRAM 30.4GB, 파이썬 8문제 중 7문제를 풀었고, 생각은 끌 수 없었으며 37만 8천 원을 3만 7,800원으로 읽었습니다.
 RTX 5060 Ti 16GB
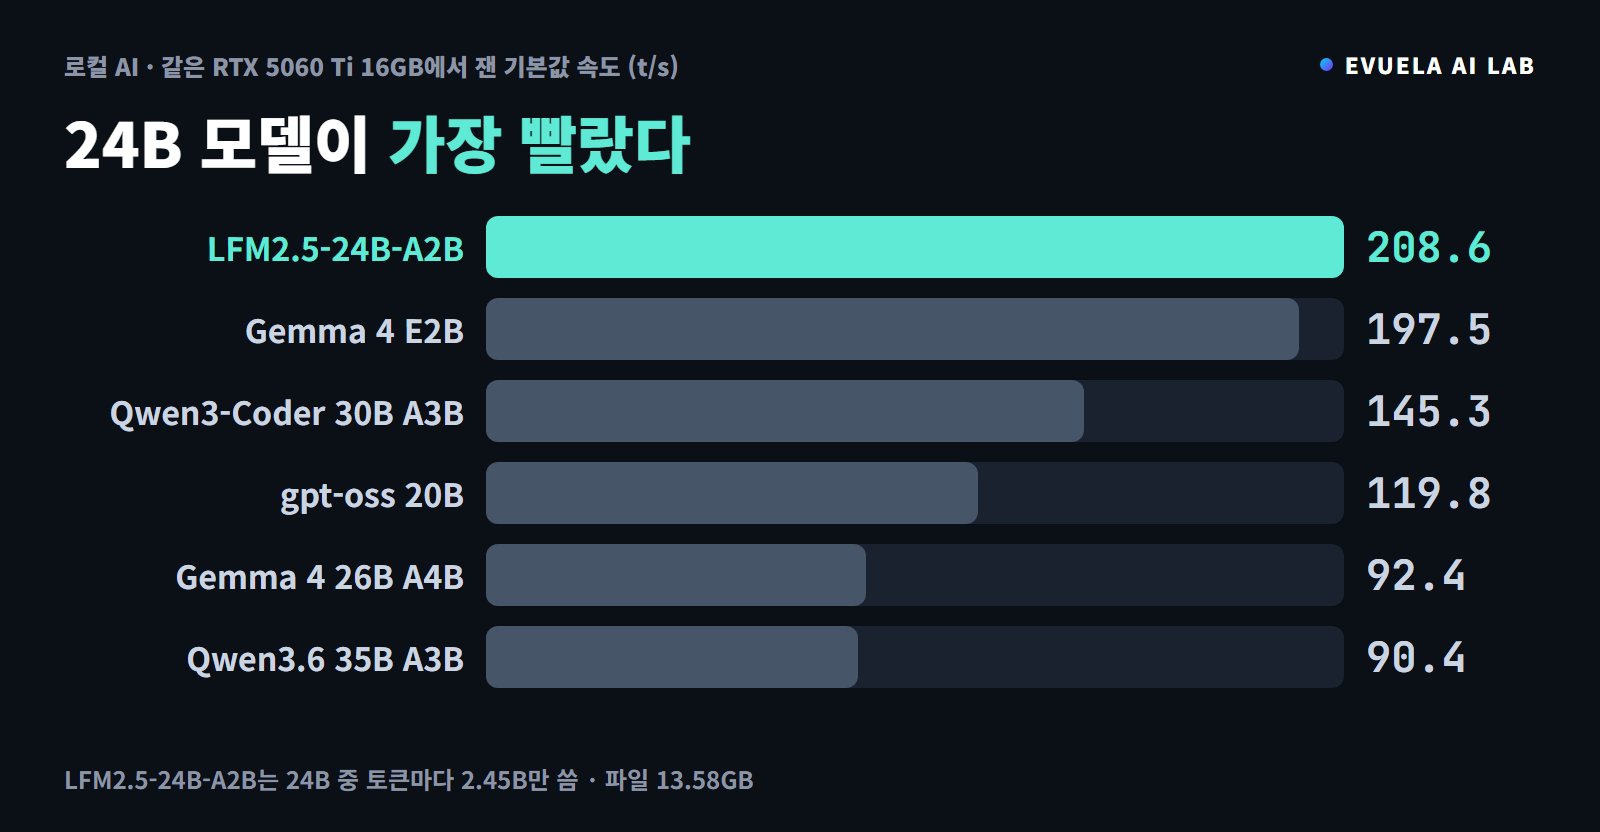
24B 중 토큰마다 2.45B만 쓰는 Liquid AI의 LFM2.5-24B-A2B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 208.6토큰으로 이 PC에서 가장 빨랐고, 100,000자 요약은 20.7초, 생각은 끌 수 없었습니다.
 RTX 5060 Ti 16GB
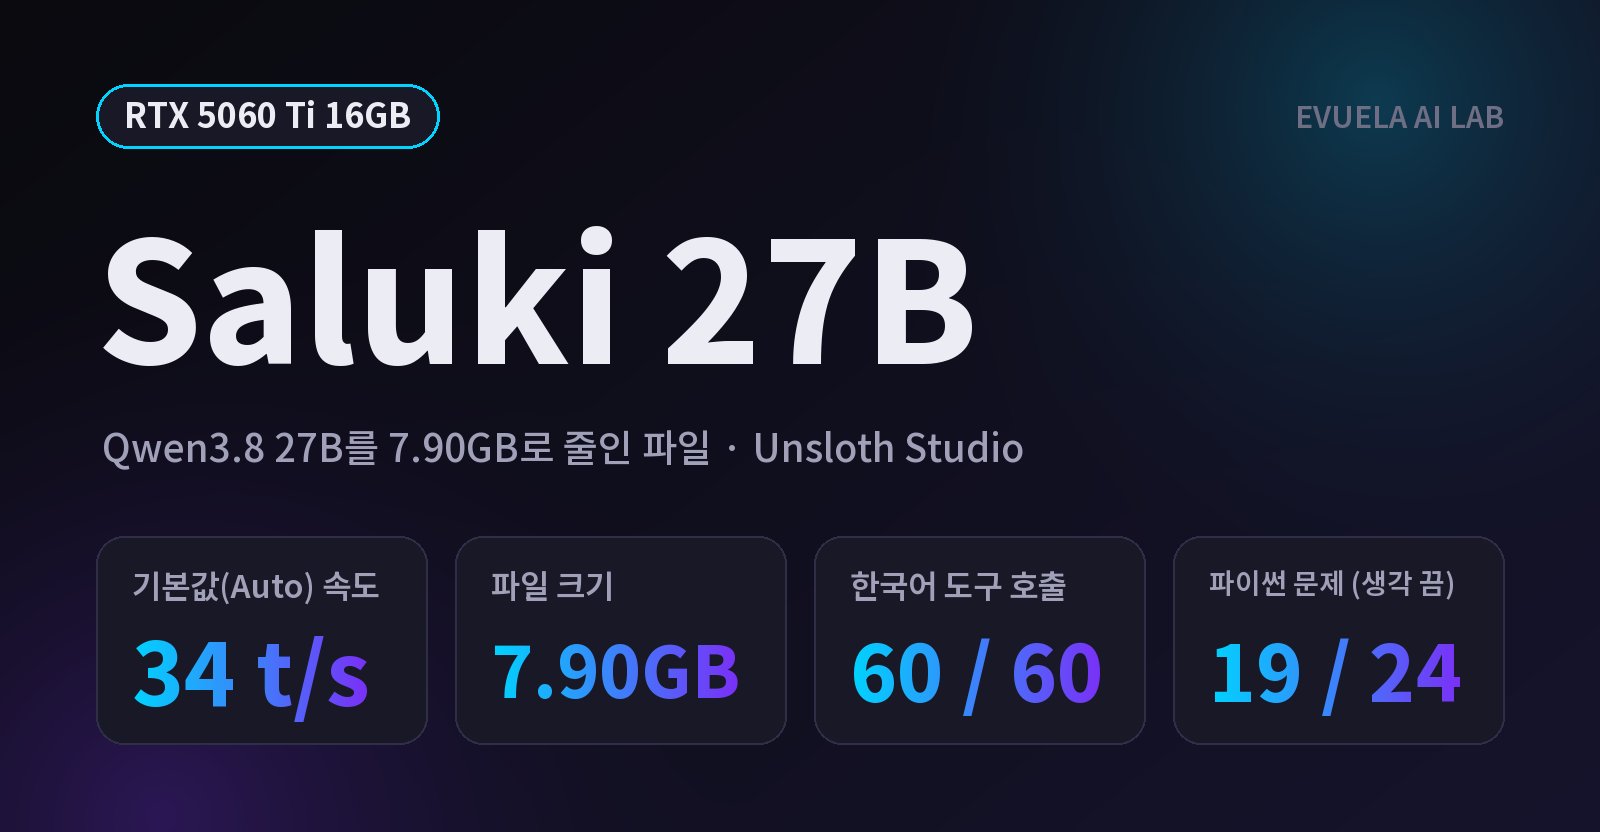
Qwen3.8 27B를 7.90GB로 줄인 Saluki 27B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 34토큰, 한국어 도구 호출 60번 모두 정답이었고, 생각 단계를 정하지 않으면 15번 중 6번은 답이 나오지 않았습니다.
 RTX 5060 Ti 16GB
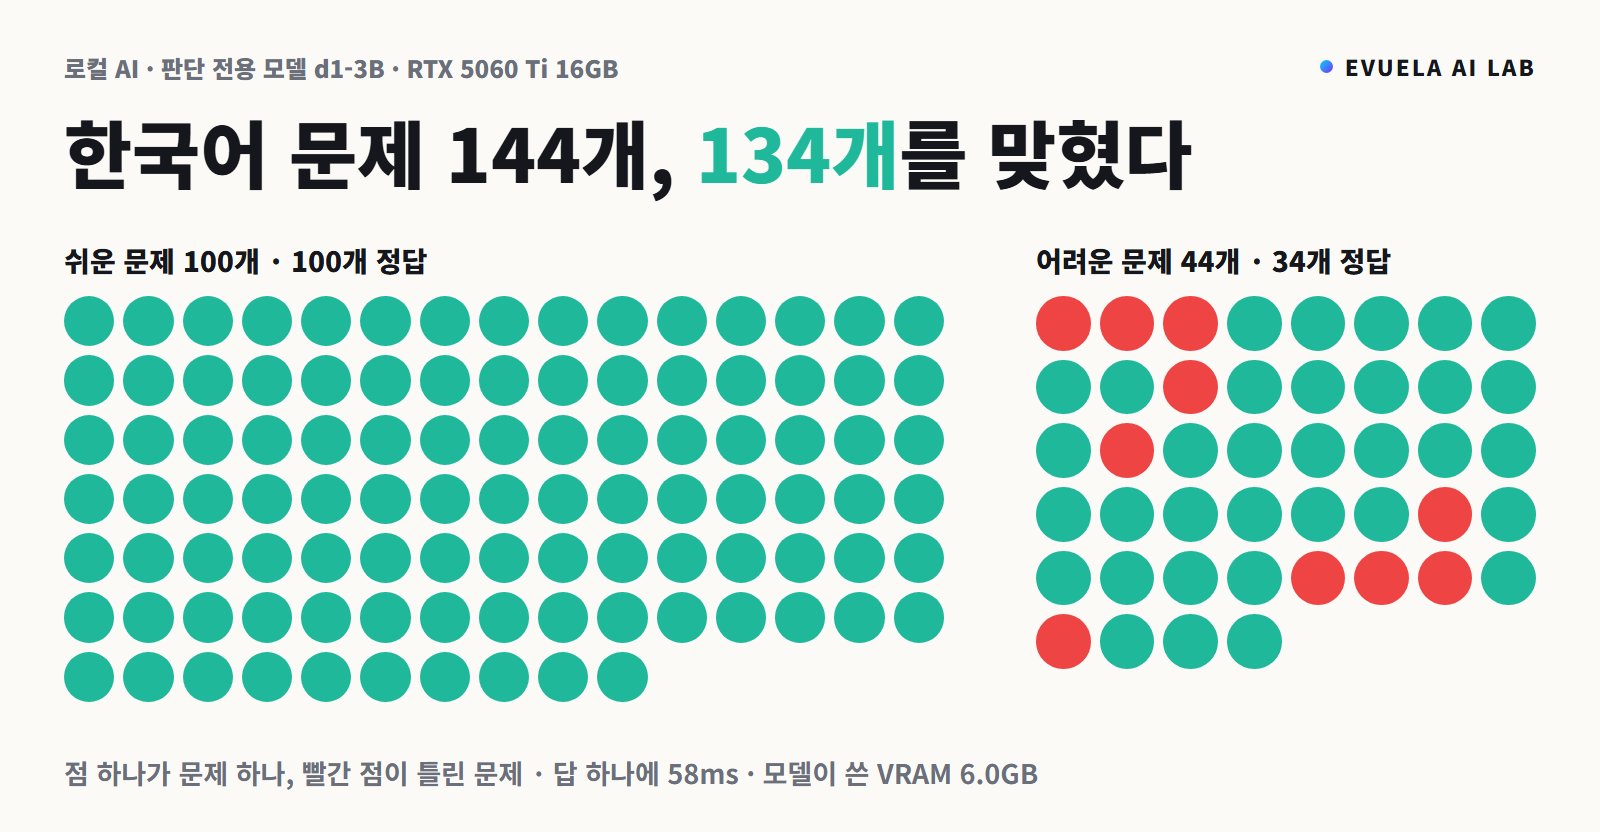
글을 쓰지 않고 보기마다 확률로 답하는 Liquid AI의 판단 전용 모델 d1-3B를 RTX 5060 Ti 16GB에서 한국어 144문제로 쟀습니다. 쉬운 100문제는 모두, 어려운 44문제는 34개를 맞혔고 답 하나에 0.06초, VRAM 6.0GB였습니다.
 RTX 5060 Ti 16GB
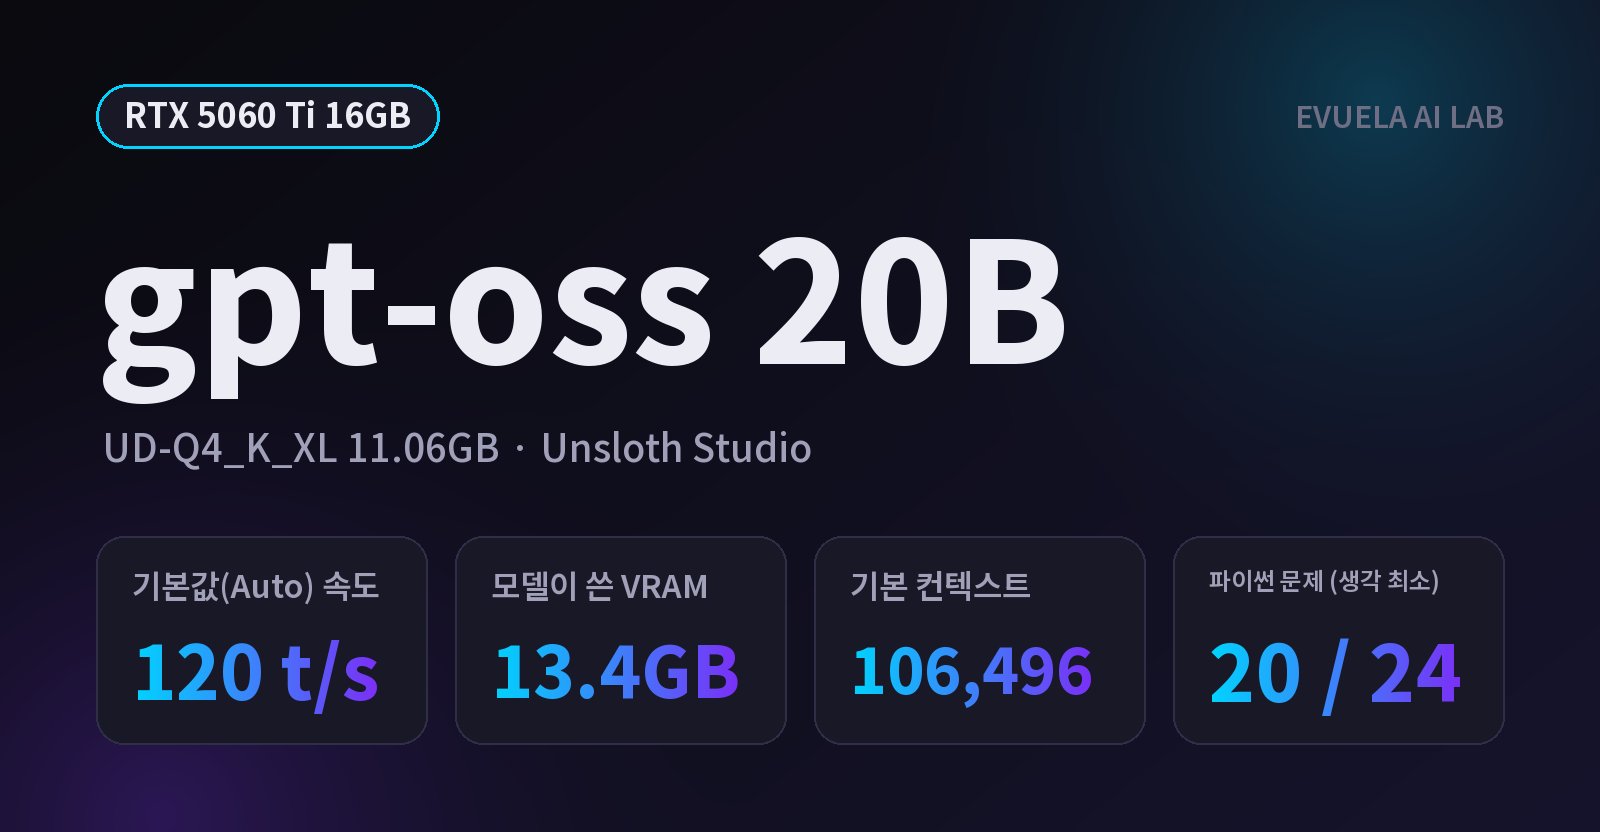
의 Unsloth Studio에서 OpenAI의 gpt-oss 20B(UD-Q4_K_XL 11.06GB)를 기본값으로 돌렸습니다. 초당 약 120토큰, 컨텍스트 65,536까지 같은 속도였고, 생각 단계에 따라 시간과 코딩 결과가 크게 달랐습니다.
 RTX 5060 Ti 16GB
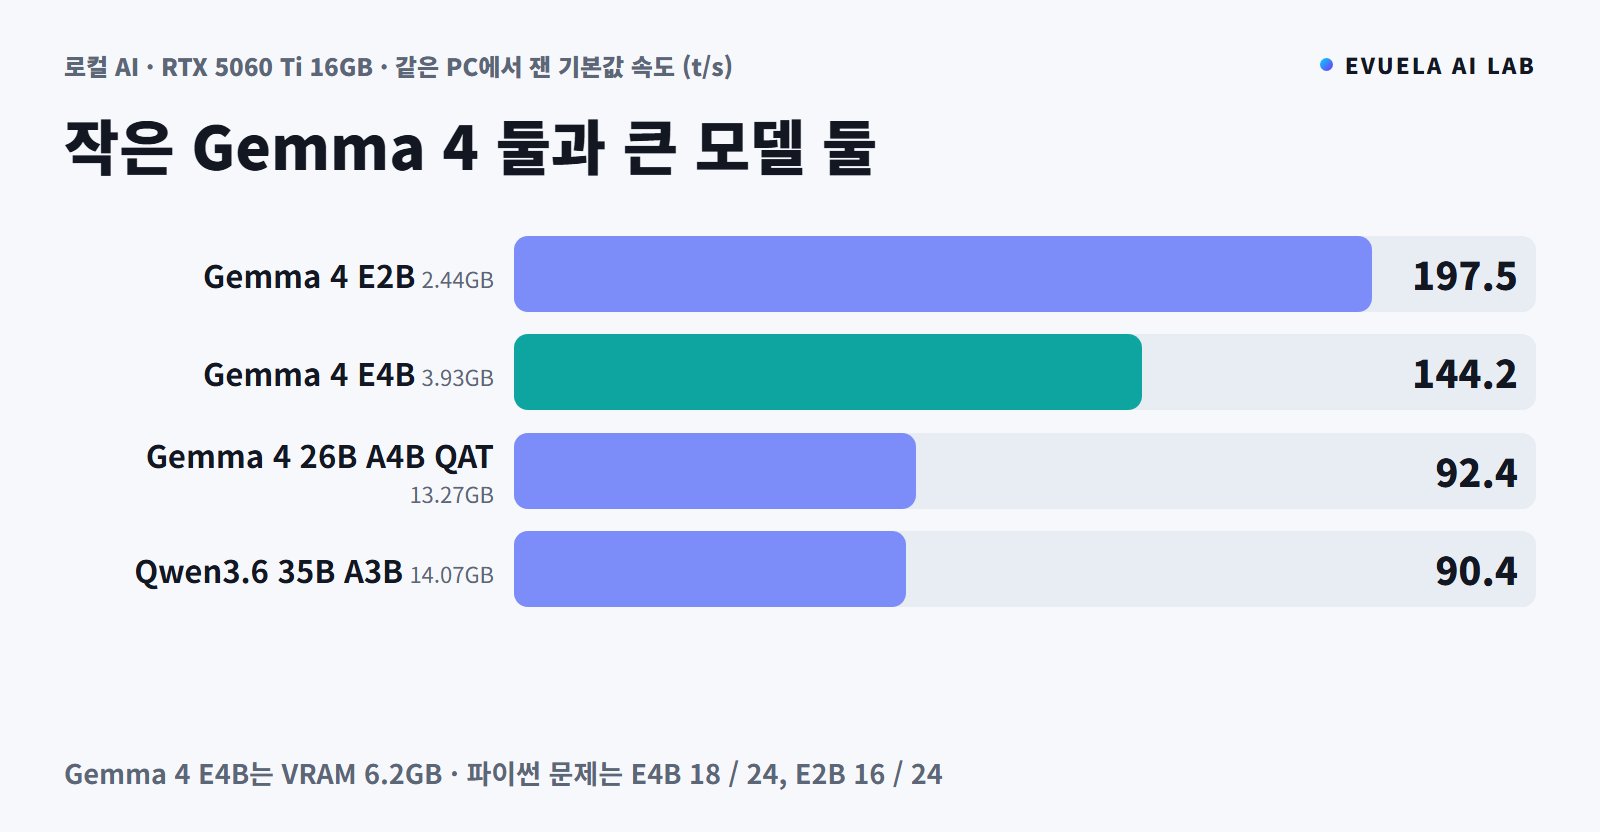
의 Unsloth Studio에서 Gemma 4 E4B(QAT UD-Q4_K_XL 3.93GB)를 기본값으로 돌렸습니다. VRAM 6.2GB에 초당 약 144토큰이었고, 같은 PC에서 잰 E2B와 속도·산수·코딩·사진 결과를 나란히 비교했습니다.