 AI 뉴스
웹사이트들이 AI 에이전트를 막기 시작했다, 한국 사이트 47곳의 robots.txt를 직접 확인하니 19곳이 막았다
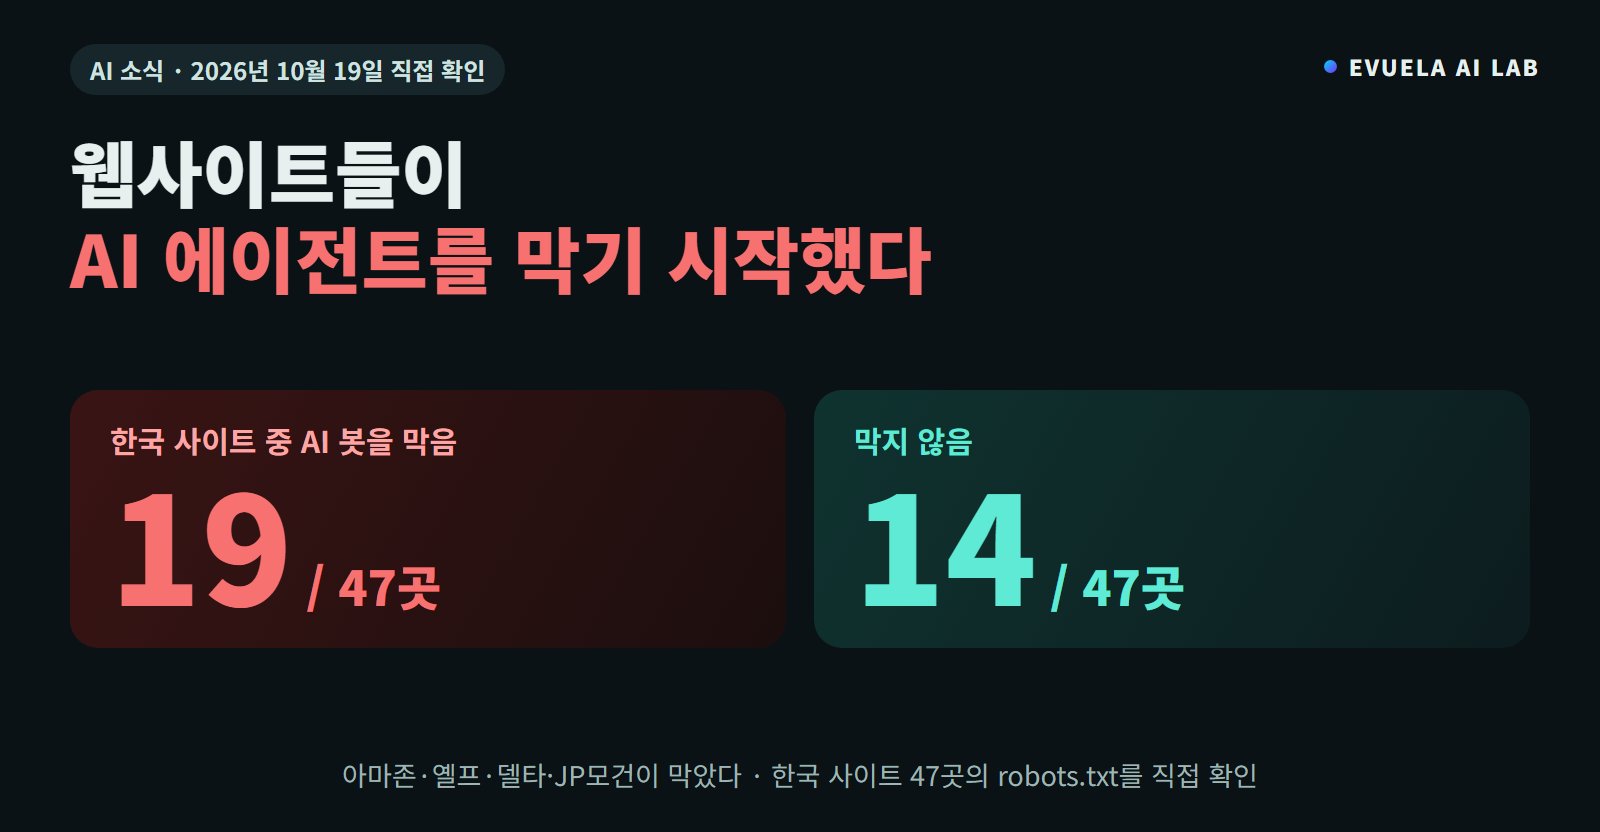
아마존·옐프·델타·JP모건이 AI 에이전트를 막기 시작했습니다. 한국 사이트 47곳의 robots.txt를 직접 받아 읽어 보니 19곳이 AI 봇을 따로 막았고 14곳은 막지 않았습니다. 학습·검색·대신 봇별로 나눈 결과와 실제 원문을 정리했습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"LLM" 검색 결과 11건
AI 뉴스
아마존·옐프·델타·JP모건이 AI 에이전트를 막기 시작했습니다. 한국 사이트 47곳의 robots.txt를 직접 받아 읽어 보니 19곳이 AI 봇을 따로 막았고 14곳은 막지 않았습니다. 학습·검색·대신 봇별로 나눈 결과와 실제 원문을 정리했습니다.
 RTX 5060 Ti 16GB
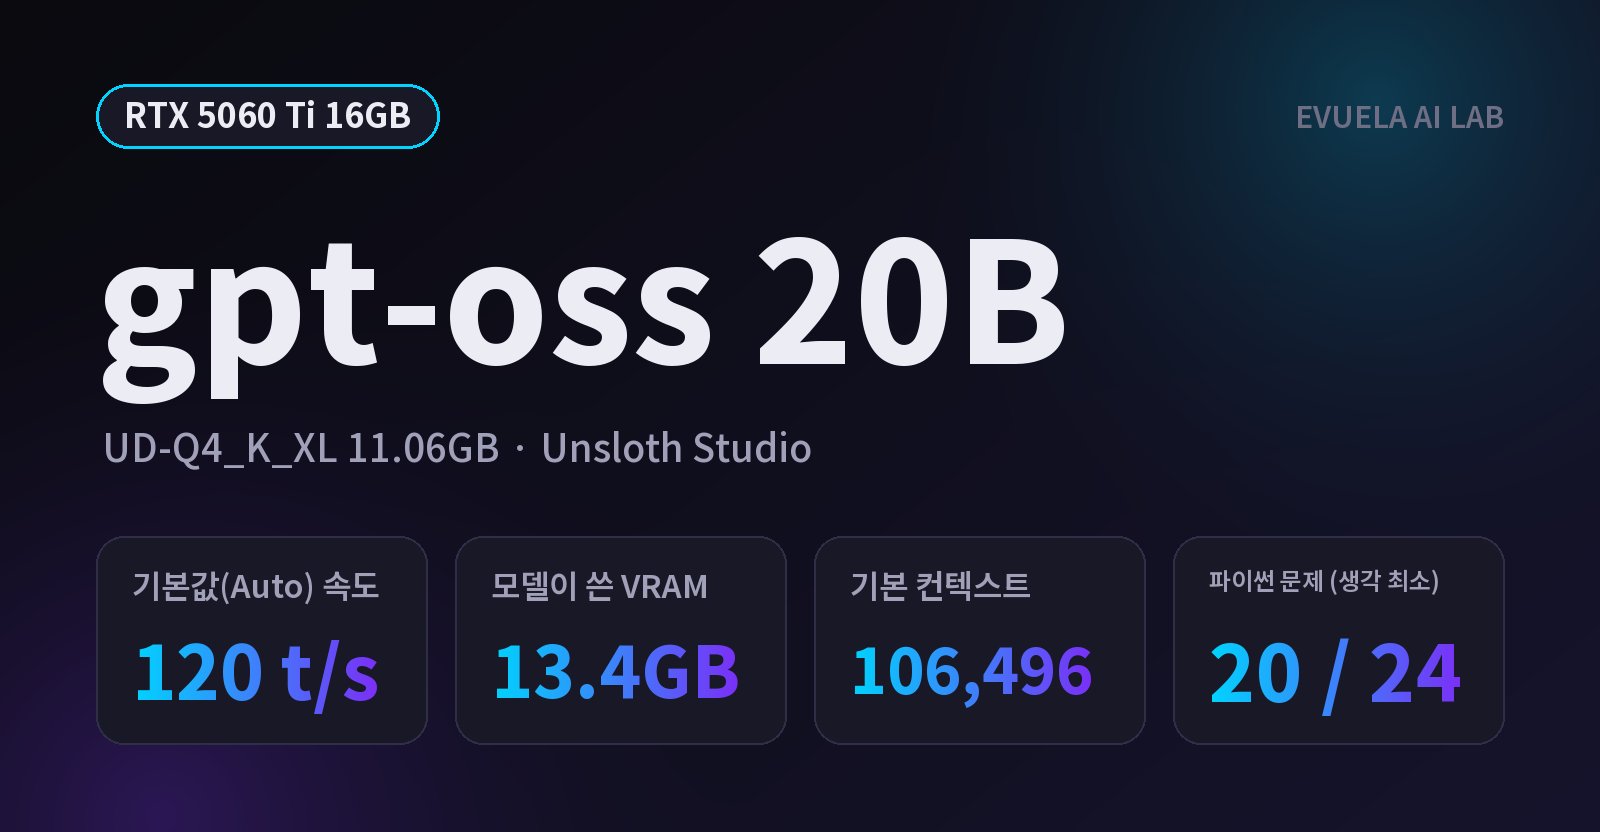
의 Unsloth Studio에서 OpenAI의 gpt-oss 20B(UD-Q4_K_XL 11.06GB)를 기본값으로 돌렸습니다. 초당 약 120토큰, 컨텍스트 65,536까지 같은 속도였고, 생각 단계에 따라 시간과 코딩 결과가 크게 달랐습니다.
 RTX 5060 Ti 16GB
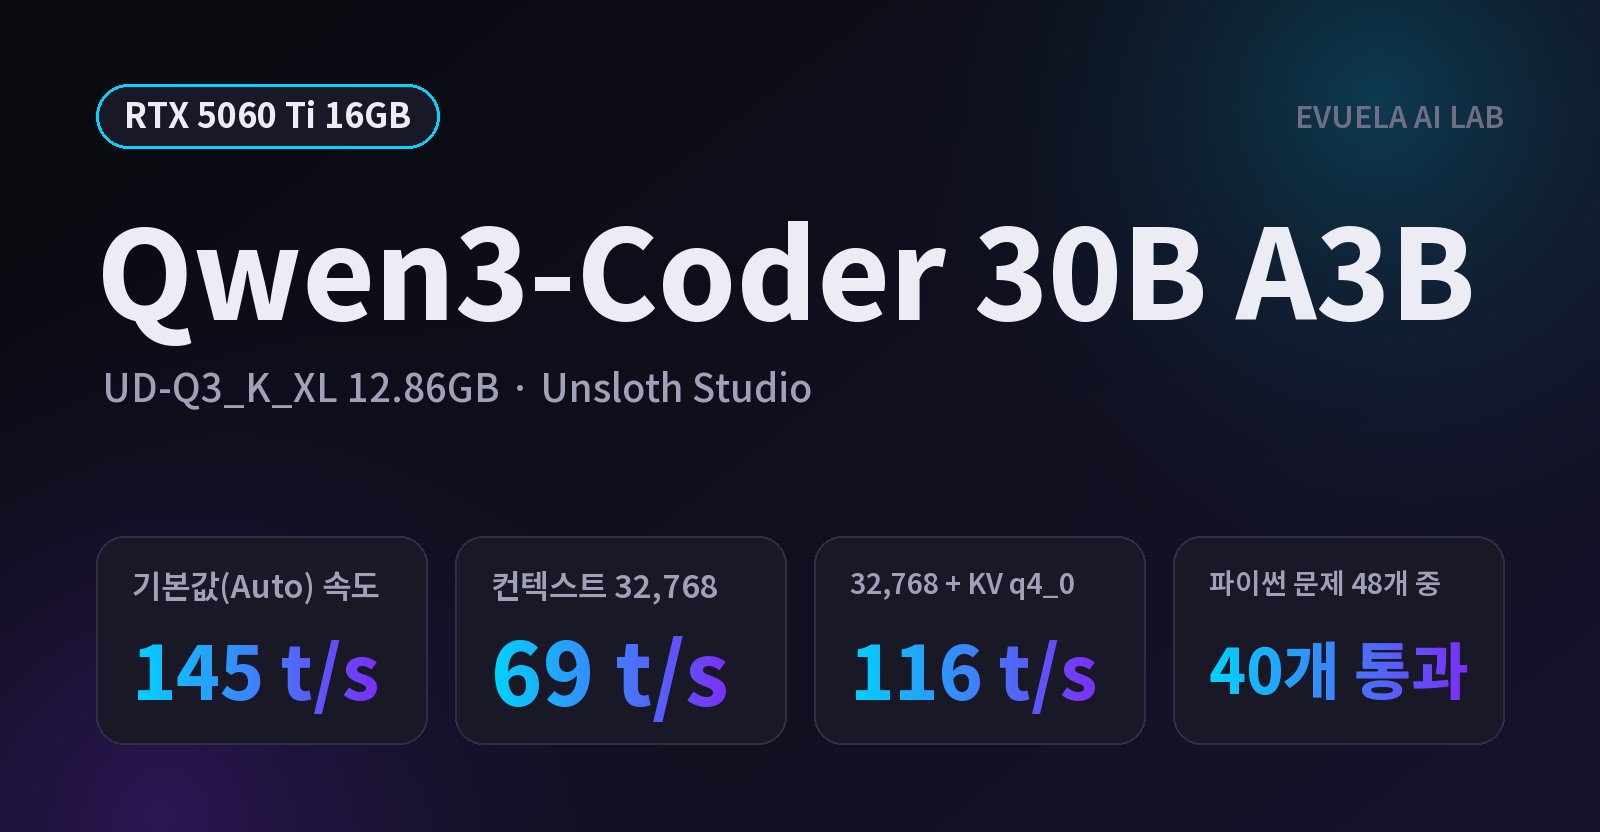
의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
 RTX 5060 Ti 16GB
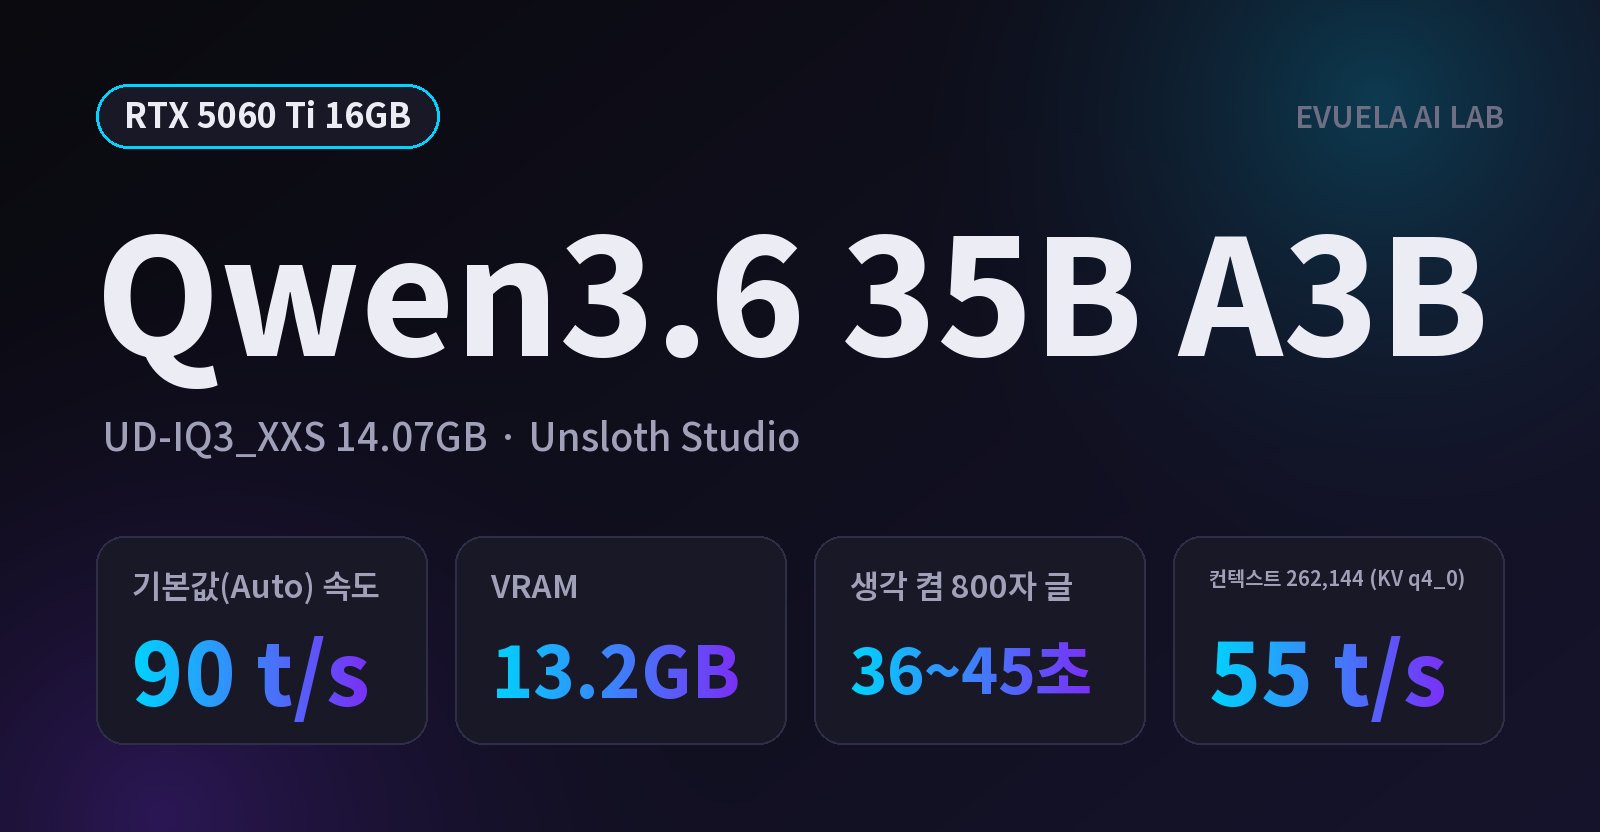
의 Unsloth Studio에서 Qwen3.6 35B A3B(UD-IQ3_XXS)를 기본값으로 돌렸습니다. VRAM 13.2GB에 다 들어갔고 초당 약 90토큰이었습니다. 컨텍스트별 속도, 설정 비교, Gemma 4 26B와의 비교를 담았습니다.
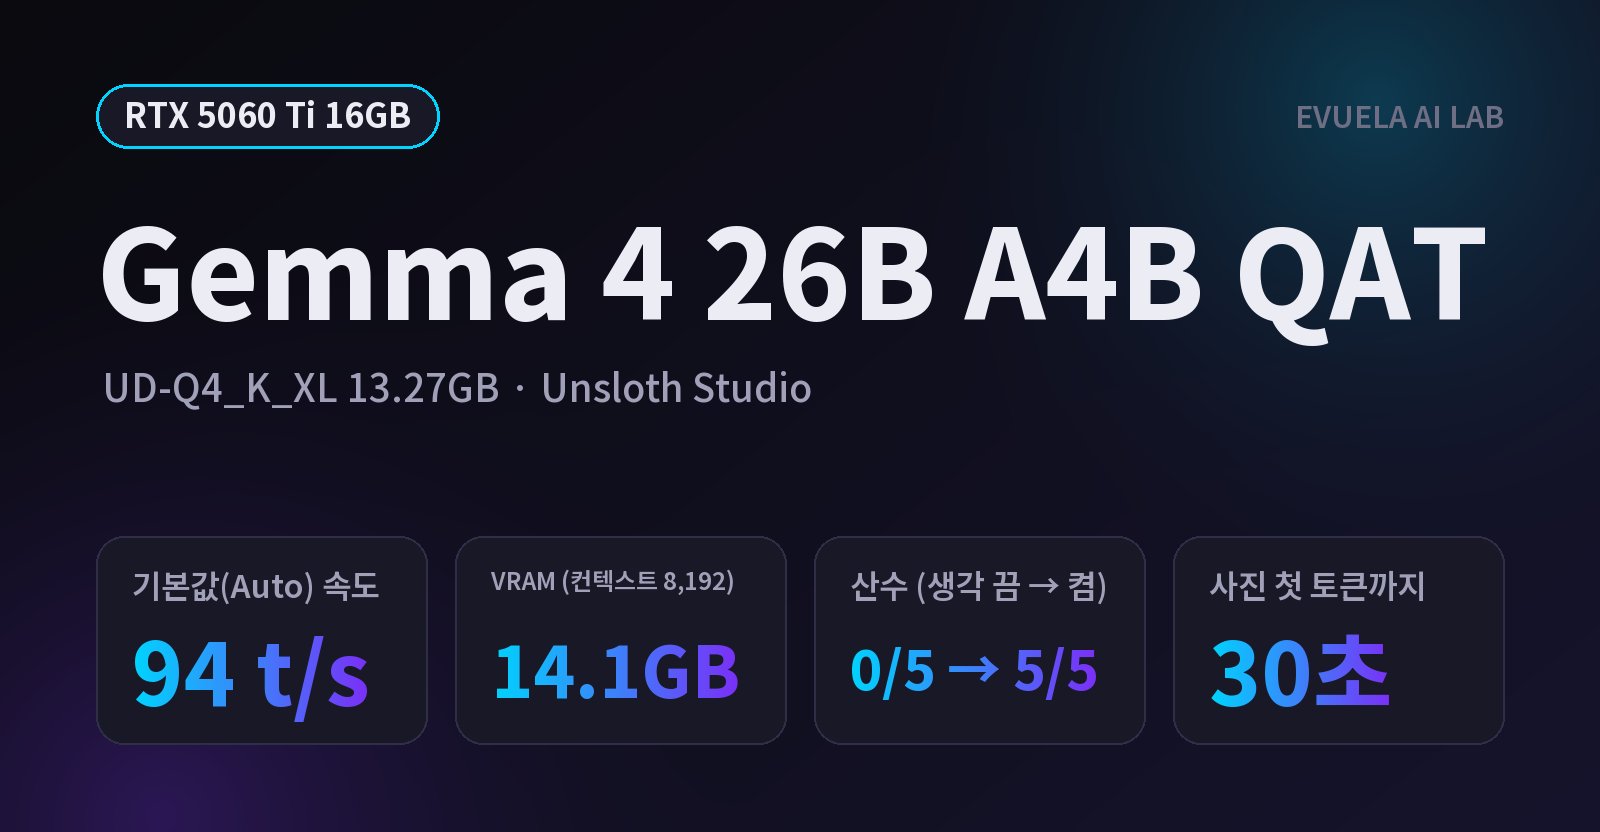 RTX 5060 Ti 16GB
의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
 AI 뉴스
AMD Ryzen AI Max PRO 400 시리즈가 들어간 PC가 팔리기 시작했습니다. 통합 메모리 192GB 가운데 160GB를 AI 모델에 쓸 수 있고, AMD는 300B 모델까지 돌릴 수 있다고 밝혔습니다. 공식 발표를 정리하고, 직접 잰 Qwen3.8 27B 파일 크기와 RTX 5090 속도를 가져와 300B가 정말 들어가는지, 들어가면 얼마나 빠를지 계산했습니다. 제품 가격과 RTX 5090과의 차이도 함께 담았습니다.
 AI 뉴스
엔비디아가 2026년 9월 허깅페이스를 약 129억 3천만 달러에 인수하기로 했습니다. SEC 공시와 공식 발표를 바탕으로 인수 조건, 완료 시점(2027년 상반기), 개방성 약속, 규제 심사, 로컬 LLM 사용자가 챙길 점을 정리했습니다.
 IT 뉴스
엔비디아의 차세대 지포스 RTX 5090과 블랙웰(Blackwell) 아키텍처 기반 GPU들이 보여주는 AI 추론 및 학습 성능 향상 수치와 핵심 기술 사양을 분석합니다.
 AI 뉴스
2026년 8월 출시된 Qwen3.8-27B는 270억 파라미터의 개방형 멀티모달 모델로, Apache 2.0 라이선스 기반의 강력한 에이전트 코딩 및 실무 작업 성능을 제공한다. 로컬 LLM 환경에서의 VRAM 요구사항과 실무 적용 가능성을 깊이 있게 분석한다.