로컬 AI 시작하기 2편, Unsloth Studio 설치부터 Gemma 4 12B 첫 대화까지, 16GB는 설정 하나로 52토큰이 94토큰이 됐다
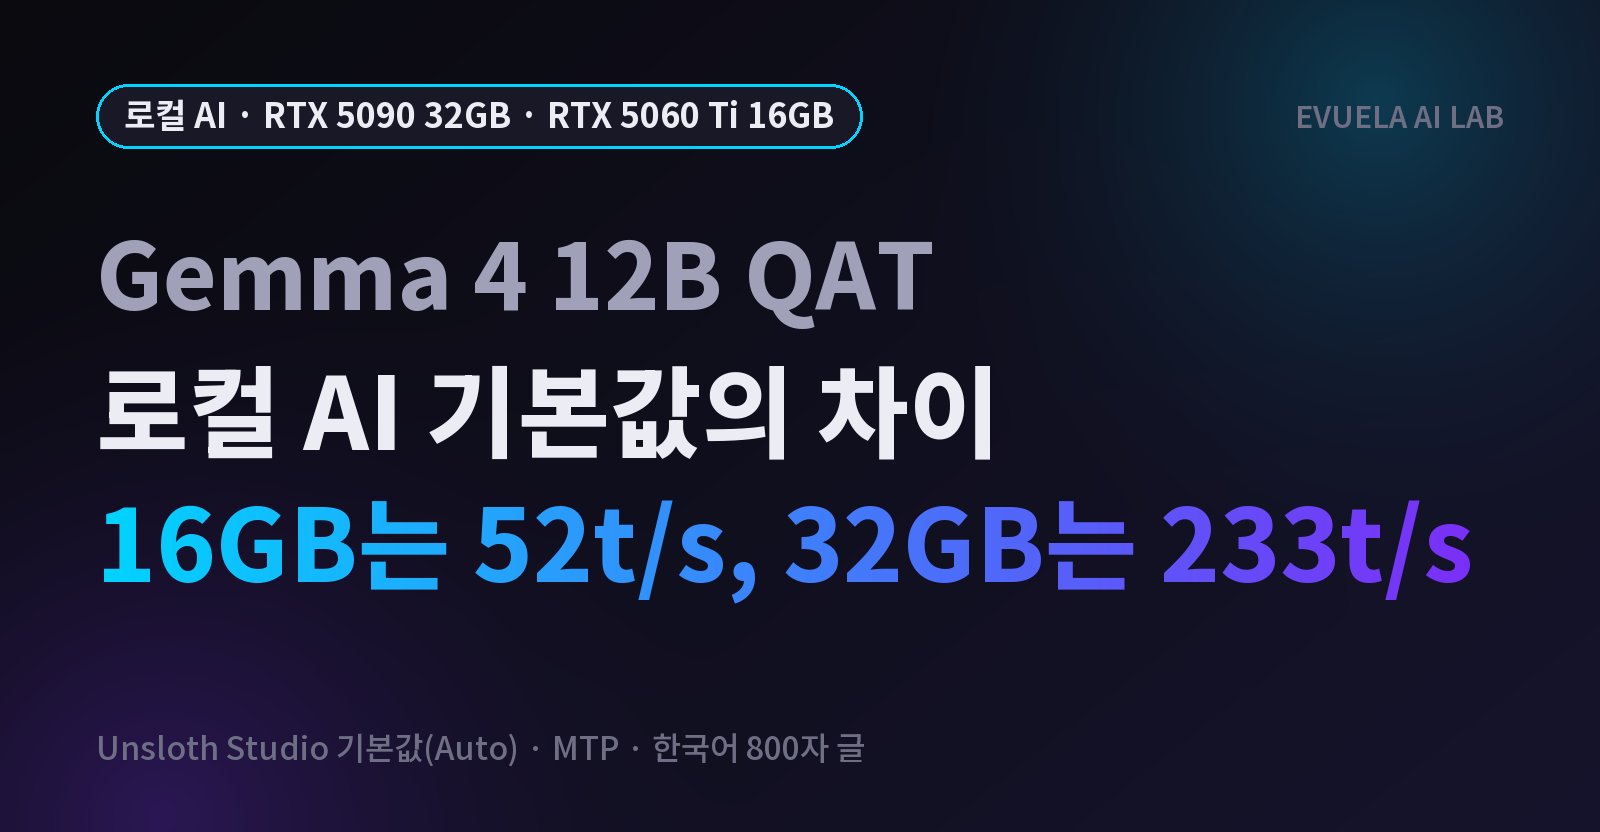
Unsloth Studio를 설치하고 Gemma 4 12B를 받아 첫 질문을 하기까지를 네 단계로 정리했습니다. 기본값으로 RTX 5090 32GB는 초당 약 233토큰, RTX 5060 Ti 16GB는 약 52토큰이었고, 16GB는 컨텍스트를 숫자로 정하면 약 94토큰이 됩니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"GGUF" 검색 결과 35건
Unsloth Studio를 설치하고 Gemma 4 12B를 받아 첫 질문을 하기까지를 네 단계로 정리했습니다. 기본값으로 RTX 5090 32GB는 초당 약 233토큰, RTX 5060 Ti 16GB는 약 52토큰이었고, 16GB는 컨텍스트를 숫자로 정하면 약 94토큰이 됩니다.
로컬 AI는 모델을 내 PC의 그래픽카드에서 돌리는 것입니다. 필요한 것 세 가지와 VRAM 확인하는 법을 정리하고, RTX 5060 Ti 16GB와 RTX 5090 32GB에서 직접 잰 속도와 VRAM을 한 표로 모았습니다. 가이드 일곱 편의 첫 편입니다.
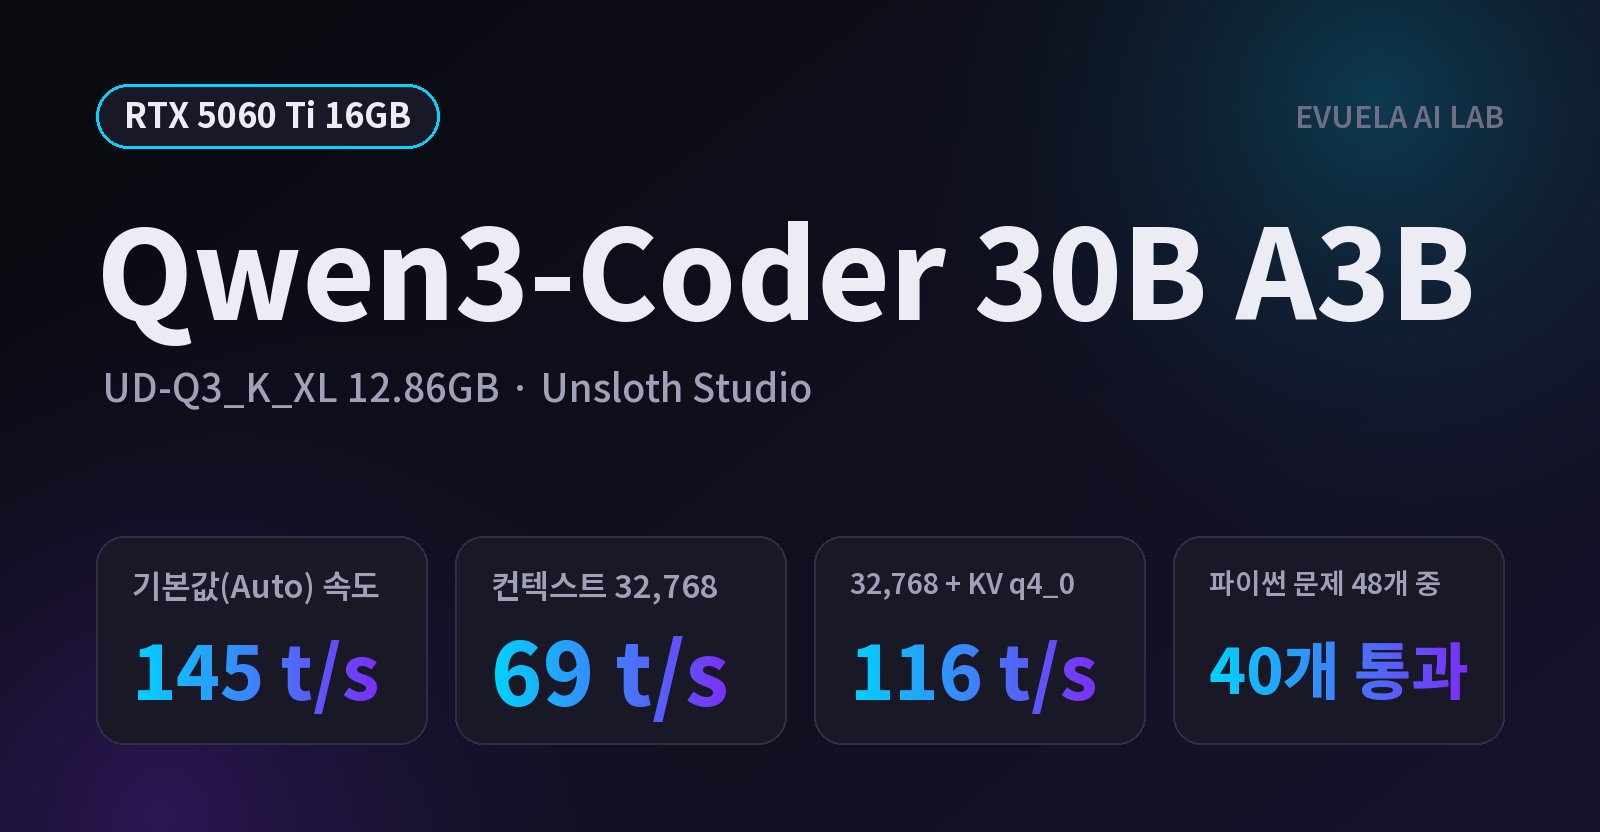
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
Gemma 4 12B QAT를 RTX 5090 32GB와 RTX 5060 Ti 16GB에서 Unsloth Studio 기본값으로 올렸습니다. 32GB는 MTP가 켜져 초당 233토큰, 16GB는 MTP가 꺼져 52토큰이었습니다. 16GB는 컨텍스트만 지정해도 94토큰이 됩니다.
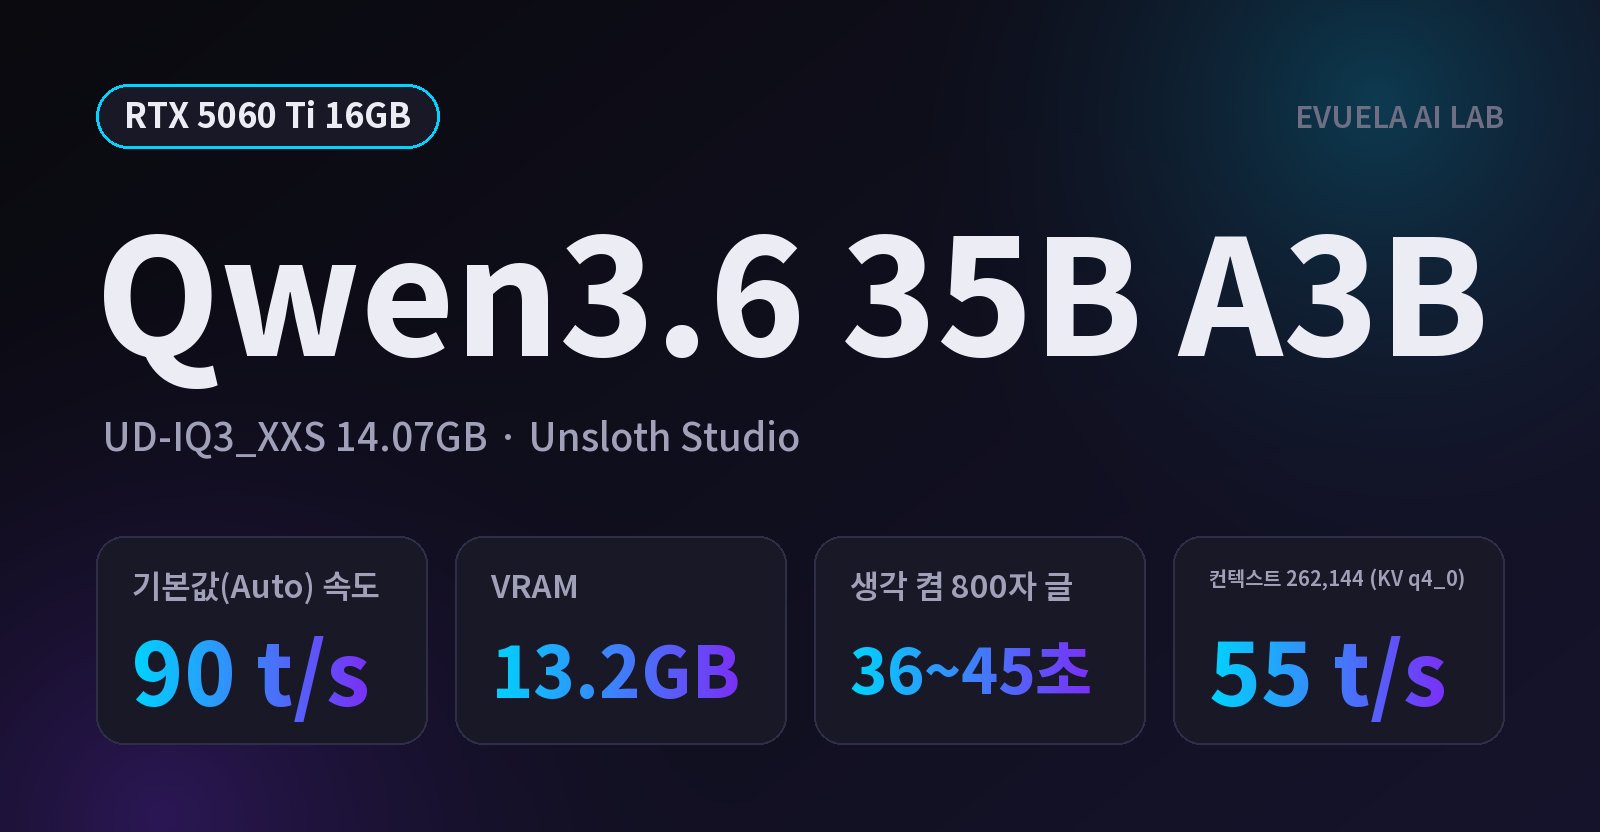
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3.6 35B A3B(UD-IQ3_XXS)를 기본값으로 돌렸습니다. VRAM 13.2GB에 다 들어갔고 초당 약 90토큰이었습니다. 컨텍스트별 속도, 설정 비교, Gemma 4 26B와의 비교를 담았습니다.
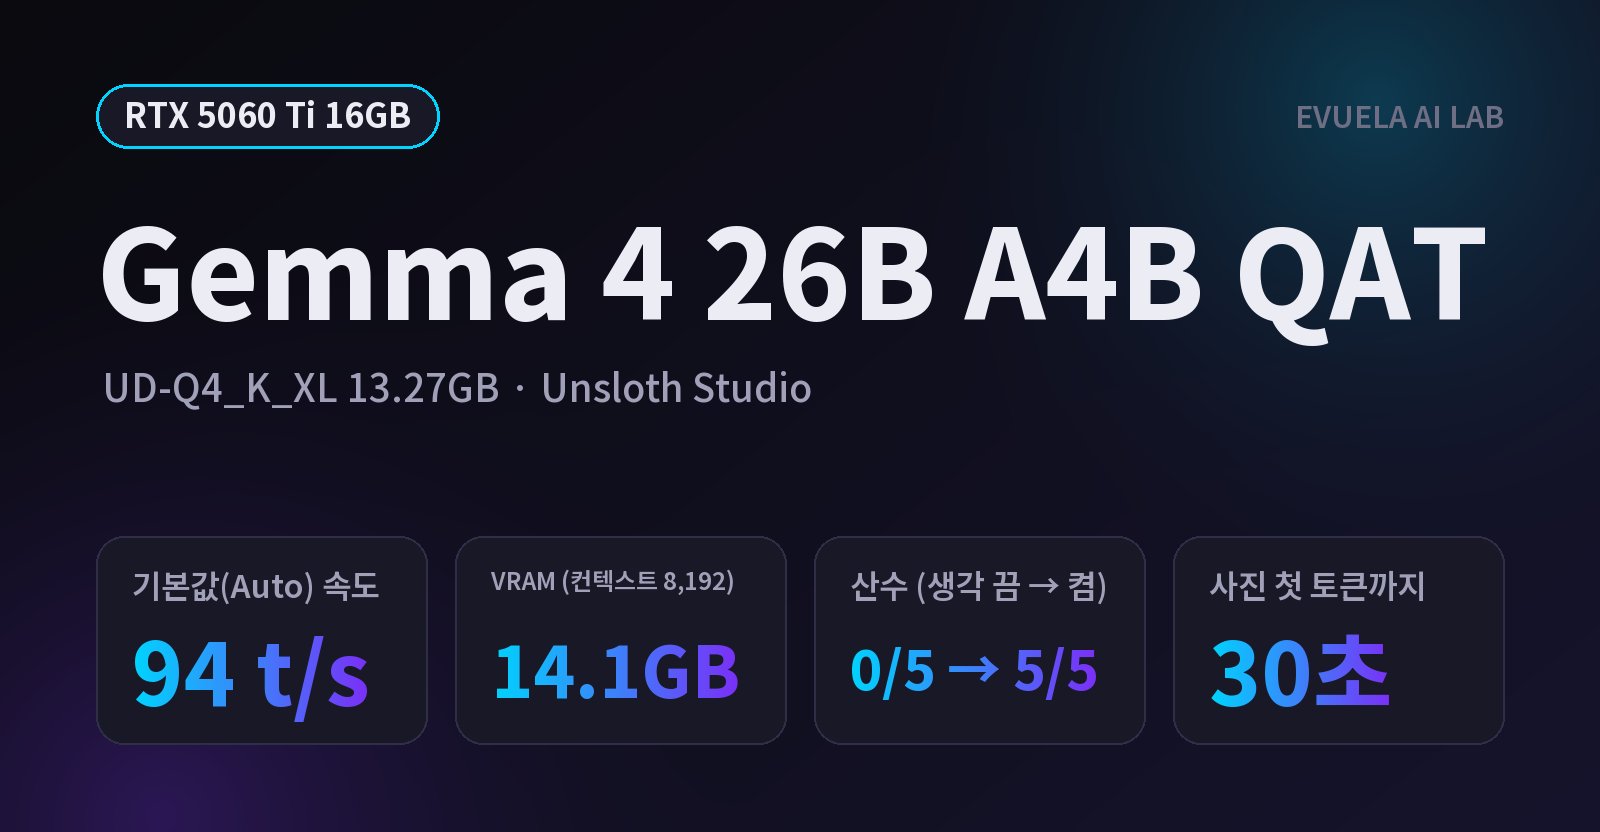
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
업스테이지 솔라 미니 4의 'GPU 1장 구동'을 공식 발표로 확인했습니다. 양자화한 모델이 H100 80GB 한 장에 올라간다는 뜻이고, 모델 파일은 공개되지 않았습니다. 같은 크기 공개 모델로 그래픽카드별 크기를 가늠했습니다.
Qwen-Image-2.1을 RTX 5090에서 Unsloth Studio 기본 설정으로 돌렸습니다. 1024×1024 한 장 7.6초, VRAM 21.0GB, 받은 파일 17.2GB였습니다. 한글 글자 정확도와 연구·평가용 라이선스도 정리했습니다.
RTX 5060 Ti 16GB에서 Ternary Bonsai 2 27B(PQ2_0)를 PrismML llama-server로 재 봤습니다. VRAM 9.3GB, 생성 속도 약 48t/s였고, 기본 생각 단계 xhigh는 800자 글에 4~7분, medium은 14~21초였습니다.