로컬 AI 시작하기 5편, Qwen3.8 27B·Gemma 4 설정은 무엇부터 바꿀까, 생각을 Low만 켜도 정답률이 73%에서 99%가 됐다
처음에 알아야 할 설정을 컨텍스트, 생각(Thinking), 온도 세 가지로 정리했습니다. Qwen3.8 27B는 생각을 Low만 켜도 정답률이 73%에서 99%가 됐고, 16GB에서는 컨텍스트를 숫자로 정하자 초당 약 52토큰이 약 94토큰이 됐습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"KV 캐시" 검색 결과 20건
처음에 알아야 할 설정을 컨텍스트, 생각(Thinking), 온도 세 가지로 정리했습니다. Qwen3.8 27B는 생각을 Low만 켜도 정답률이 73%에서 99%가 됐고, 16GB에서는 컨텍스트를 숫자로 정하자 초당 약 52토큰이 약 94토큰이 됐습니다.
모델을 고르는 순서를 VRAM, 컨텍스트, 쓰임새 세 가지로 정리했습니다. RTX 5060 Ti 16GB와 RTX 5090 32GB에서 잰 측정 16건의 파일 크기와 VRAM을 한 표에 모았고, 컨텍스트를 늘리면 VRAM과 속도가 어떻게 바뀌는지도 담았습니다.
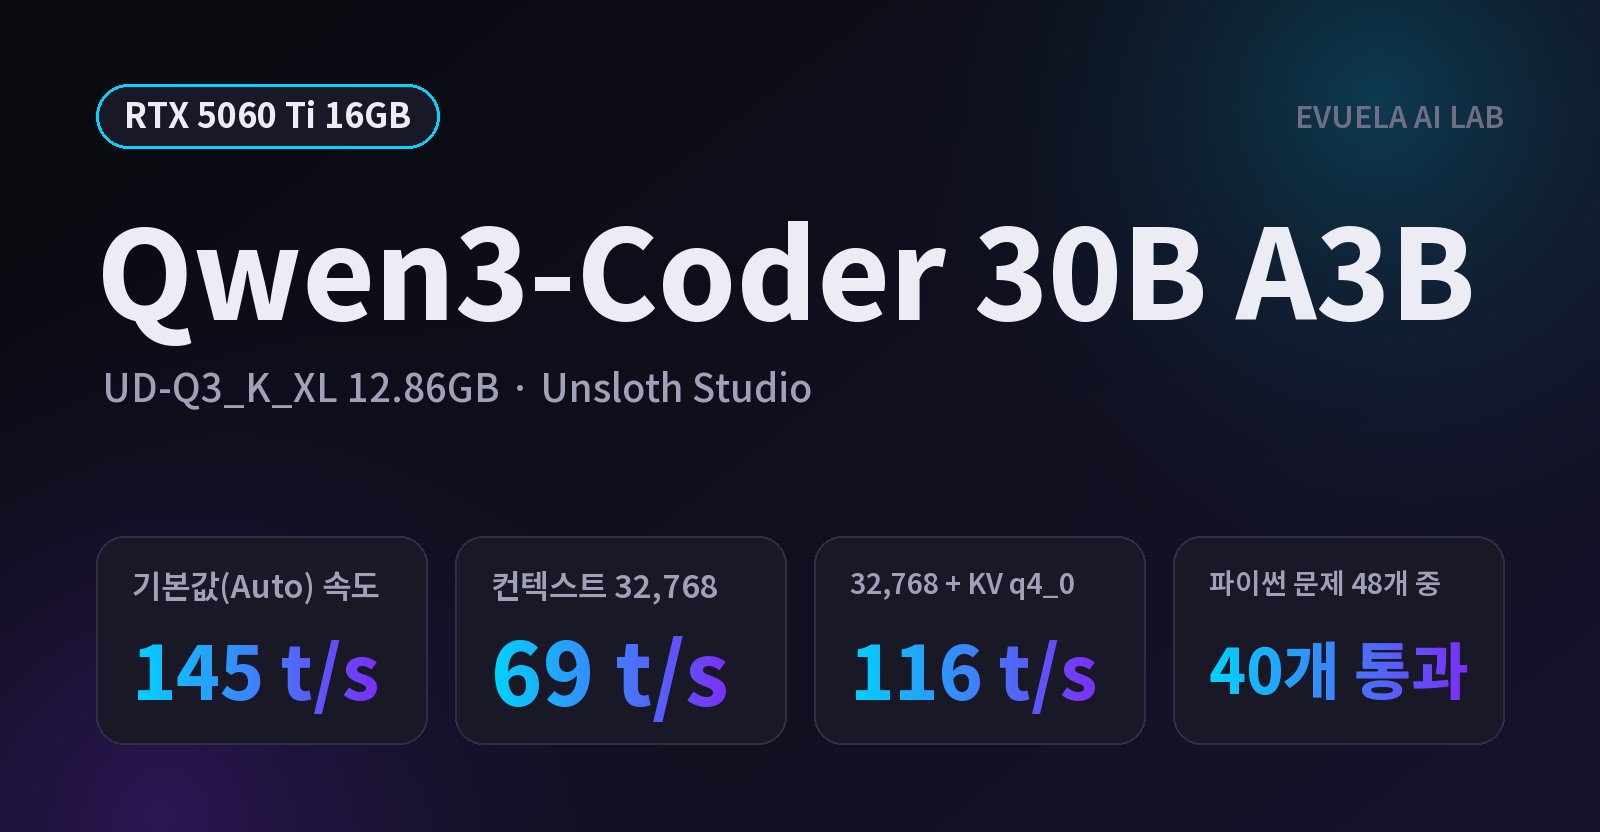
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
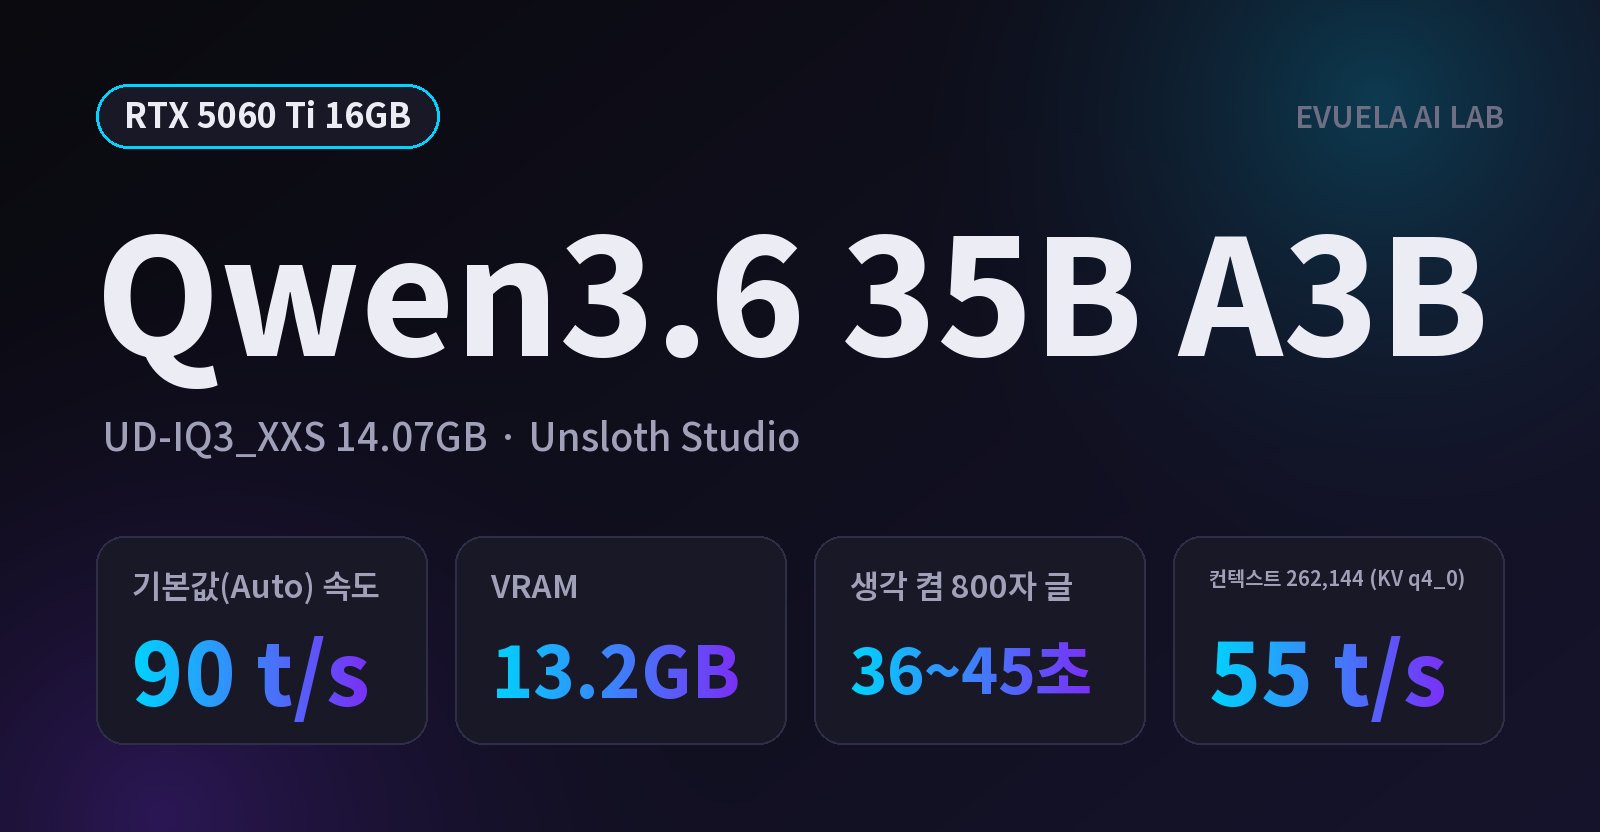
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3.6 35B A3B(UD-IQ3_XXS)를 기본값으로 돌렸습니다. VRAM 13.2GB에 다 들어갔고 초당 약 90토큰이었습니다. 컨텍스트별 속도, 설정 비교, Gemma 4 26B와의 비교를 담았습니다.
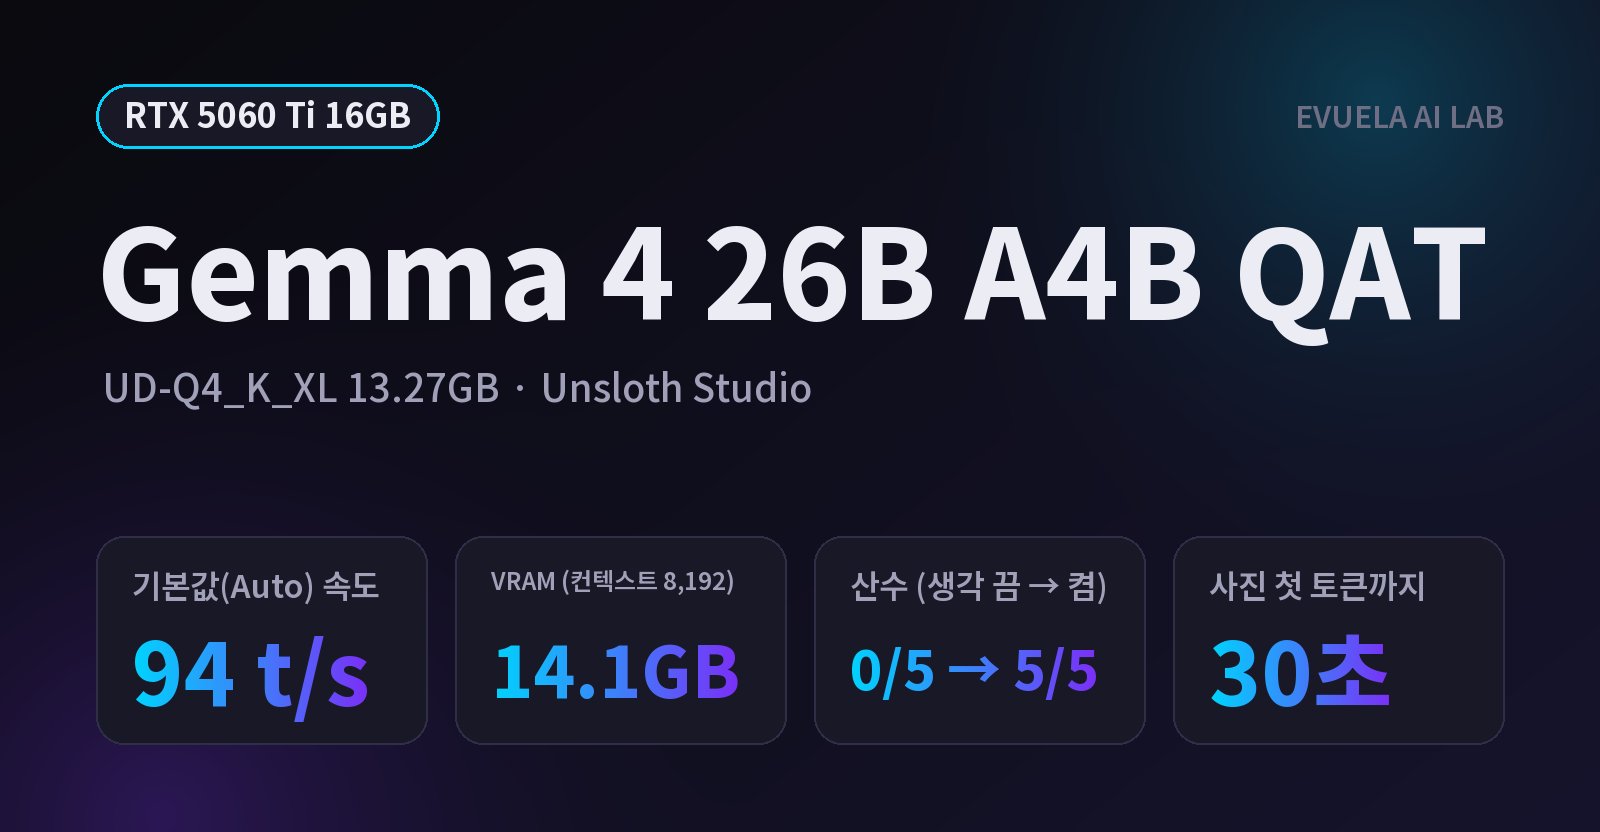
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
AMD Ryzen AI Max PRO 400 시리즈가 들어간 PC가 팔리기 시작했습니다. 통합 메모리 192GB 가운데 160GB를 AI 모델에 쓸 수 있고, AMD는 300B 모델까지 돌릴 수 있다고 밝혔습니다. 공식 발표를 정리하고, 직접 잰 Qwen3.8 27B 파일 크기와 RTX 5090 속도를 가져와 300B가 정말 들어가는지, 들어가면 얼마나 빠를지 계산했습니다. 제품 가격과 RTX 5090과의 차이도 함께 담았습니다.
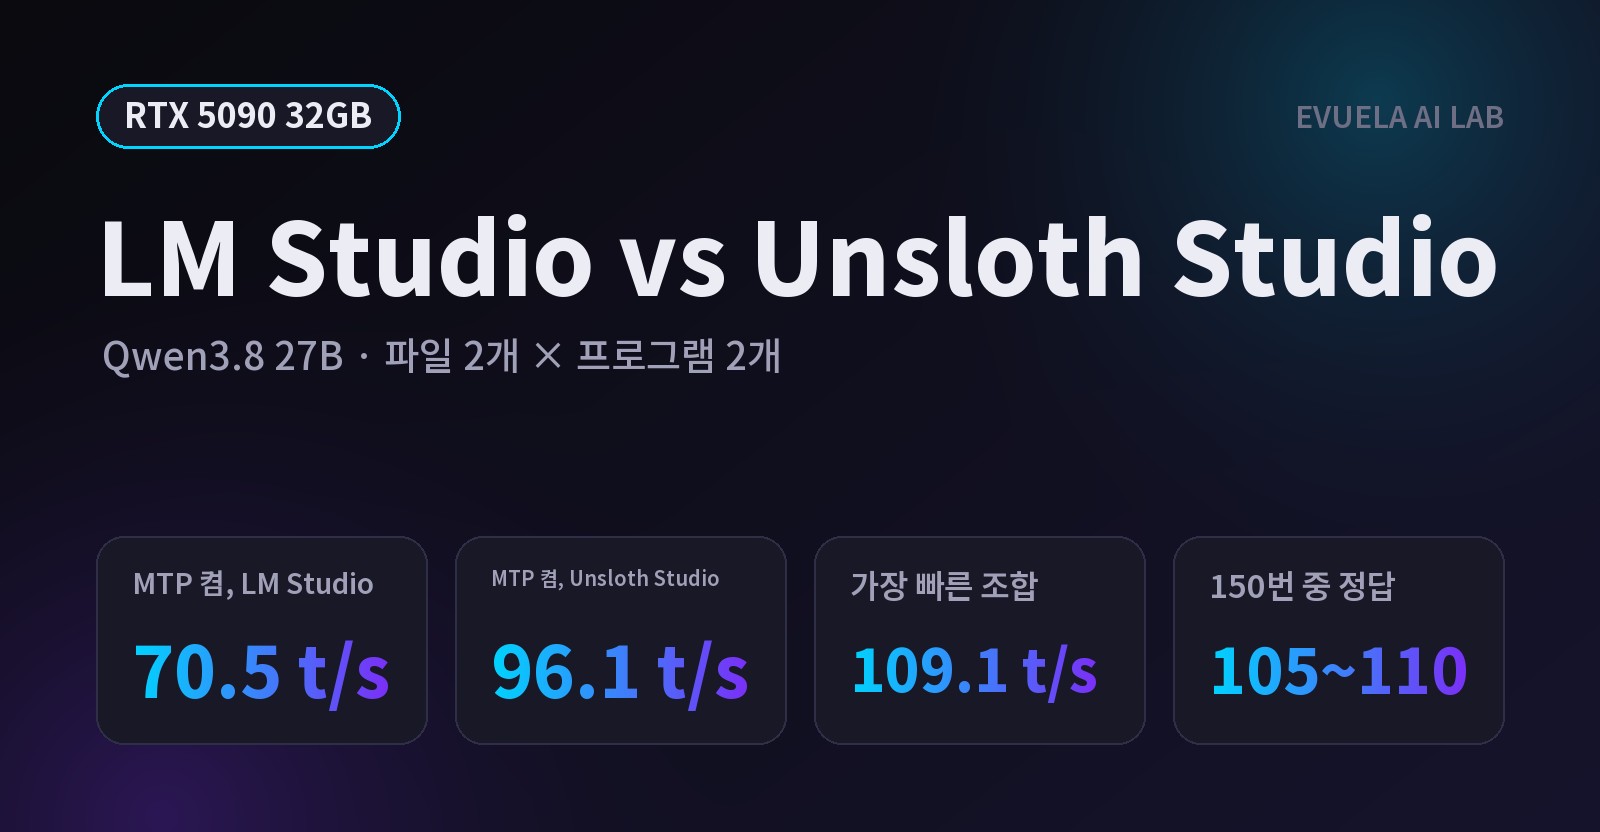
RTX 5090에서 Qwen3.8 27B 파일 두 개(lmstudio-community Q4_K_M, unsloth UD-Q4_K_XL)를 LM Studio와 Unsloth Studio에 차례로 올리고 설정을 똑같이 맞춰 쟀습니다. MTP를 끄면 두 프로그램의 속도가 거의 같았고, MTP를 켜면 Unsloth Studio가 35~36% 빨랐습니다. lmstudio-community 파일은 두 프로그램 모두에서 8~15% 더 빨랐고, 정답률은 네 조합이 같았습니다. 생각 설정의 차이와 두 프로그램 화면 캡처도 함께 정리했습니다.
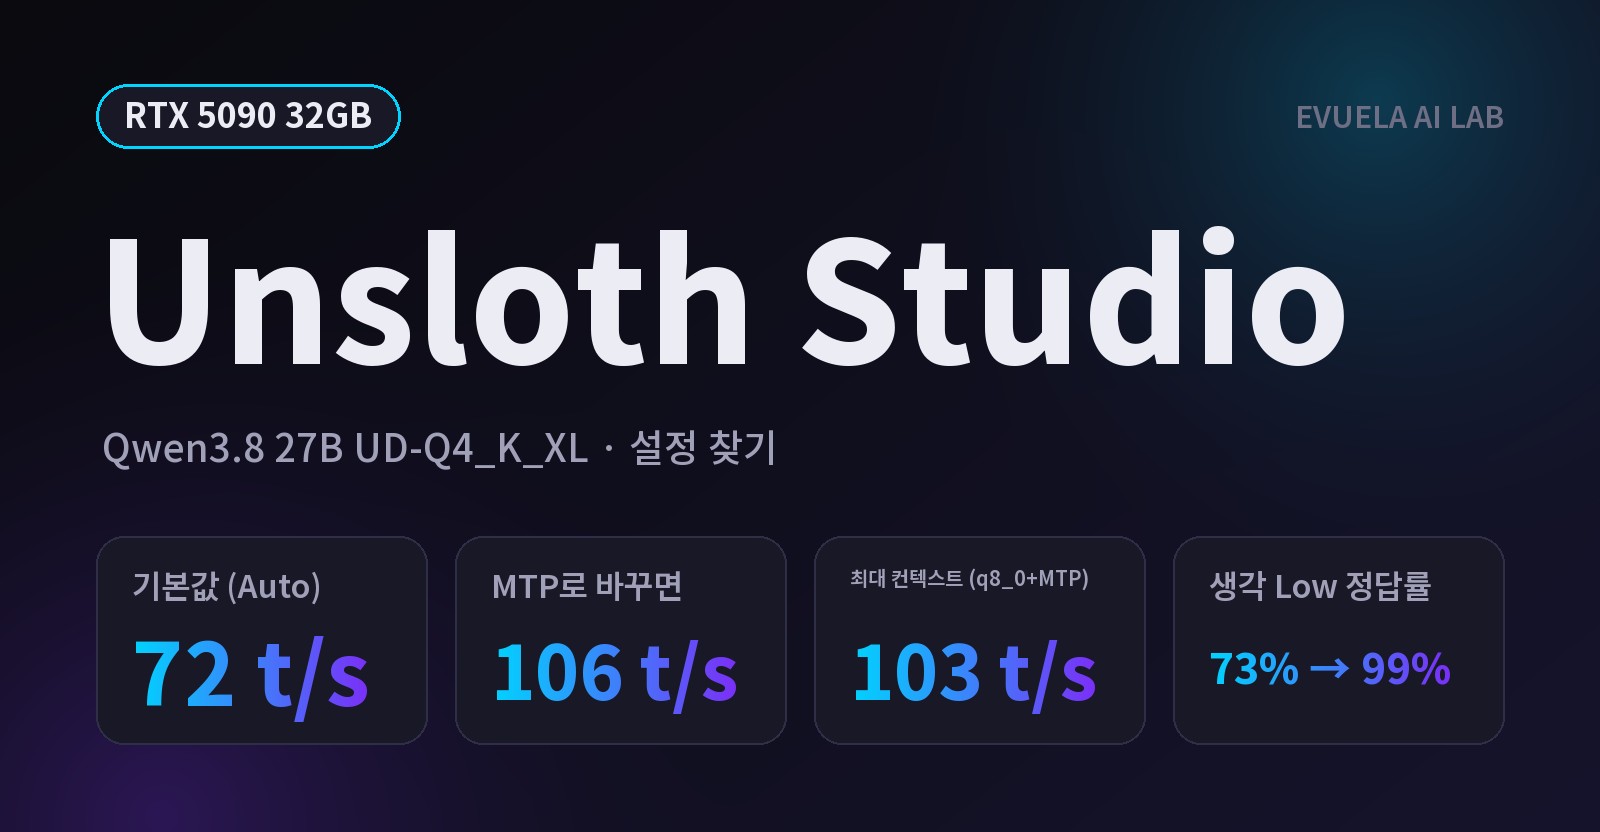
Unsloth Studio를 RTX 5090에 설치하고 Qwen3.8 27B(UD-Q4_K_XL)로 설정을 하나씩 바꿔 가며 쟀습니다. 기본값은 컨텍스트를 16만 8천 토큰으로 알아서 잡았고 초당 72토큰이었습니다. 속도 기능을 MTP로 바꾸면 48% 빨라졌고, KV 캐시를 q8_0으로 줄이면 최대 컨텍스트 262,144에서도 초당 103토큰이 나왔습니다. 생각 단계별 정답률, 화면 캡처, 쓰임새별 추천 설정을 정리했습니다.
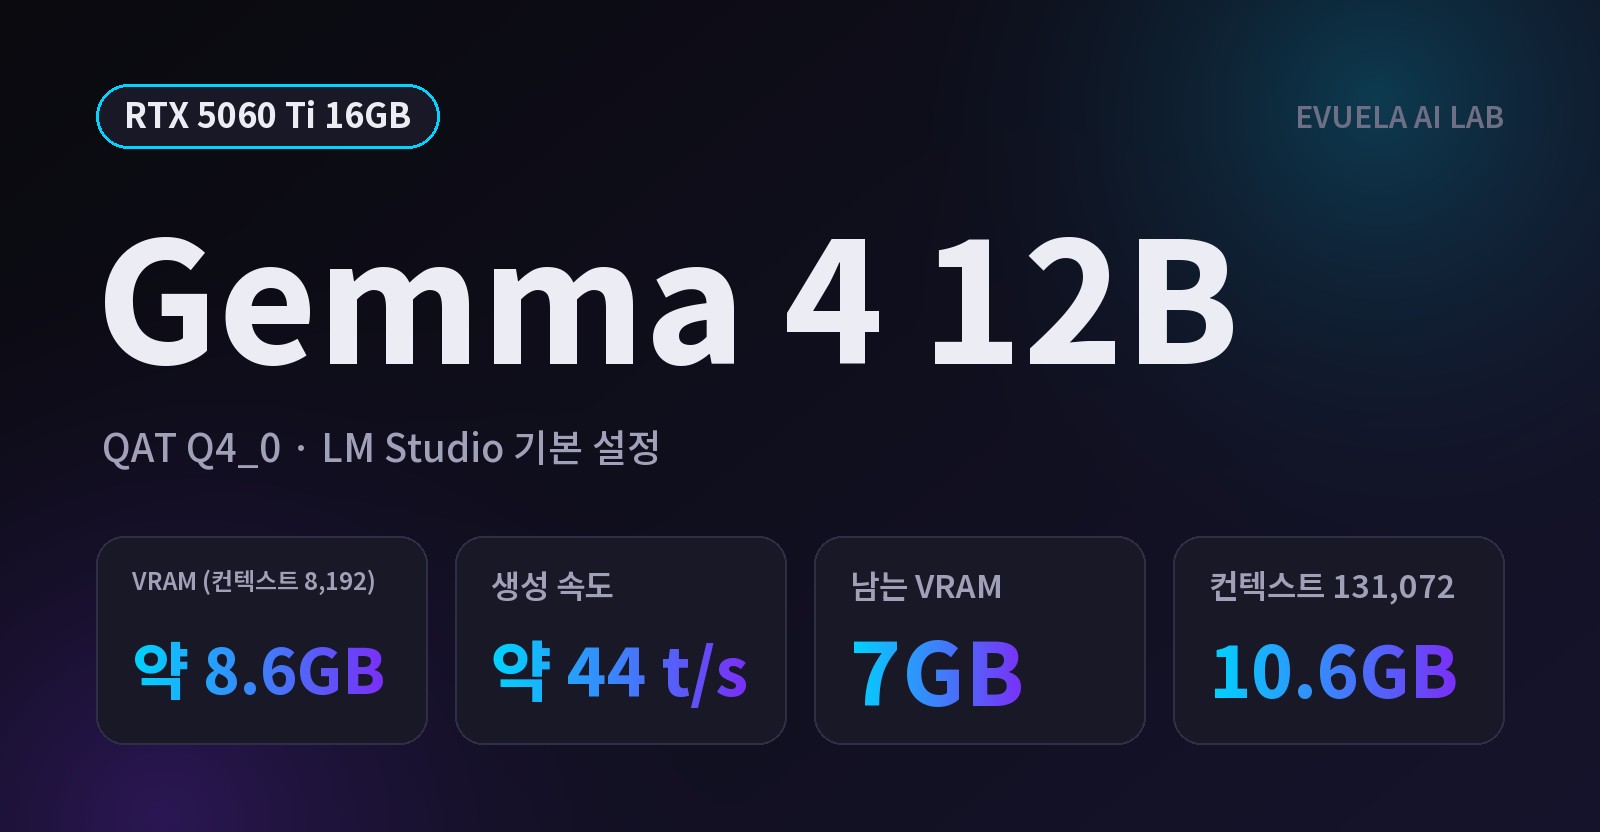
RTX 5060 Ti 16GB PC의 LM Studio에서 Gemma 4 12B QAT를 기본 설정 그대로 돌려 본 실측 기록입니다. 초당 약 44토큰, VRAM 약 8.6GB였고, 생각 기능을 끄면 산수를 5번 모두 틀렸습니다. 같은 방법으로 잰 RTX 5090 결과와 함께 비교합니다.