로컬 AI 시작하기 7편, 대화 다음에는 무엇을 해 볼까, Qwen-Image-2.1 그림 7.6초·LTX-2.5 영상 20초·VoiceStudio 음성 11초였다
대화에 익숙해진 다음에 해 볼 것을 코딩, 도구(MCP), API, 그림, 영상, 음성, 검색으로 정리했습니다. 그림 한 장 7.6초, 5초 영상 약 20초, 50초 음성 약 11초였고, 필요한 VRAM은 음성 3.5GB부터 영상 31.2GB까지 달랐습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"OpenAI" 검색 결과 22건
대화에 익숙해진 다음에 해 볼 것을 코딩, 도구(MCP), API, 그림, 영상, 음성, 검색으로 정리했습니다. 그림 한 장 7.6초, 5초 영상 약 20초, 50초 음성 약 11초였고, 필요한 VRAM은 음성 3.5GB부터 영상 31.2GB까지 달랐습니다.
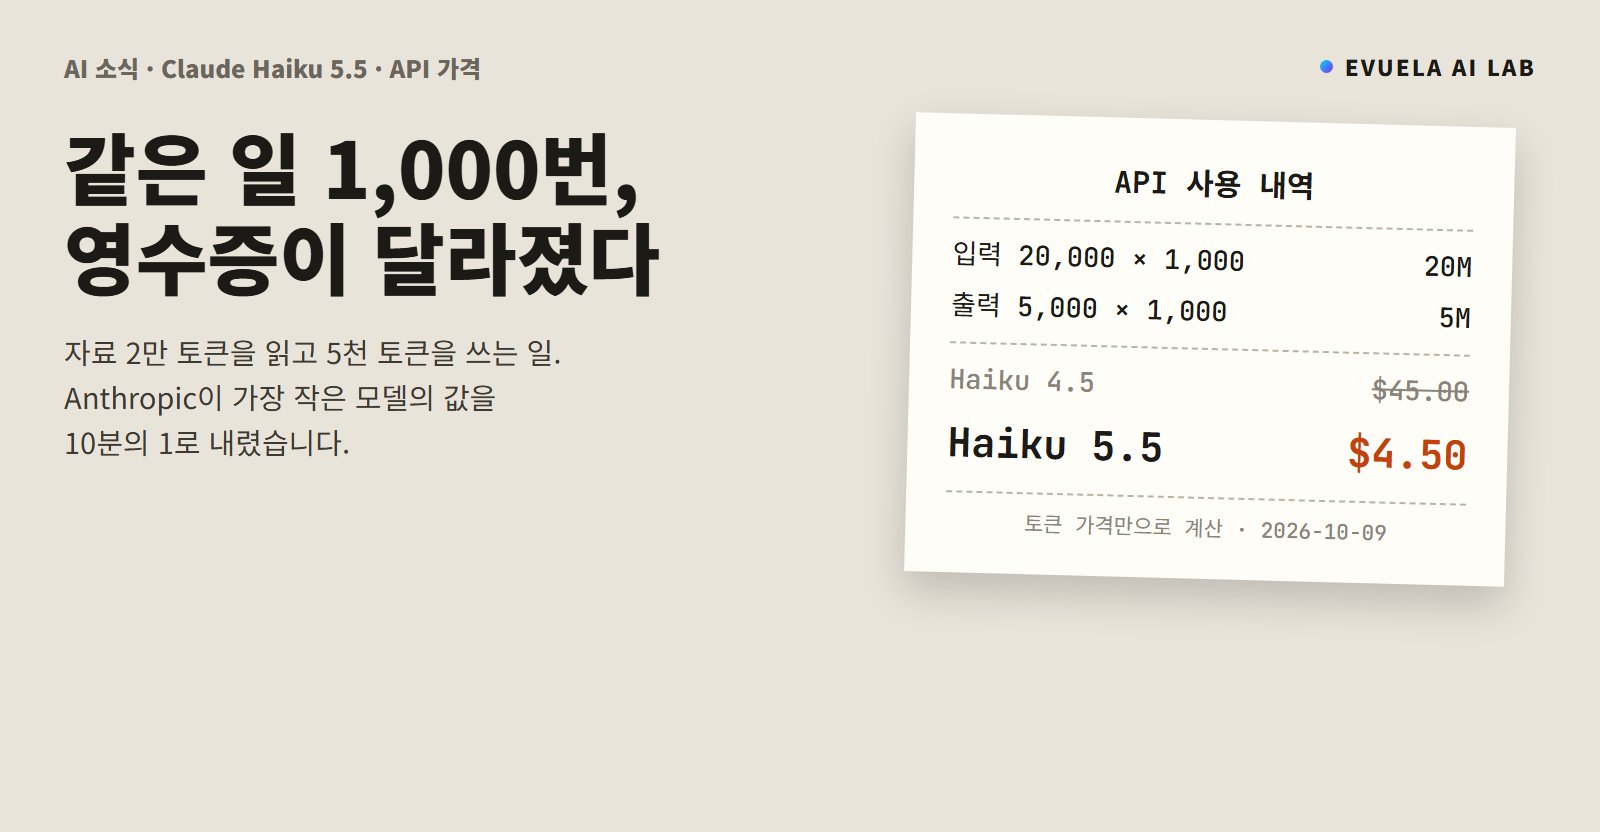
Anthropic이 10월 7일 Claude Haiku 5.5를 냈습니다. 입력 100만 토큰 0.10달러, 출력 0.50달러로 Haiku 4.5의 10분의 1이고 GPT-6 Luna와 같습니다. 프롬프트가 10만 토큰을 넘으면 값이 다섯 배가 되는 규칙과 로컬 AI 전기요금 비교까지 계산했습니다.
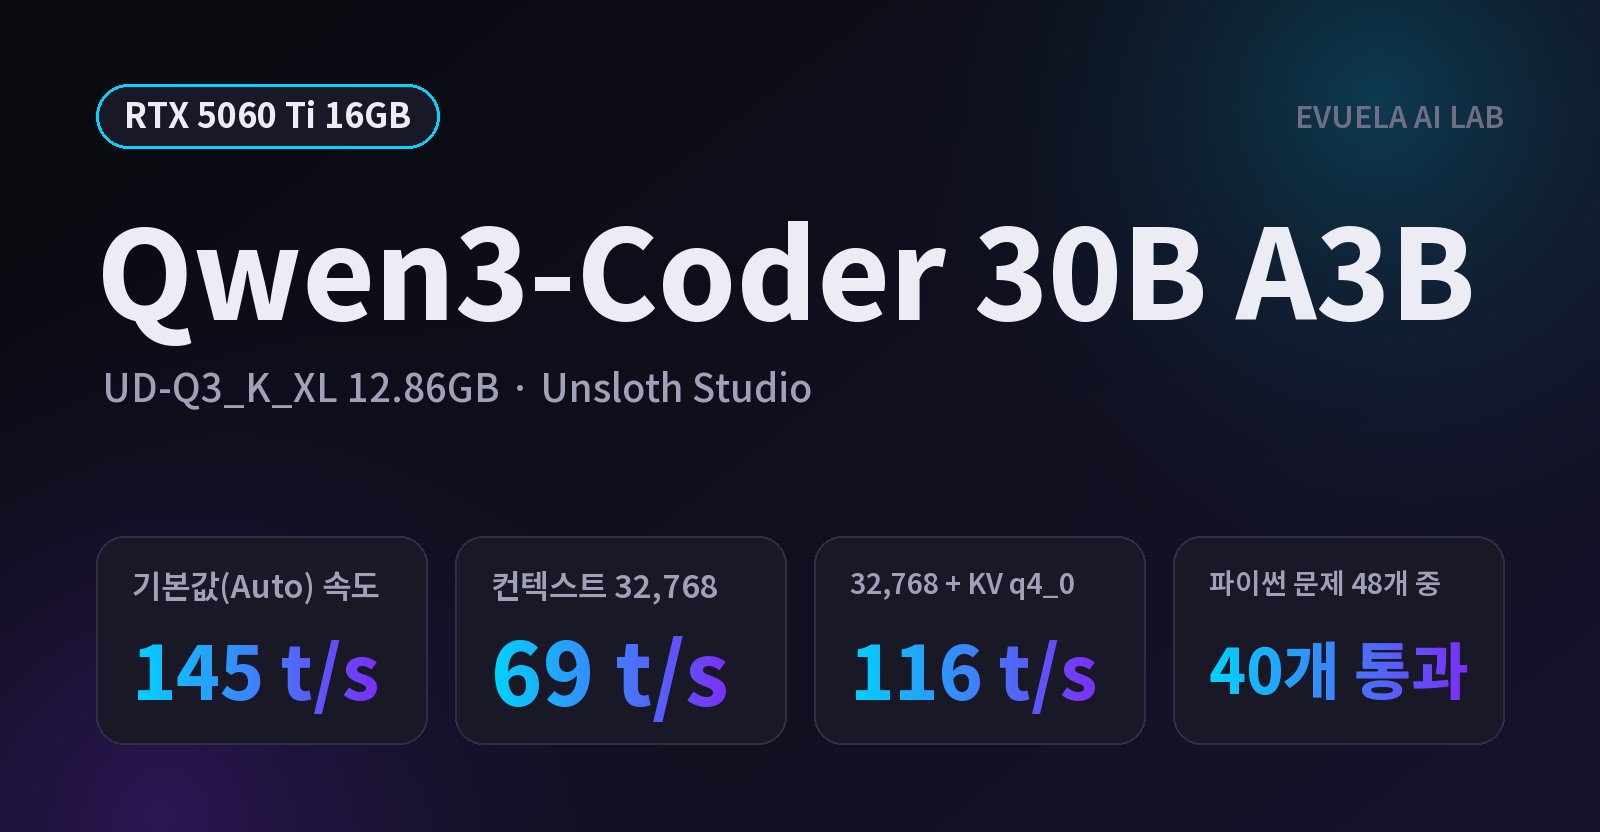
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
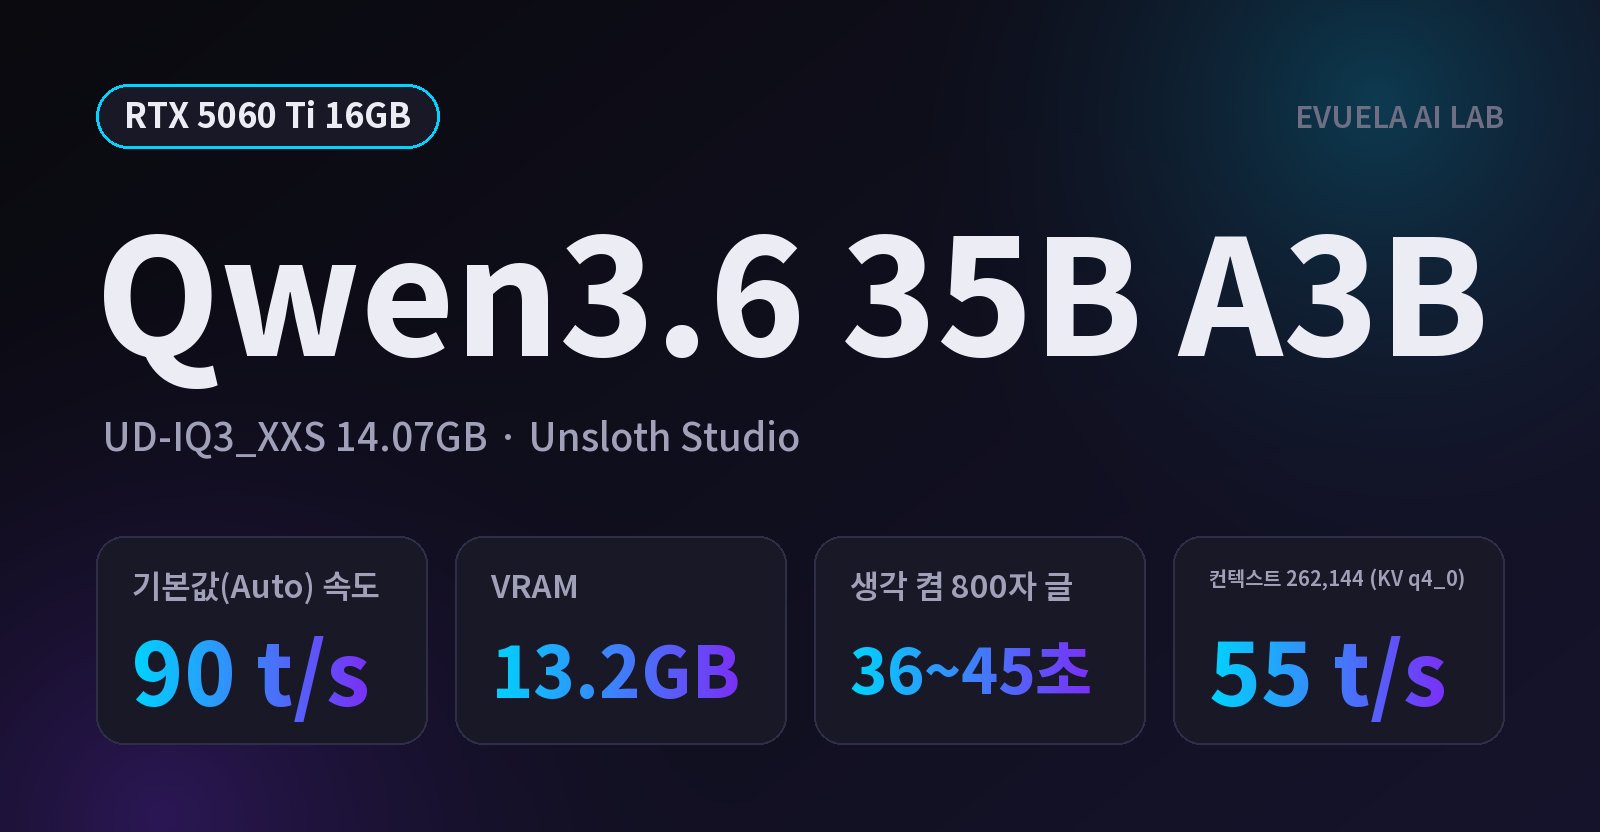
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3.6 35B A3B(UD-IQ3_XXS)를 기본값으로 돌렸습니다. VRAM 13.2GB에 다 들어갔고 초당 약 90토큰이었습니다. 컨텍스트별 속도, 설정 비교, Gemma 4 26B와의 비교를 담았습니다.
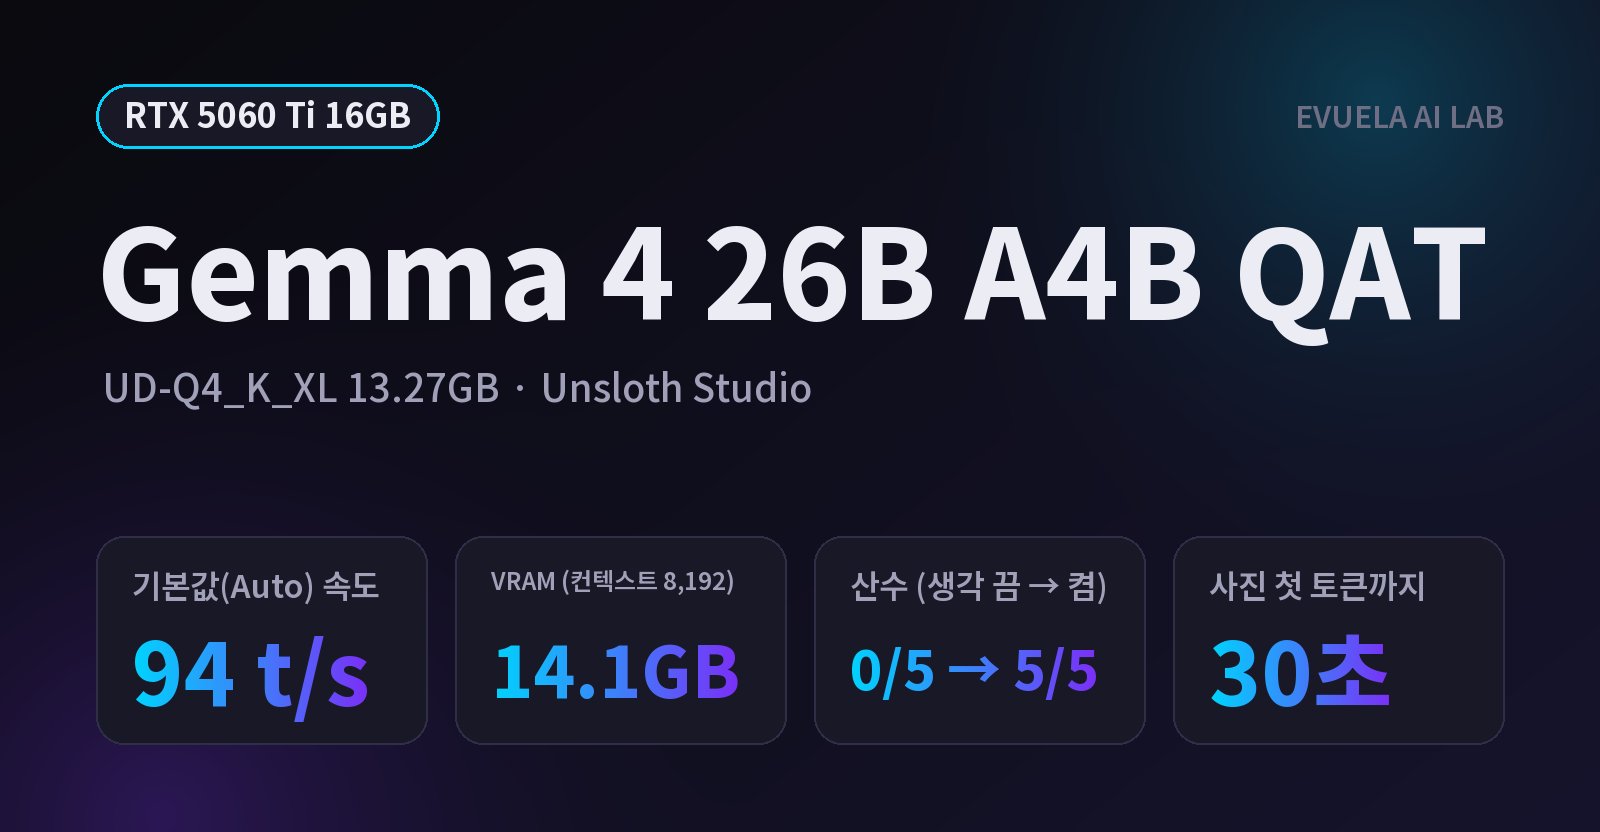
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
같은 Qwen3.8 27B 파일로 LM Studio와 Unsloth Studio를 비교했습니다. 기본값 속도는 65.4 대 65.6 t/s로 같았고, MTP를 켜면 35~44% 빨랐습니다. 생각 한도, 컨텍스트, 조심할 점과 앞으로의 측정 방법을 정리했습니다.
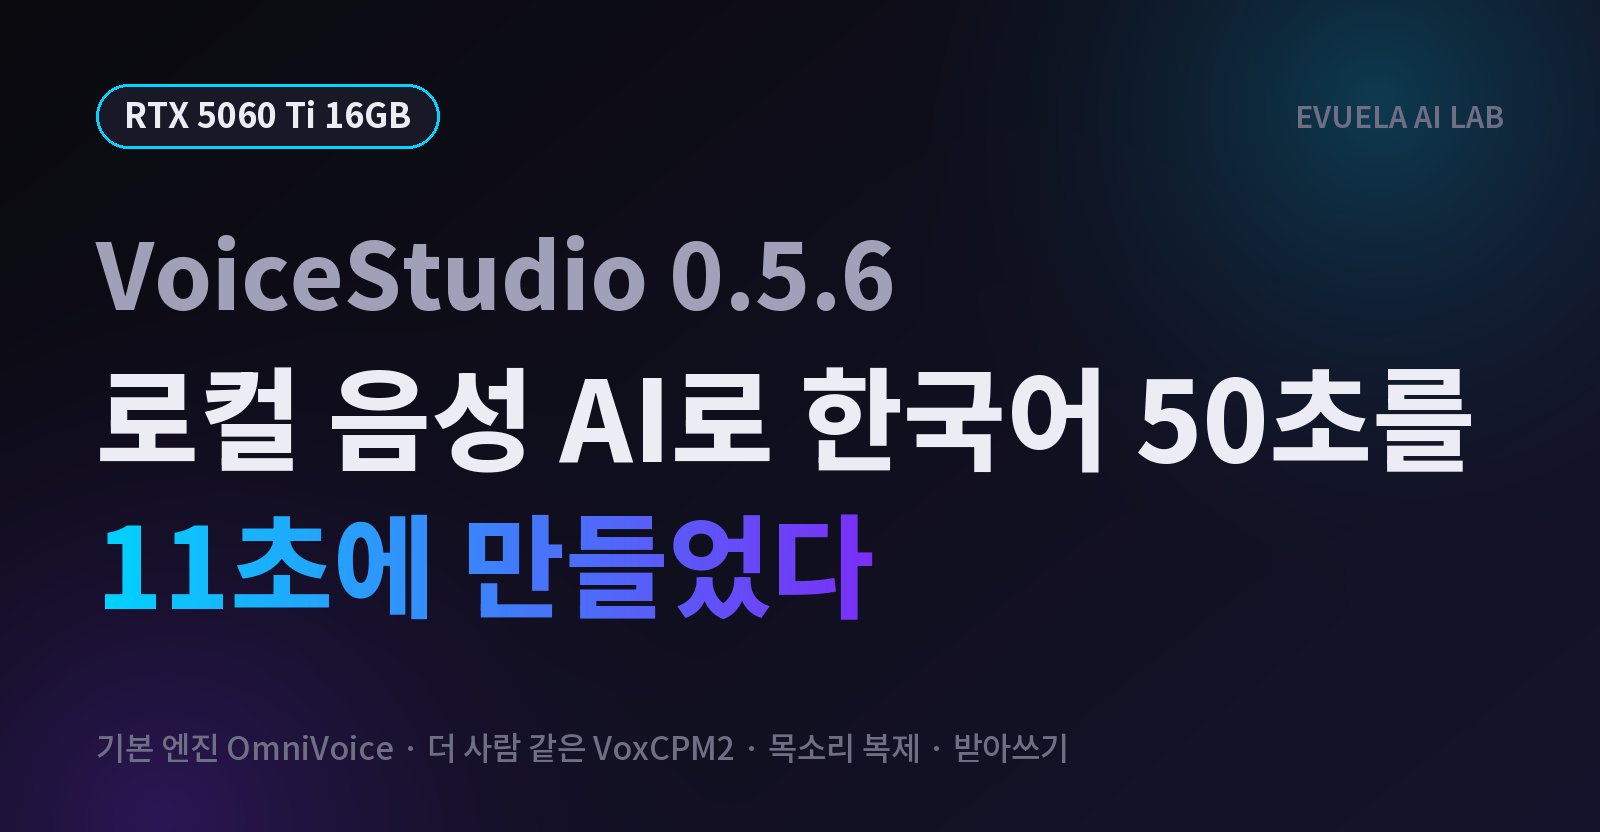
RTX 5060 Ti 16GB에 로컬 음성 AI VoiceStudio 0.5.6을 직접 설치해 한국어로 써 봤습니다. 기본 엔진 OmniVoice는 50초 음성을 약 11초에 만들었고 VRAM은 3.5GB 안쪽, 더 사람 같았던 VoxCPM2는 2분 넘게 걸렸습니다.
Perplexity가 판단 모델 pplx-decider-v1-27b를 Apache 2.0으로 공개했습니다. 글 대신 확률로 답하고, 11가지 시험에서 바탕 모델 Qwen3.8 27B보다 약 11%포인트 높았습니다. 요금 계산과 RTX 5090·16GB 그래픽카드에서 돌릴 수 있는지도 정리했습니다.
구글이 새 최고 모델 Gemini 4 Argon을 발표했습니다. 출력 한도가 6만 4천 토큰에서 100만 토큰으로 늘었고, 도입 가격은 100만 토큰당 입력 2달러, 출력 10달러입니다. 하지만 지금은 정부·병원·통신사 같은 보안 담당 기관 650여 곳만 쓸 수 있습니다. 공식 발표문으로 출력 100만 토큰이 한글로 얼마나 되는지, 왜 순서를 나눠 공개하는지, 구글이 밝힌 시험 점수와 가격을 정리했습니다.