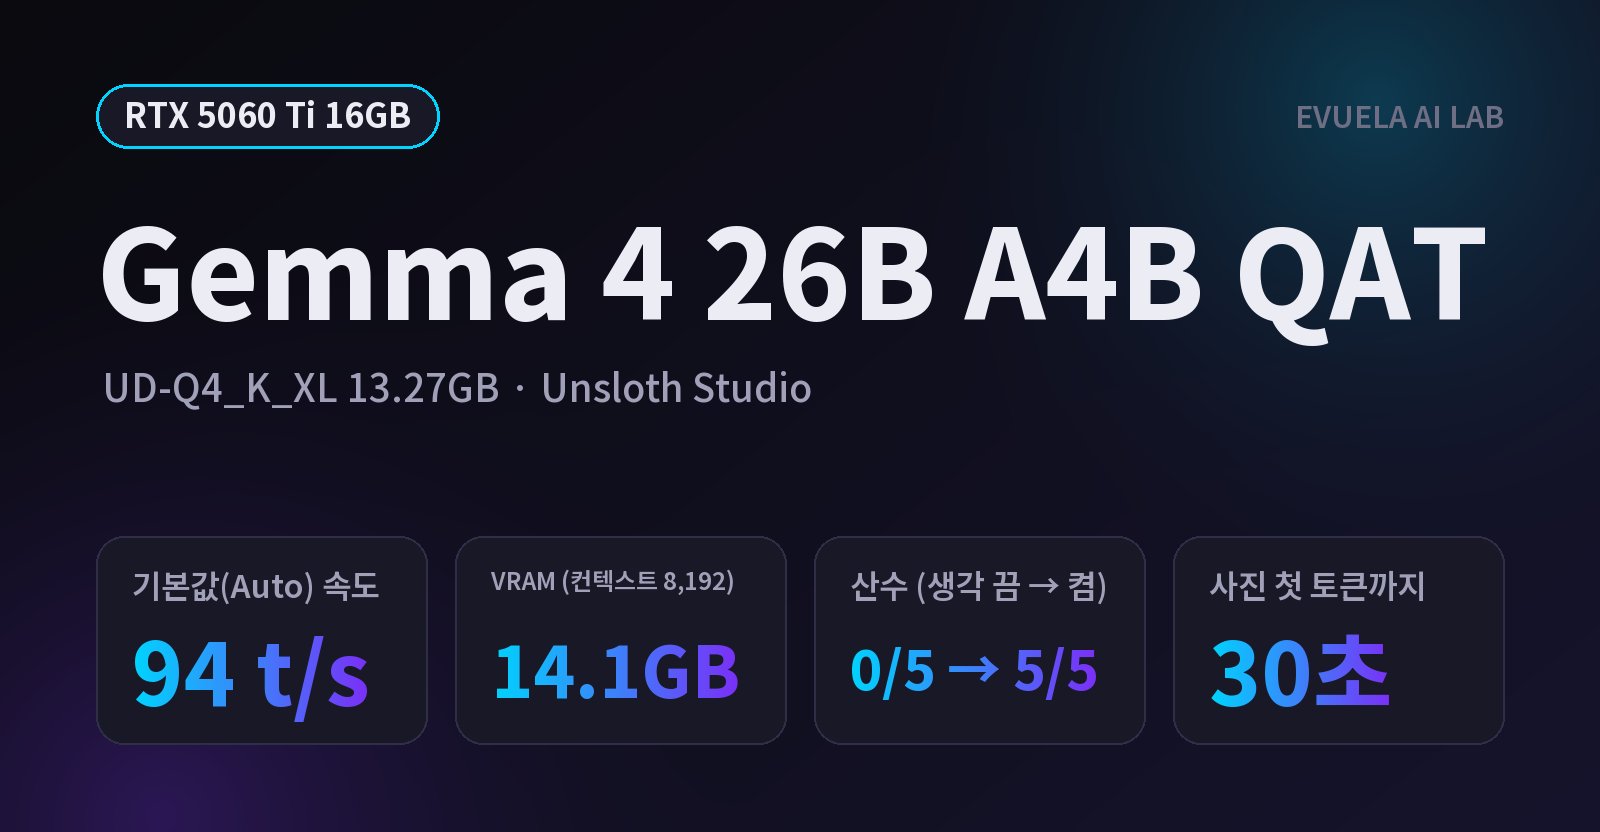
[RTX 5060 Ti 16GB] 16GB 그래픽카드에서 Gemma 4 26B는 얼마나 빠를까, Unsloth Studio 기본값으로 초당 94토큰이었다
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"AI 모델" 검색 결과 46건
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
같은 Qwen3.8 27B 파일로 LM Studio와 Unsloth Studio를 비교했습니다. 기본값 속도는 65.4 대 65.6 t/s로 같았고, MTP를 켜면 35~44% 빨랐습니다. 생각 한도, 컨텍스트, 조심할 점과 앞으로의 측정 방법을 정리했습니다.
GitLab이 AI Gateway의 치명적 취약점 CVE-2026-90970(CVSS 9.9)을 고쳤습니다. 로그인한 사용자가 서버 명령을 실행할 수 있었습니다. 직접 설치한 곳만 해당되는지 확인하는 순서와 올릴 버전, 로컬 AI 서버에 주는 교훈을 정리했습니다.
GitHub 스타 3만 개를 받은 무료 화면 녹화·편집 앱 Recordly를 직접 설치해 써 봤습니다. 녹화, 자동 확대, 커서 효과, MP4·GIF 내보내기를 확인했고, 77초 1080p 영상은 약 12초 만에 내보냈습니다. 창 녹화 주의점과 녹화 중 로컬 AI 속도도 정리했습니다.
RTX 5060 Ti 16GB에 로컬 음성 AI VoiceStudio 0.5.6을 직접 설치해 한국어로 써 봤습니다. 기본 엔진 OmniVoice는 50초 음성을 약 11초에 만들었고 VRAM은 3.5GB 안쪽, 더 사람 같았던 VoxCPM2는 2분 넘게 걸렸습니다.
RTX 5060 Ti 16GB에서 Ternary Bonsai 2 27B(PQ2_0)를 PrismML llama-server로 재 봤습니다. VRAM 9.3GB, 생성 속도 약 48t/s였고, 기본 생각 단계 xhigh는 800자 글에 4~7분, medium은 14~21초였습니다.
Perplexity가 판단 모델 pplx-decider-v1-27b를 Apache 2.0으로 공개했습니다. 글 대신 확률로 답하고, 11가지 시험에서 바탕 모델 Qwen3.8 27B보다 약 11%포인트 높았습니다. 요금 계산과 RTX 5090·16GB 그래픽카드에서 돌릴 수 있는지도 정리했습니다.
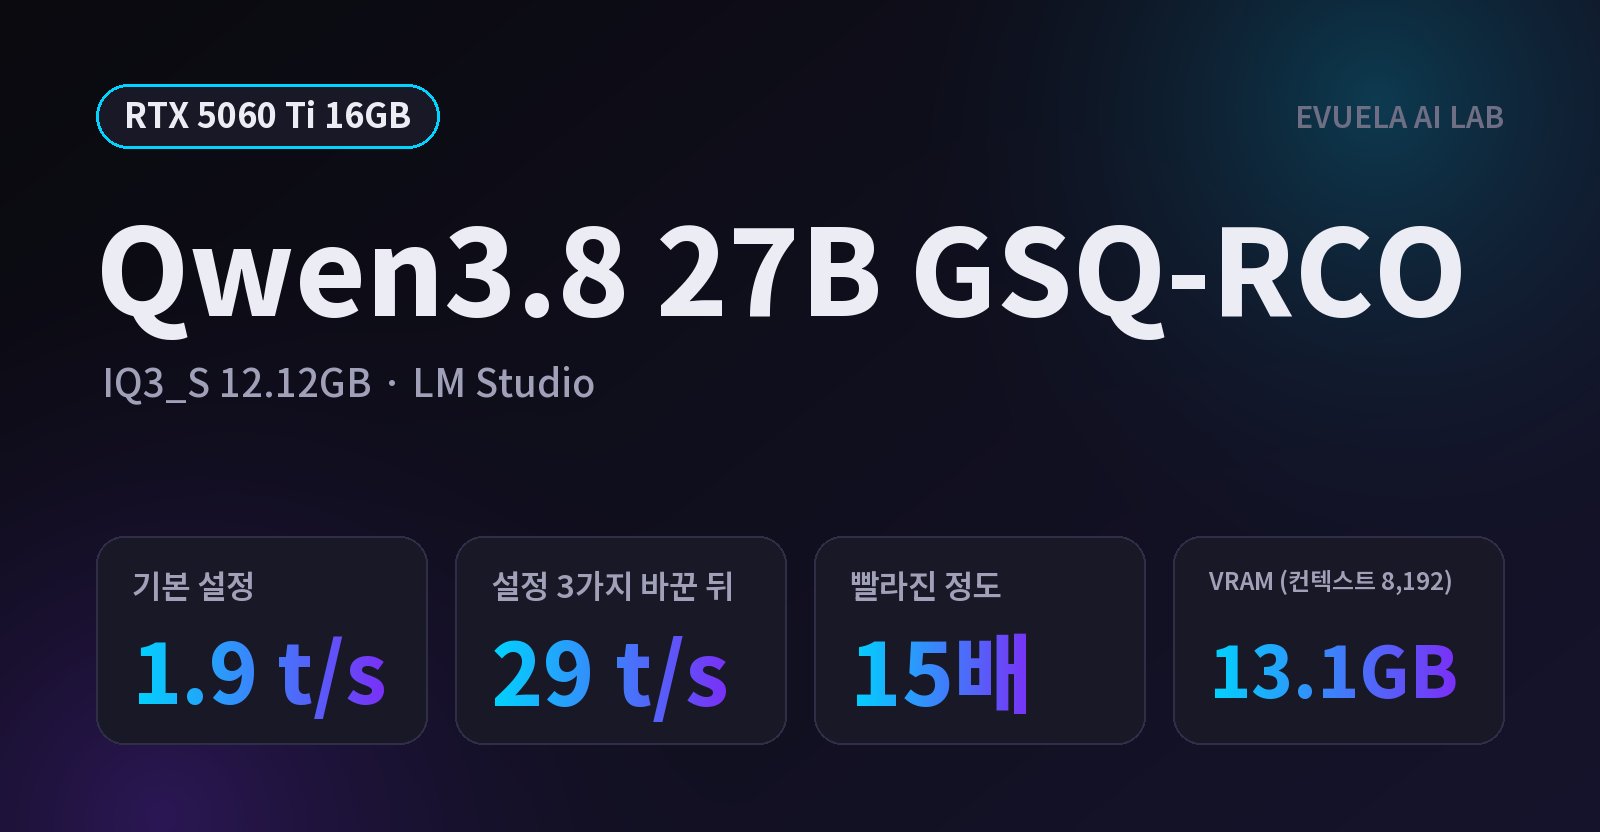
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.8 27B GSQ-RCO(IQ3_S, 12.12GB)를 재 봤습니다. 기본 설정에서는 65개 레이어 중 56~58개만 GPU에 올라가 약 1.9t/s였고, Limit Model Offload 끄기·GPU 오프로드 최대·MTP 끄기 세 가지를 바꾸자 약 29t/s가 됐습니다. VRAM은 13.1GB, 컨텍스트는 32,768까지 맞았습니다.
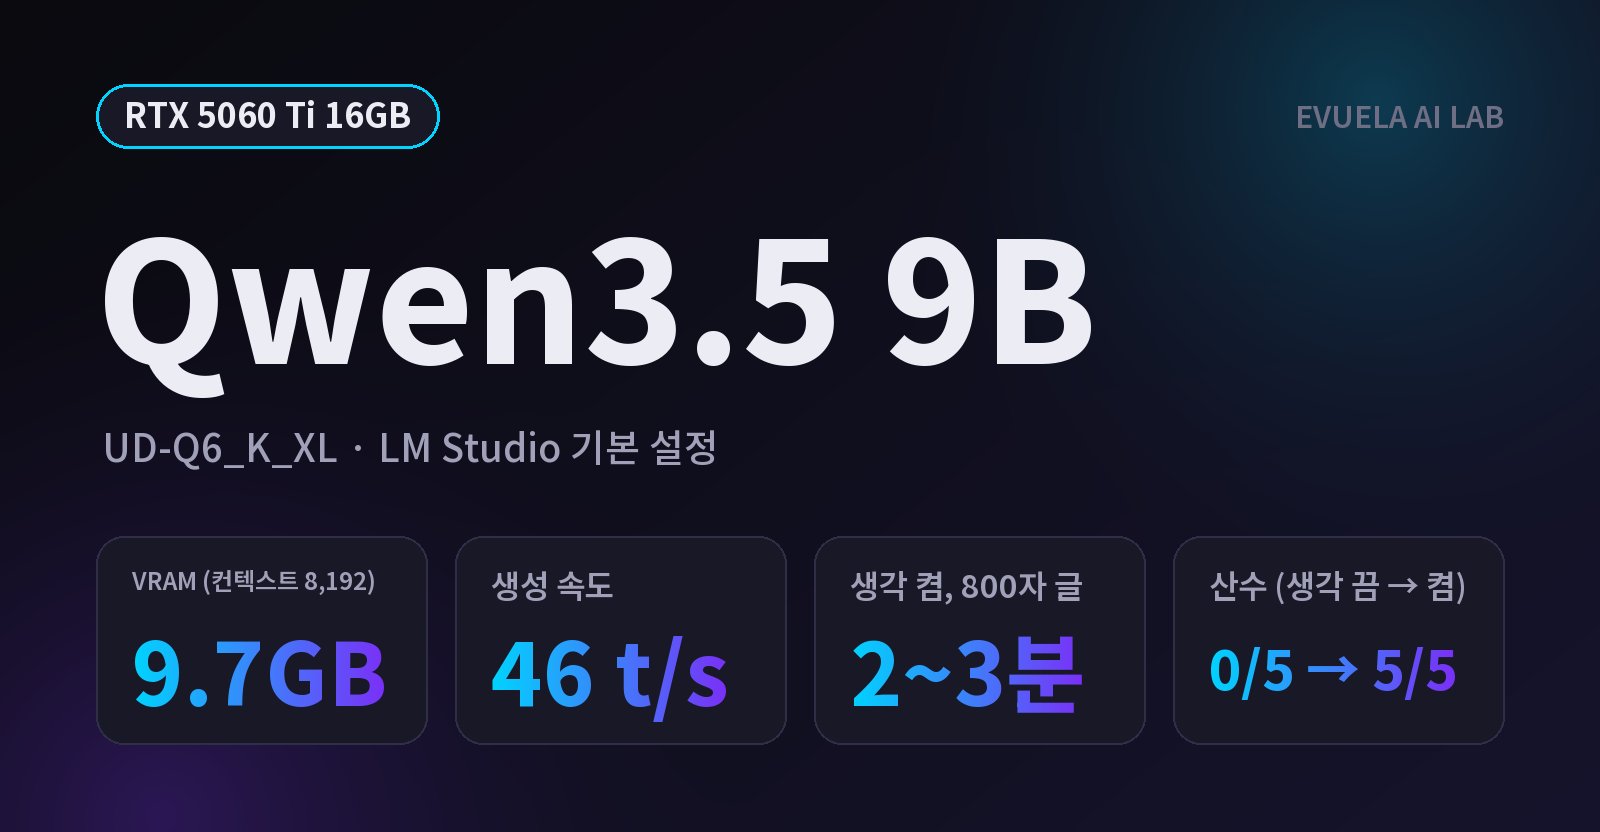
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.5 9B(UD-Q6_K_XL)를 기본 설정으로 재 봤습니다. VRAM 9.7GB, 약 46t/s였고 컨텍스트 131,072까지 VRAM에 다 들어갔습니다. 생각을 켜면 산수는 5번 모두 맞았지만 800자 글에 2~3분이 걸렸습니다. Ornith 1.5 9B와도 비교했습니다.