[RTX 5060 Ti 16GB] 16GB 그래픽카드에서 Gemma 4 26B는 얼마나 빠를까, Unsloth Studio 기본값으로 초당 94토큰이었다
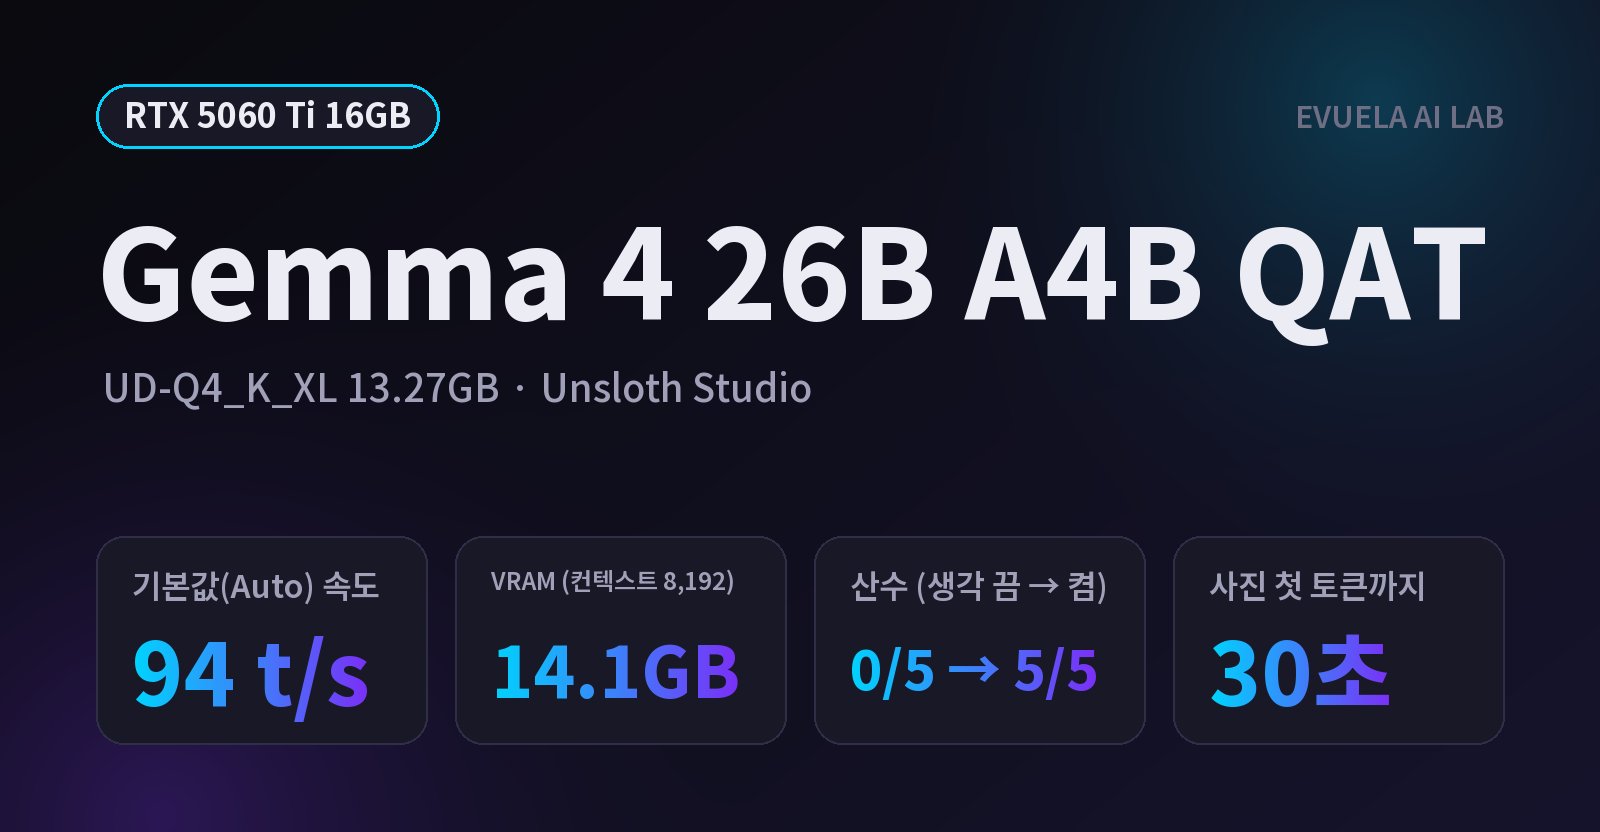
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Unsloth Studio" 검색 결과 37건
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
업스테이지 솔라 미니 4의 'GPU 1장 구동'을 공식 발표로 확인했습니다. 양자화한 모델이 H100 80GB 한 장에 올라간다는 뜻이고, 모델 파일은 공개되지 않았습니다. 같은 크기 공개 모델로 그래픽카드별 크기를 가늠했습니다.
영상 생성 모델 LTX-2.5를 RTX 5090에서 ComfyUI로 돌렸습니다. 소리가 든 5초 영상(1280×704)이 약 20초, 풀HD는 50.5초, VRAM은 31.2GB였습니다. 한국어 대사와 한국에서 써도 되는 라이선스도 정리했습니다.
Qwen-Image-2.1을 RTX 5090에서 Unsloth Studio 기본 설정으로 돌렸습니다. 1024×1024 한 장 7.6초, VRAM 21.0GB, 받은 파일 17.2GB였습니다. 한글 글자 정확도와 연구·평가용 라이선스도 정리했습니다.
같은 Qwen3.8 27B 파일로 LM Studio와 Unsloth Studio를 비교했습니다. 기본값 속도는 65.4 대 65.6 t/s로 같았고, MTP를 켜면 35~44% 빨랐습니다. 생각 한도, 컨텍스트, 조심할 점과 앞으로의 측정 방법을 정리했습니다.
GitLab이 AI Gateway의 치명적 취약점 CVE-2026-90970(CVSS 9.9)을 고쳤습니다. 로그인한 사용자가 서버 명령을 실행할 수 있었습니다. 직접 설치한 곳만 해당되는지 확인하는 순서와 올릴 버전, 로컬 AI 서버에 주는 교훈을 정리했습니다.
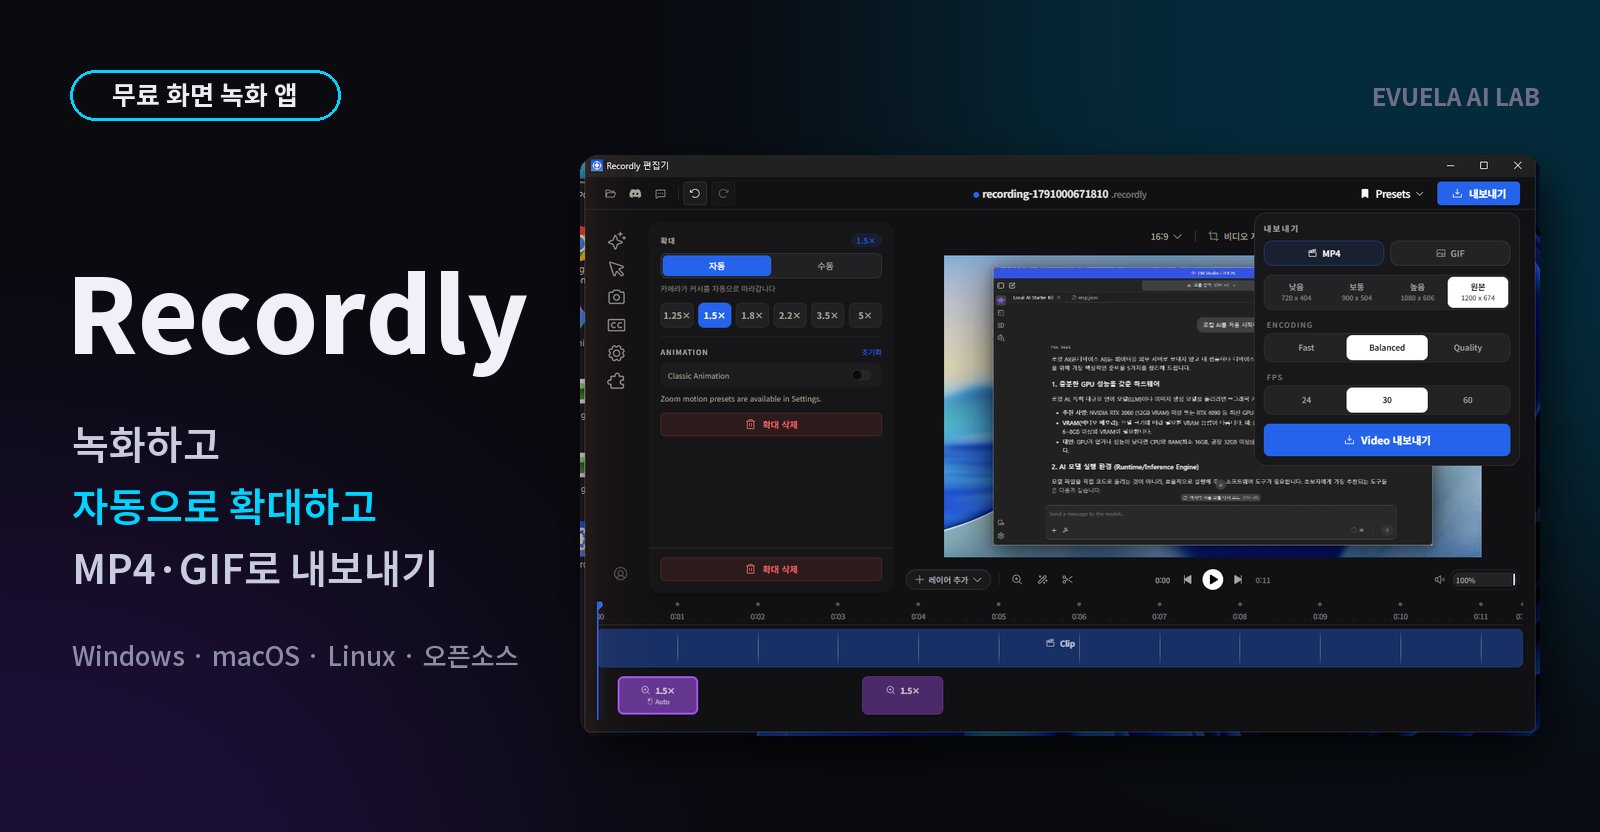
GitHub 스타 3만 개를 받은 무료 화면 녹화·편집 앱 Recordly를 직접 설치해 써 봤습니다. 녹화, 자동 확대, 커서 효과, MP4·GIF 내보내기를 확인했고, 77초 1080p 영상은 약 12초 만에 내보냈습니다. 창 녹화 주의점과 녹화 중 로컬 AI 속도도 정리했습니다.
AMD Ryzen AI Max PRO 400 시리즈가 들어간 PC가 팔리기 시작했습니다. 통합 메모리 192GB 가운데 160GB를 AI 모델에 쓸 수 있고, AMD는 300B 모델까지 돌릴 수 있다고 밝혔습니다. 공식 발표를 정리하고, 직접 잰 Qwen3.8 27B 파일 크기와 RTX 5090 속도를 가져와 300B가 정말 들어가는지, 들어가면 얼마나 빠를지 계산했습니다. 제품 가격과 RTX 5090과의 차이도 함께 담았습니다.
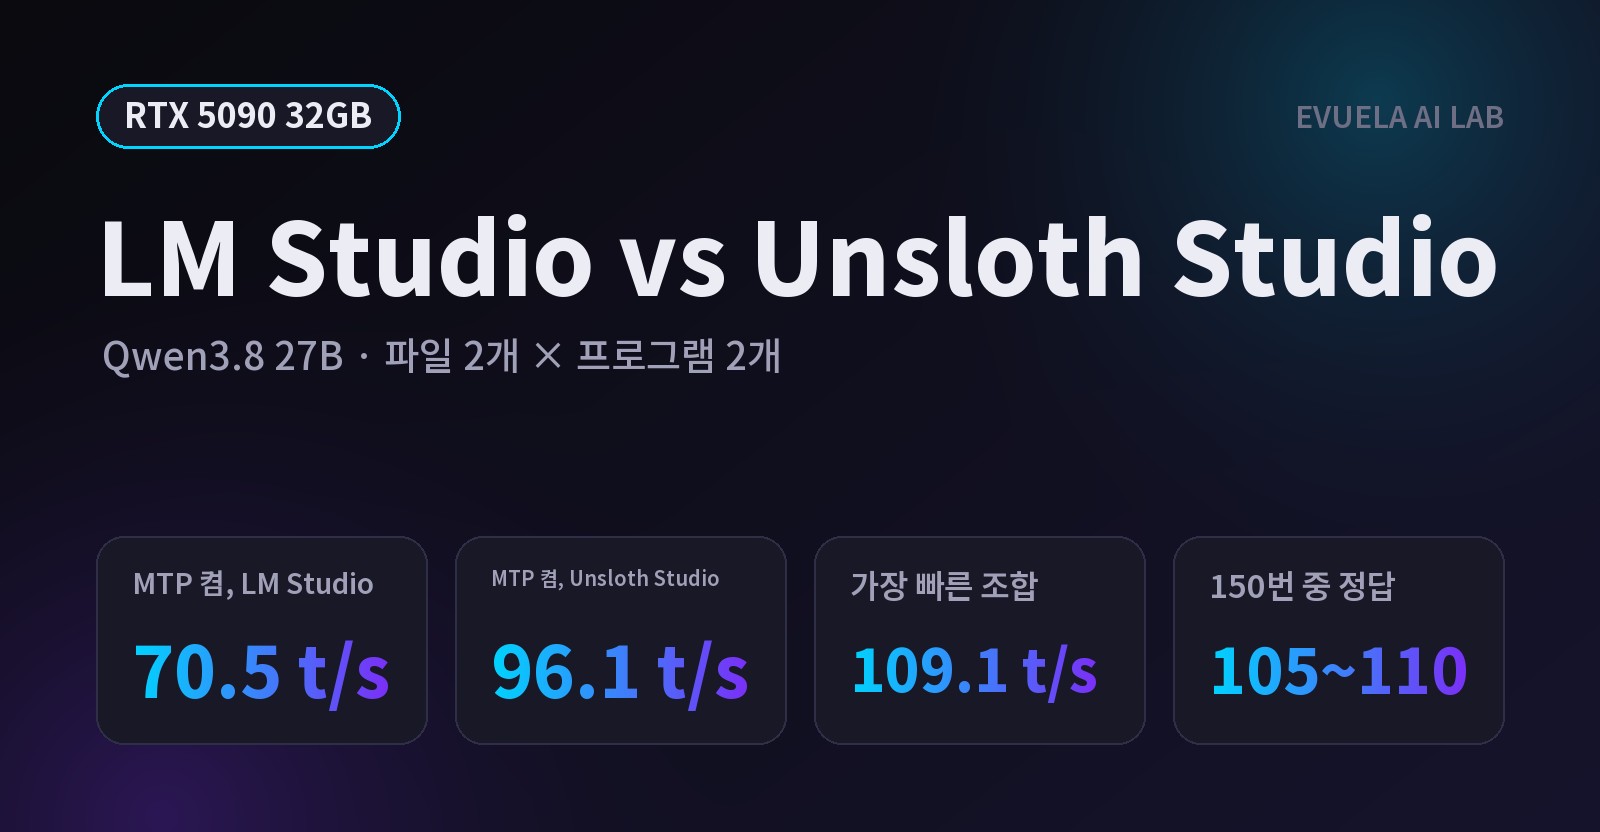
RTX 5090에서 Qwen3.8 27B 파일 두 개(lmstudio-community Q4_K_M, unsloth UD-Q4_K_XL)를 LM Studio와 Unsloth Studio에 차례로 올리고 설정을 똑같이 맞춰 쟀습니다. MTP를 끄면 두 프로그램의 속도가 거의 같았고, MTP를 켜면 Unsloth Studio가 35~36% 빨랐습니다. lmstudio-community 파일은 두 프로그램 모두에서 8~15% 더 빨랐고, 정답률은 네 조합이 같았습니다. 생각 설정의 차이와 두 프로그램 화면 캡처도 함께 정리했습니다.