[RTX 5060 Ti 16GB] 3D 장면 전용 4B 모델 Qwen3.5-4B-3D-Coder는 쓸 만할까, 장면 51개 중 10개가 제대로 그려졌다
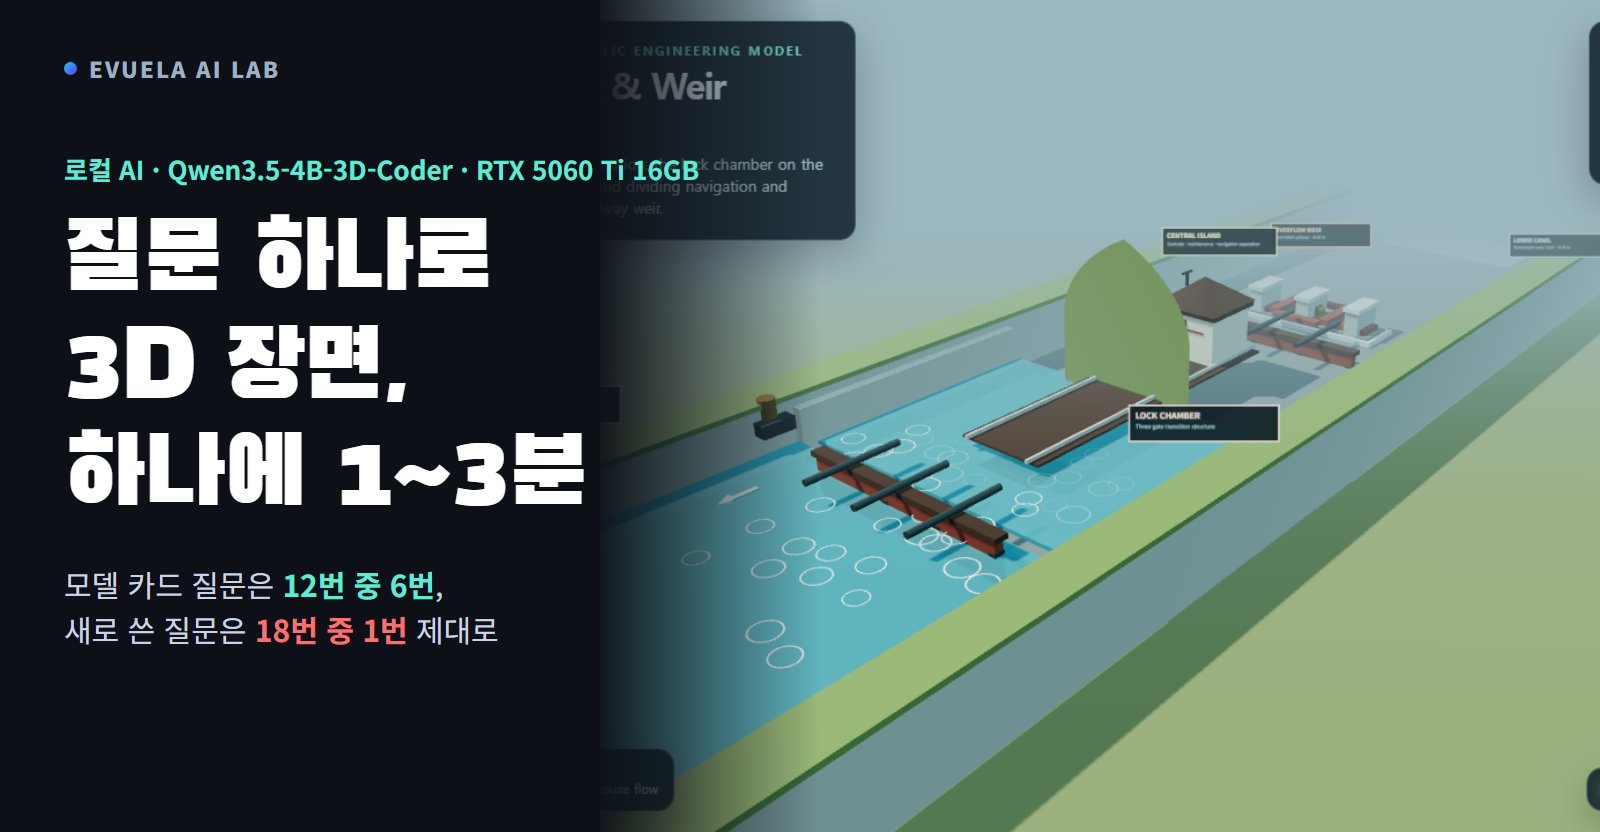
3D 장면용 4B 모델 Qwen3.5-4B-3D-Coder를 RTX 5060 Ti 16GB의 Unsloth Studio에서 돌려 장면 51개를 직접 열어 봤습니다. 제대로 그려진 것은 10개, 장면 하나에 1~3분. 생각을 켜면 6~16분이 걸렸고 결과는 같았습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"llama.cpp" 검색 결과 33건
3D 장면용 4B 모델 Qwen3.5-4B-3D-Coder를 RTX 5060 Ti 16GB의 Unsloth Studio에서 돌려 장면 51개를 직접 열어 봤습니다. 제대로 그려진 것은 10개, 장면 하나에 1~3분. 생각을 켜면 6~16분이 걸렸고 결과는 같았습니다.
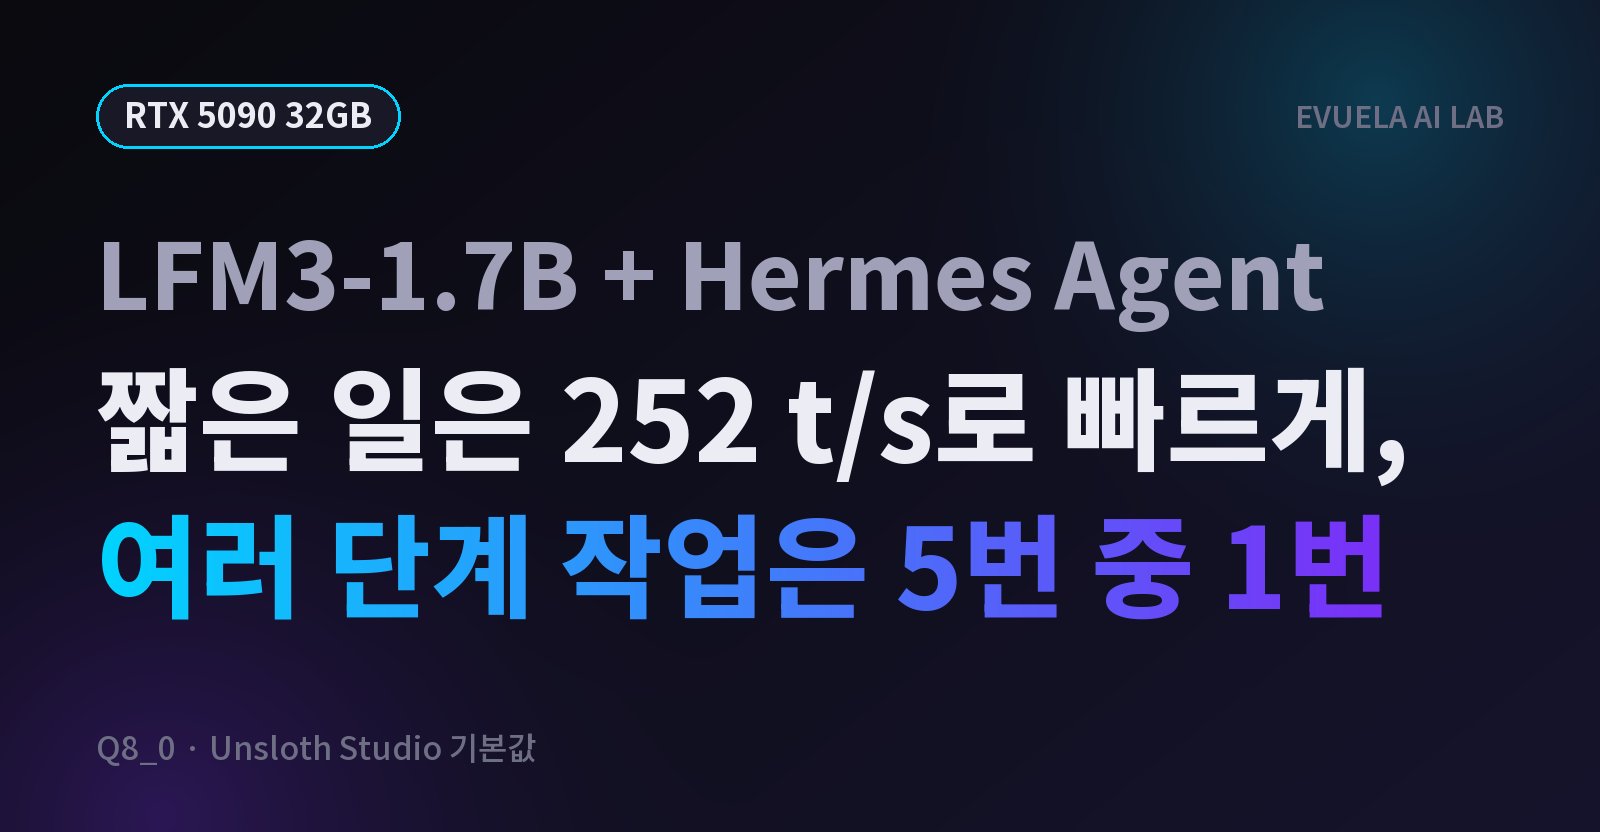
에이전트용 1.7B 모델 LFM3-1.7B를 Hermes Agent에 붙여 RTX 5090에서 과제 7가지를 시켰습니다. 33번 중 28번 성공, VRAM 5.5GB, 초당 252토큰. 짧은 일은 Qwen3.8 27B보다 빨랐지만 여러 단계 작업은 5번 중 1번만 성공했습니다.
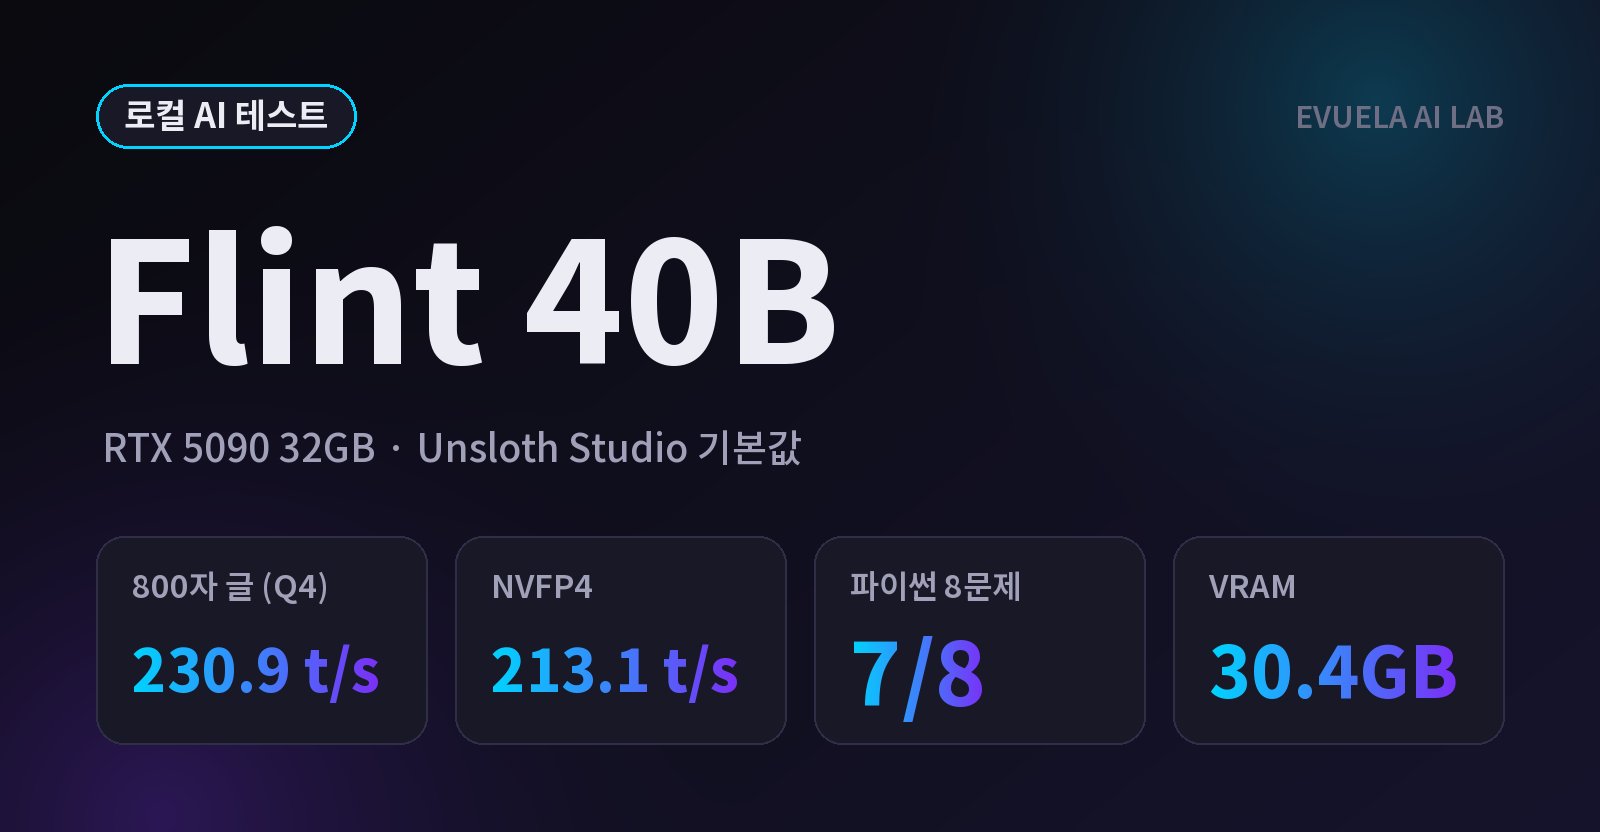
Recursive SI의 공개 코딩 모델 Flint 40B를 RTX 5090 32GB의 Unsloth Studio에서 Q4와 공식 NVFP4로 쟀습니다. 초당 230.9토큰, VRAM 30.4GB, 파이썬 8문제 중 7문제를 풀었고, 생각은 끌 수 없었으며 37만 8천 원을 3만 7,800원으로 읽었습니다.
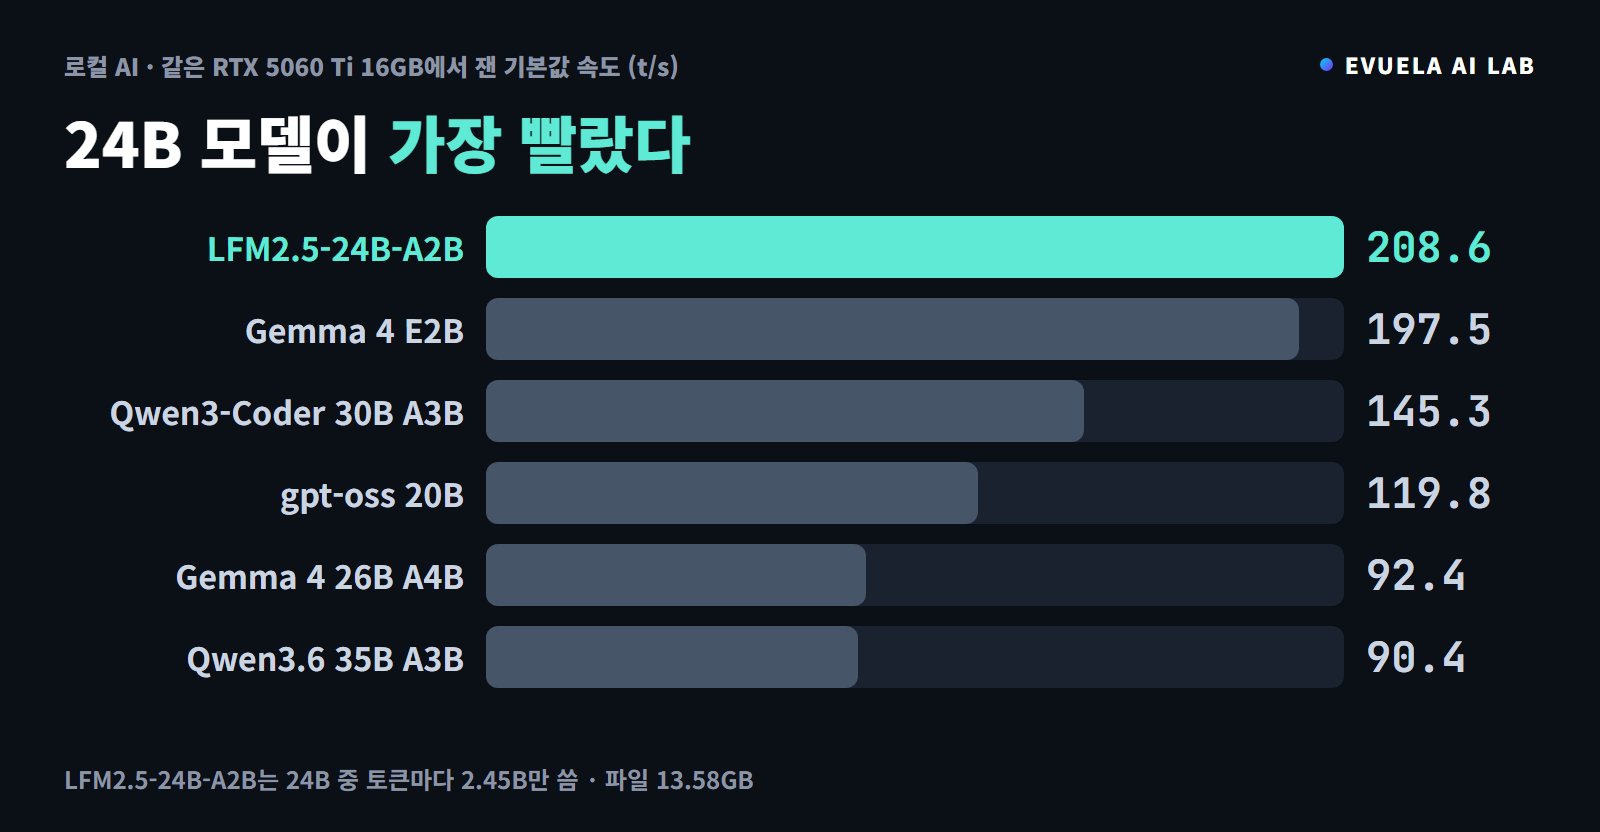
24B 중 토큰마다 2.45B만 쓰는 Liquid AI의 LFM2.5-24B-A2B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 208.6토큰으로 이 PC에서 가장 빨랐고, 100,000자 요약은 20.7초, 생각은 끌 수 없었습니다.
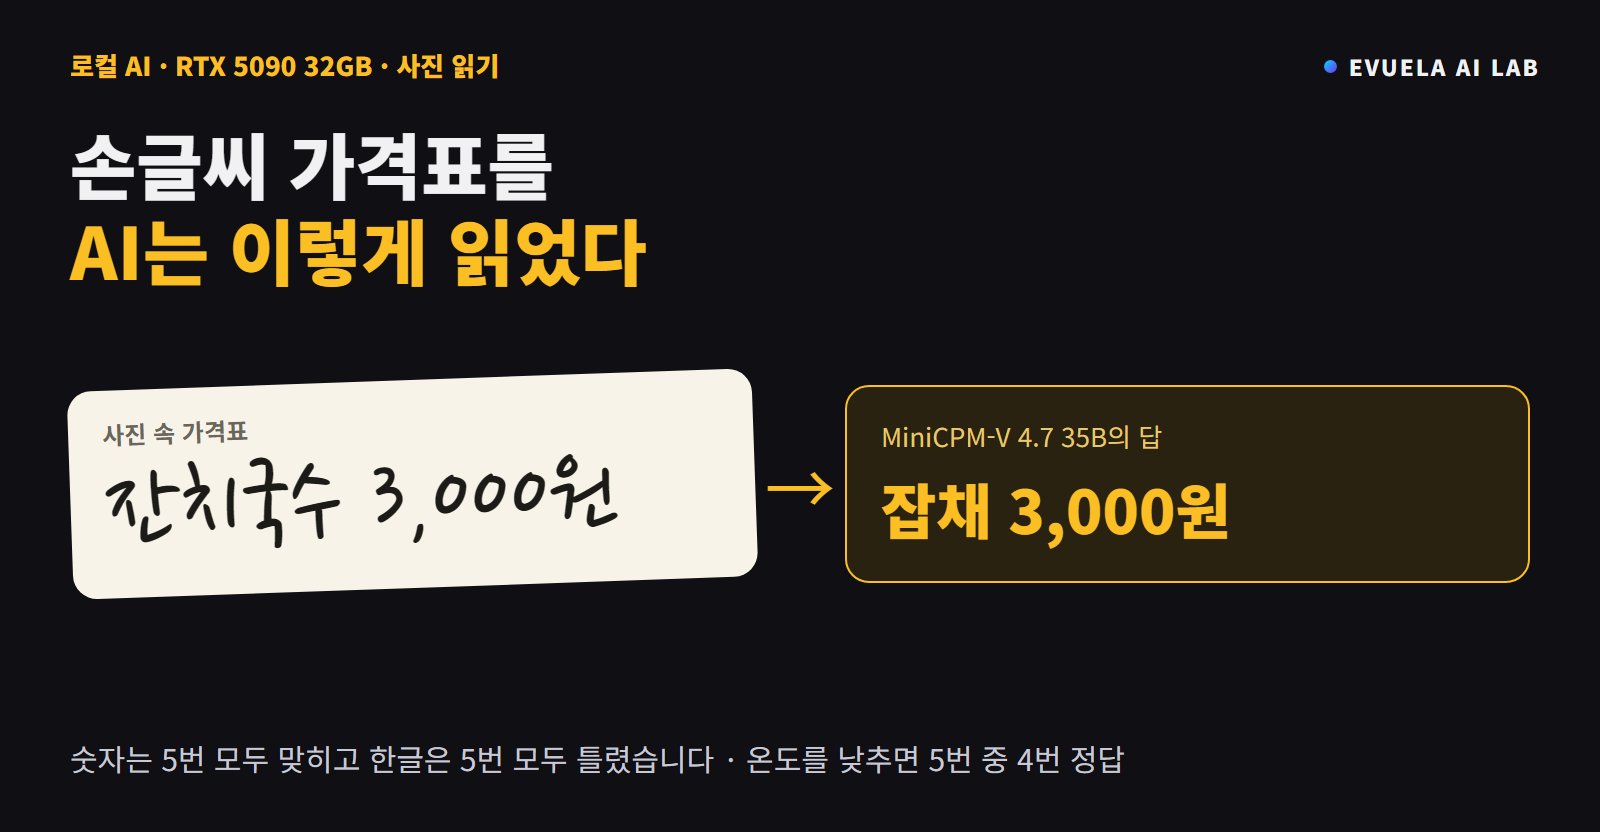
사진과 영상을 읽는 공개 모델 MiniCPM-V 4.7 35B A3B를 RTX 5090에서 쟀습니다. 속도는 초당 269토큰, 표와 화면 캡처는 70번 중 65번, Pixabay 실제 사진은 55번 중 29번 맞혔습니다. Unsloth Studio에서 사진이 안 된 이유와 한글 간판을 틀린 모습, 나아지는 설정도 적었습니다.
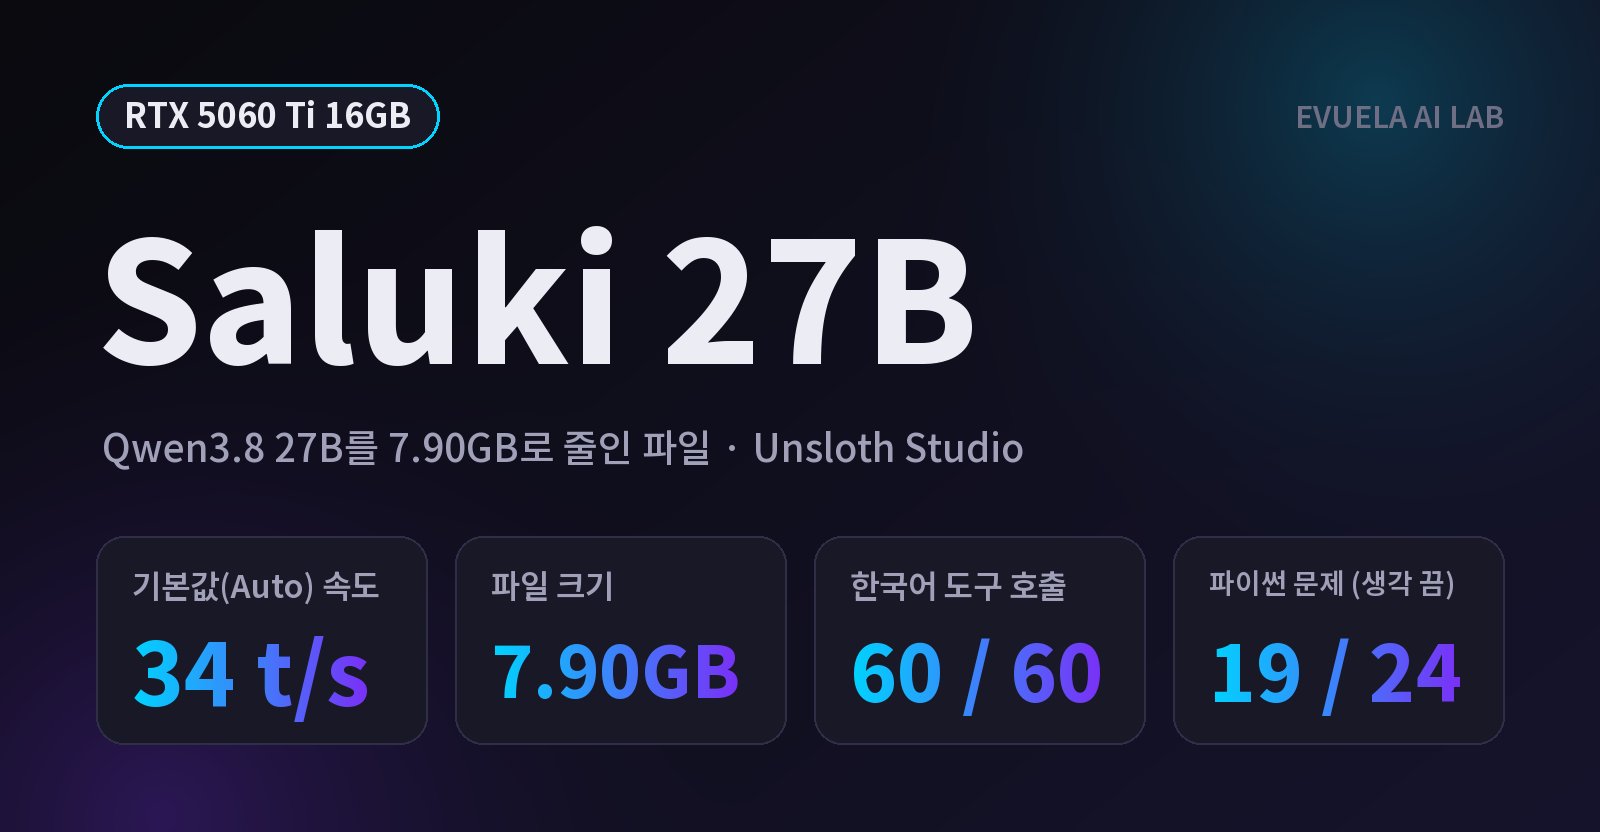
Qwen3.8 27B를 7.90GB로 줄인 Saluki 27B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 34토큰, 한국어 도구 호출 60번 모두 정답이었고, 생각 단계를 정하지 않으면 15번 중 6번은 답이 나오지 않았습니다.
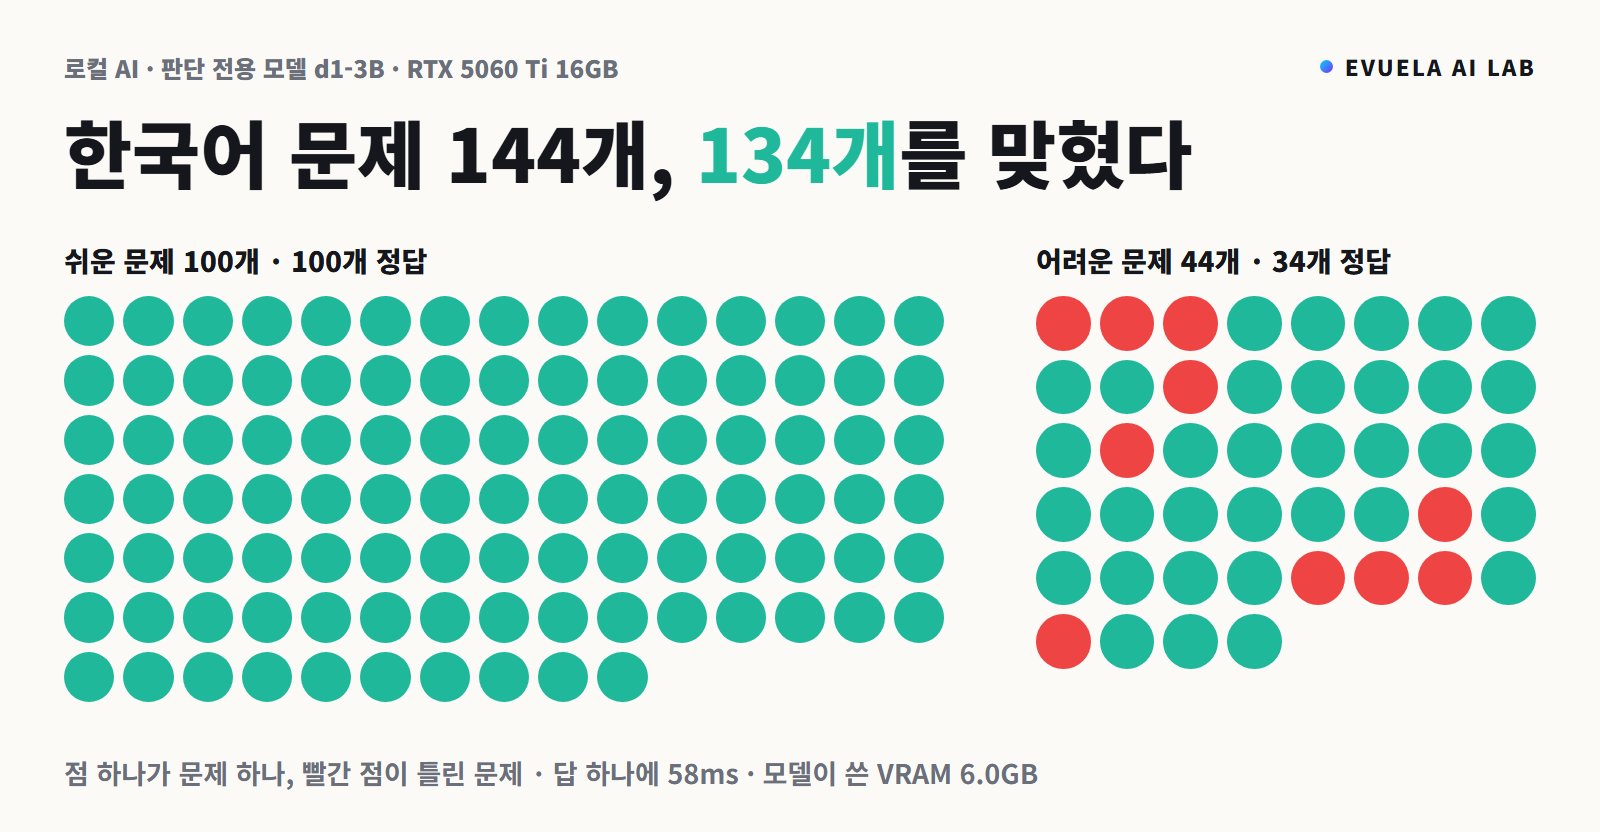
글을 쓰지 않고 보기마다 확률로 답하는 Liquid AI의 판단 전용 모델 d1-3B를 RTX 5060 Ti 16GB에서 한국어 144문제로 쟀습니다. 쉬운 100문제는 모두, 어려운 44문제는 34개를 맞혔고 답 하나에 0.06초, VRAM 6.0GB였습니다.
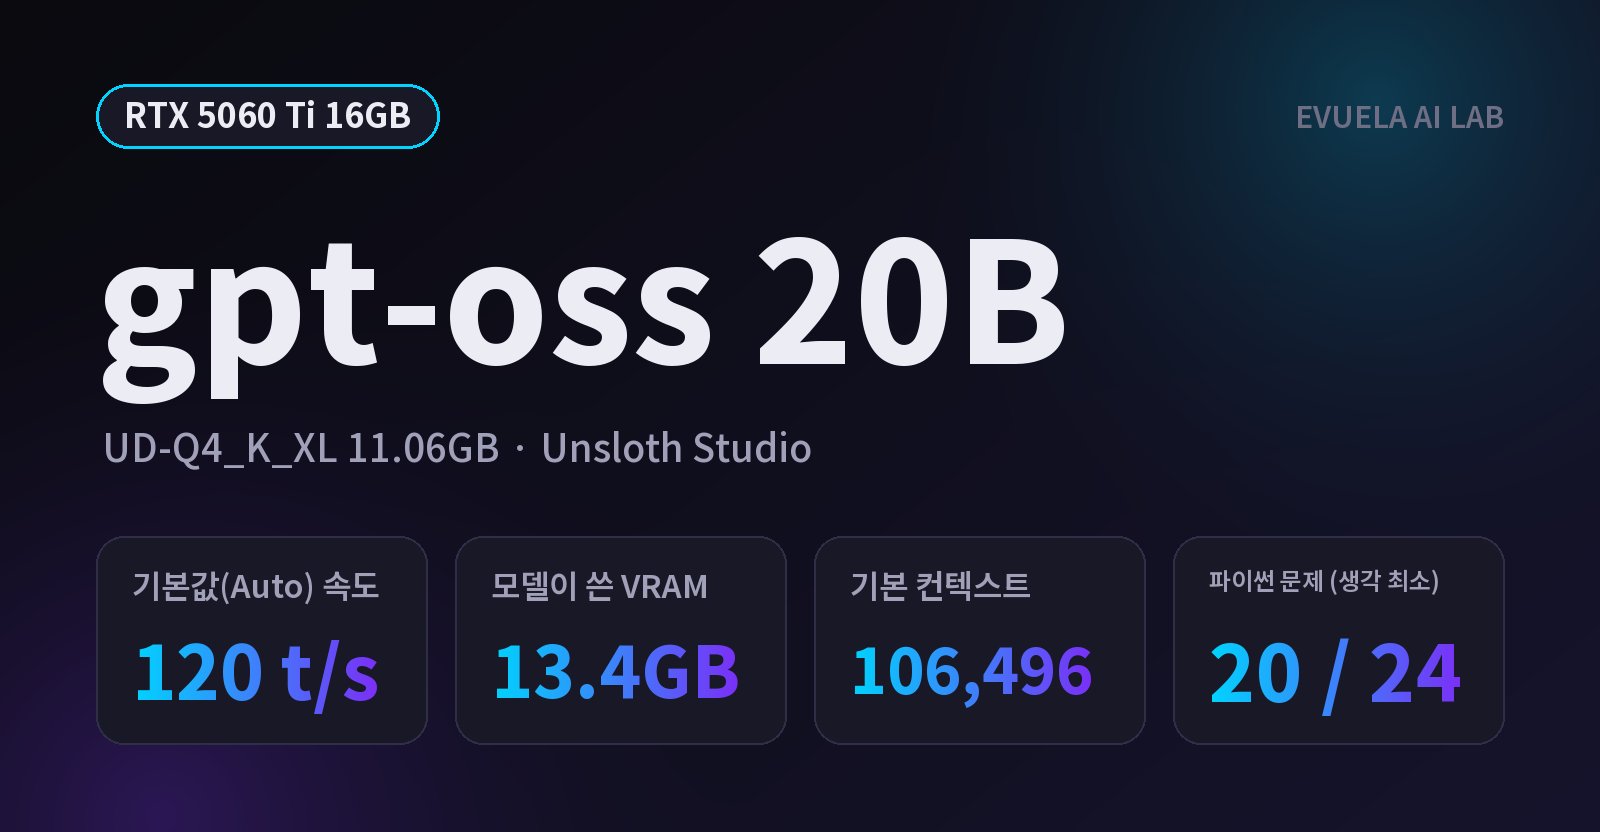
RTX 5060 Ti 16GB의 Unsloth Studio에서 OpenAI의 gpt-oss 20B(UD-Q4_K_XL 11.06GB)를 기본값으로 돌렸습니다. 초당 약 120토큰, 컨텍스트 65,536까지 같은 속도였고, 생각 단계에 따라 시간과 코딩 결과가 크게 달랐습니다.
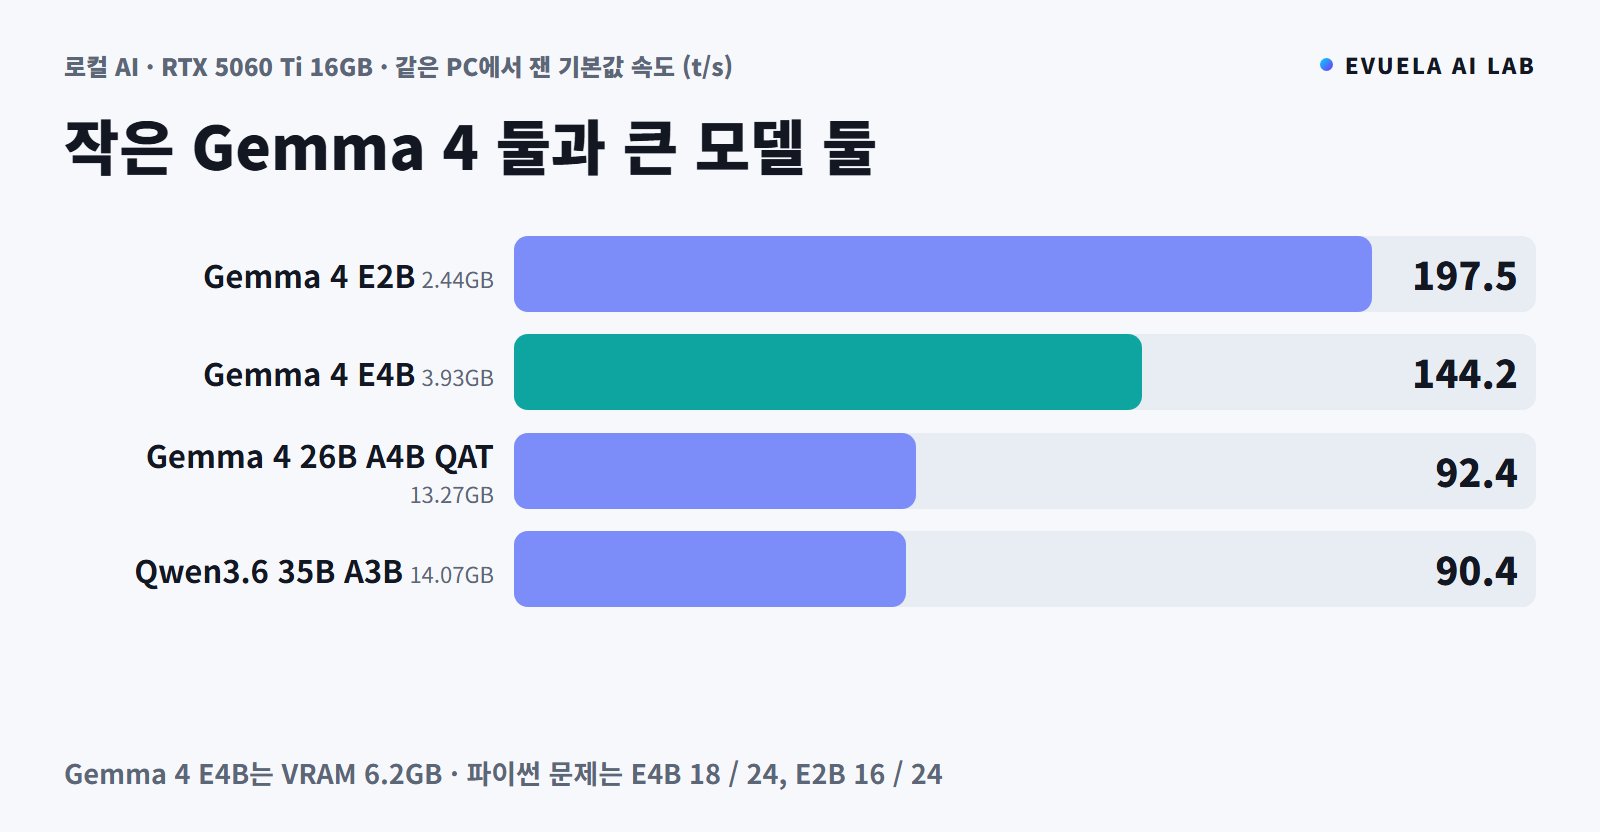
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 E4B(QAT UD-Q4_K_XL 3.93GB)를 기본값으로 돌렸습니다. VRAM 6.2GB에 초당 약 144토큰이었고, 같은 PC에서 잰 E2B와 속도·산수·코딩·사진 결과를 나란히 비교했습니다.