[RTX 5060 Ti 16GB] 로컬 AI Gemma 4 E2B, 가장 작은 모델은 얼마나 쓸 만할까, VRAM 3.6GB에 초당 197토큰이었다
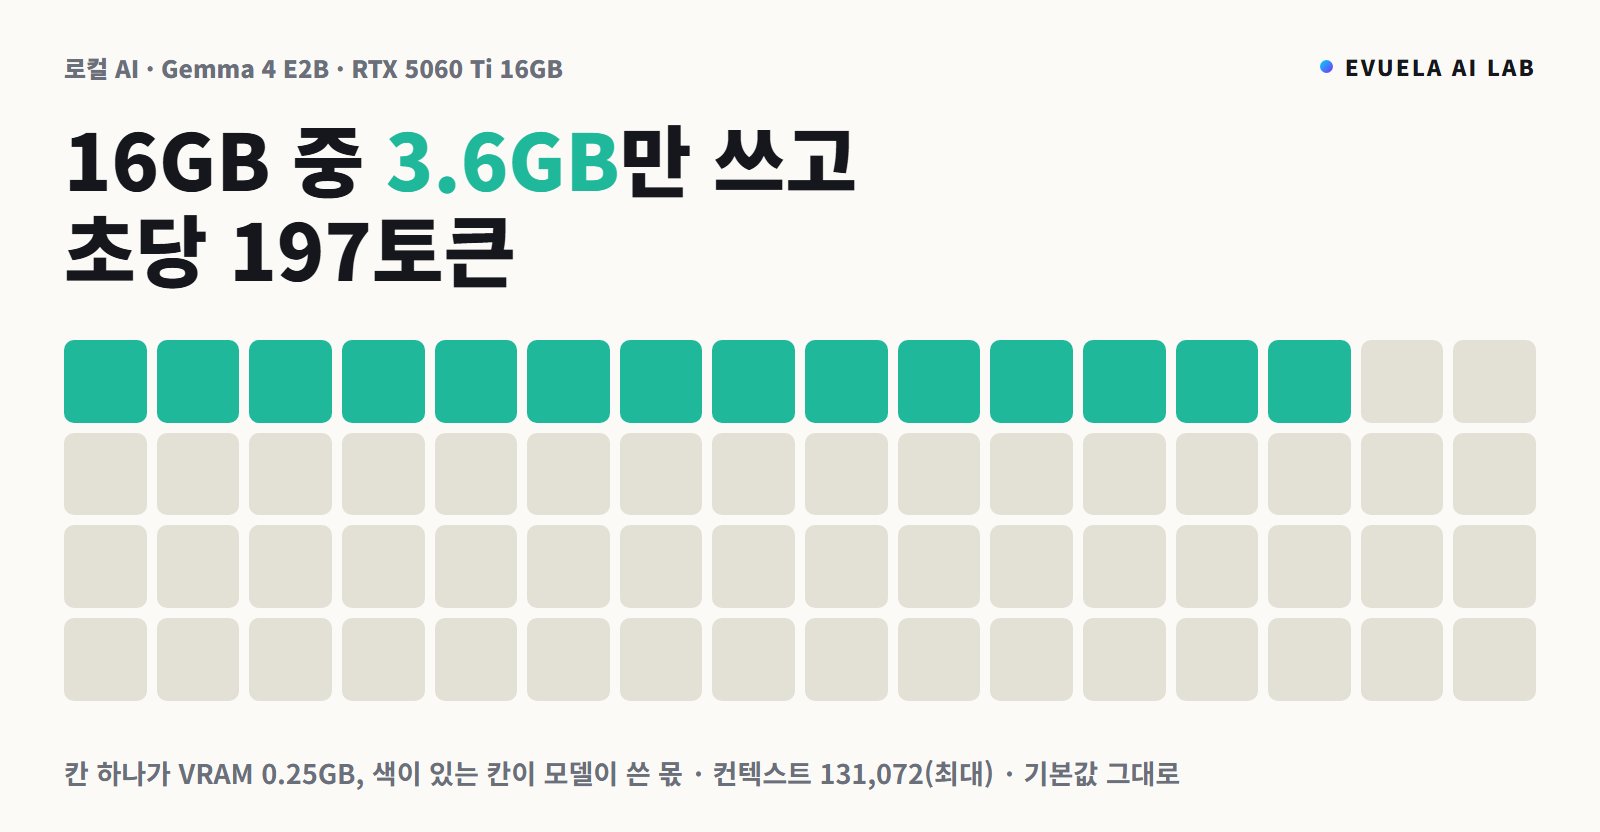
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 E2B(QAT UD-Q4_K_XL 2.44GB)를 기본값으로 돌렸습니다. VRAM 3.6GB에 초당 약 197토큰, 최대 컨텍스트 131,072에서도 같은 속도였습니다. 산수·코딩·사진 결과를 담았습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"파이썬" 검색 결과 22건
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 E2B(QAT UD-Q4_K_XL 2.44GB)를 기본값으로 돌렸습니다. VRAM 3.6GB에 초당 약 197토큰, 최대 컨텍스트 131,072에서도 같은 속도였습니다. 산수·코딩·사진 결과를 담았습니다.
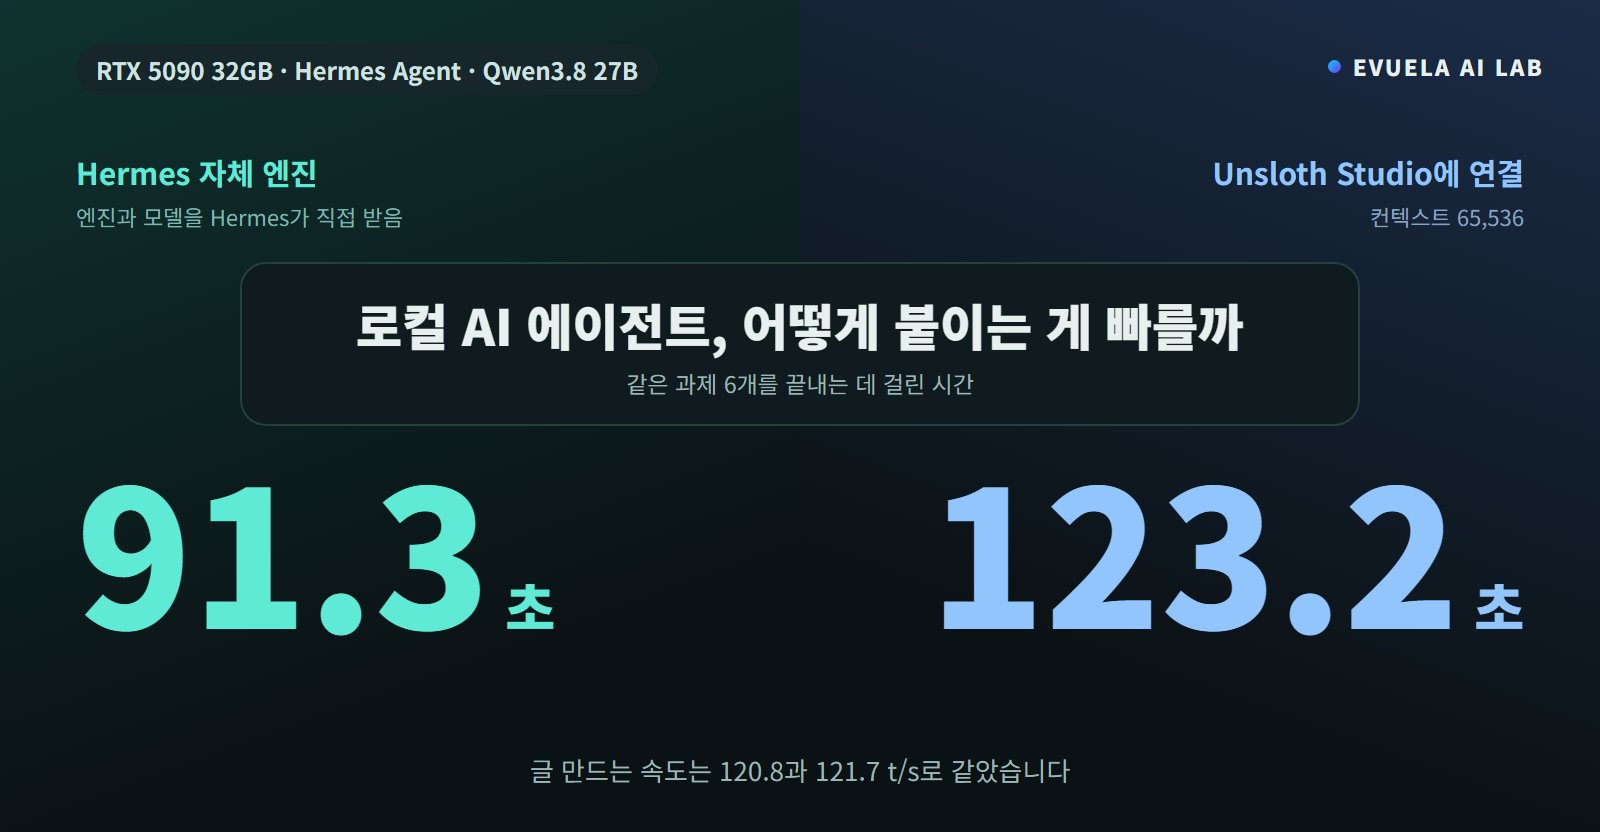
Hermes Agent를 로컬 모델에 붙이는 두 방식을 RTX 5090에서 Qwen3.8 27B로 비교했습니다. 글 만드는 속도는 120.8과 121.7 t/s로 같았지만 과제 6개는 91.3초와 123.2초였습니다. 차이는 프롬프트를 다시 읽는 양에서 났습니다.
대화에 익숙해진 다음에 해 볼 것을 코딩, 도구(MCP), API, 그림, 영상, 음성, 검색으로 정리했습니다. 그림 한 장 7.6초, 5초 영상 약 20초, 50초 음성 약 11초였고, 필요한 VRAM은 음성 3.5GB부터 영상 31.2GB까지 달랐습니다.
모델을 고르는 순서를 VRAM, 컨텍스트, 쓰임새 세 가지로 정리했습니다. RTX 5060 Ti 16GB와 RTX 5090 32GB에서 잰 측정 16건의 파일 크기와 VRAM을 한 표에 모았고, 컨텍스트를 늘리면 VRAM과 속도가 어떻게 바뀌는지도 담았습니다.
모델 이름의 12B, A3B, QAT, GGUF, Q4_K_M이 무슨 뜻인지 조각별로 풀었습니다. 같은 Qwen3.8 27B도 4비트 파일은 17.74GB, 2비트 파일은 9.30GB였고, 같은 Q4_K_M도 올린 곳에 따라 16.46GB에서 18.97GB까지 달랐습니다.
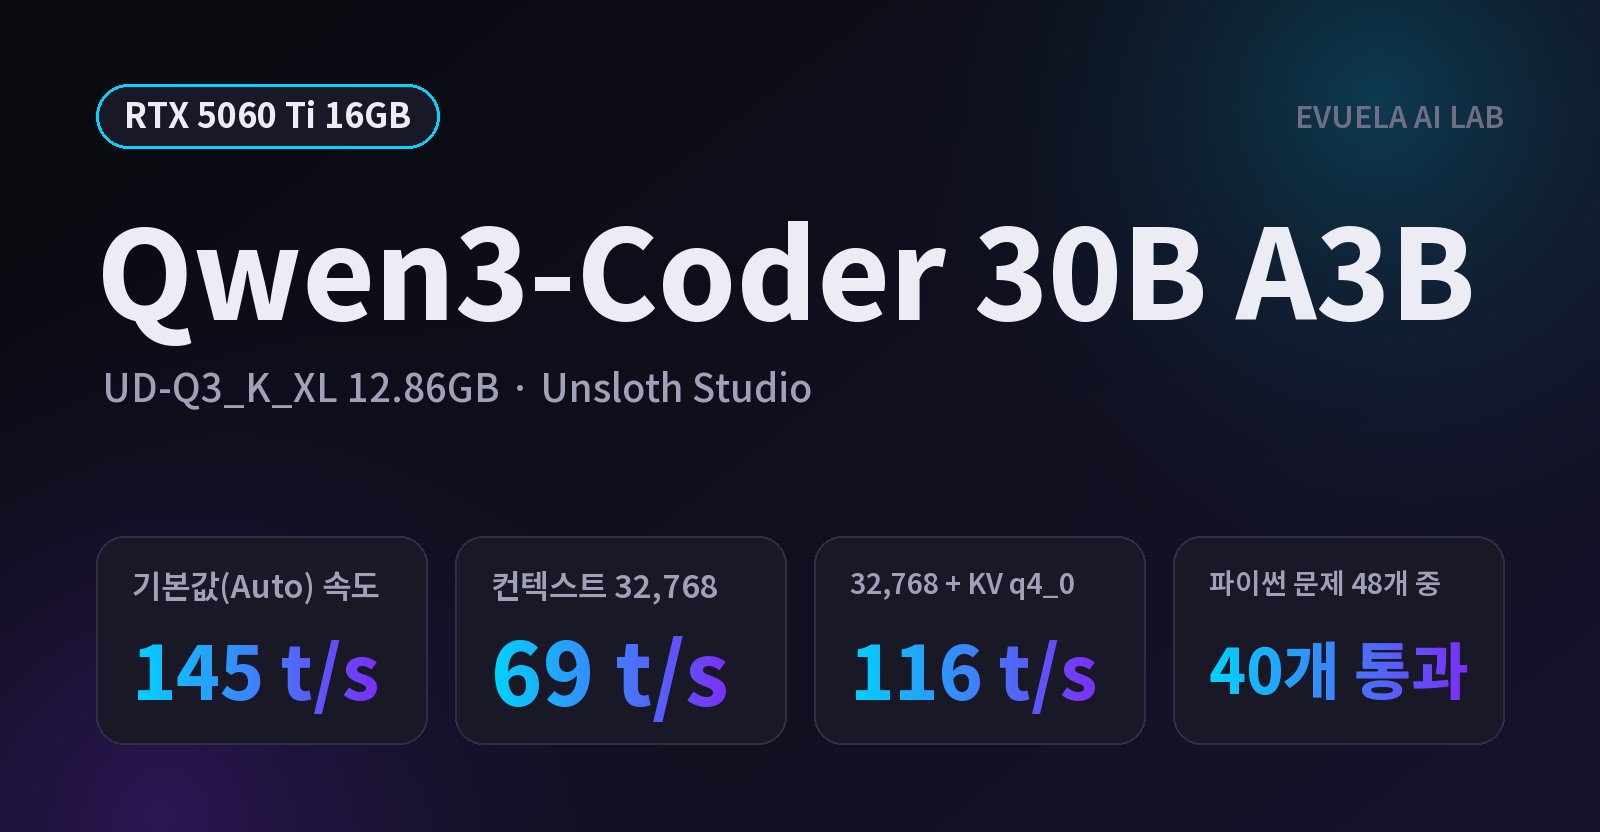
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
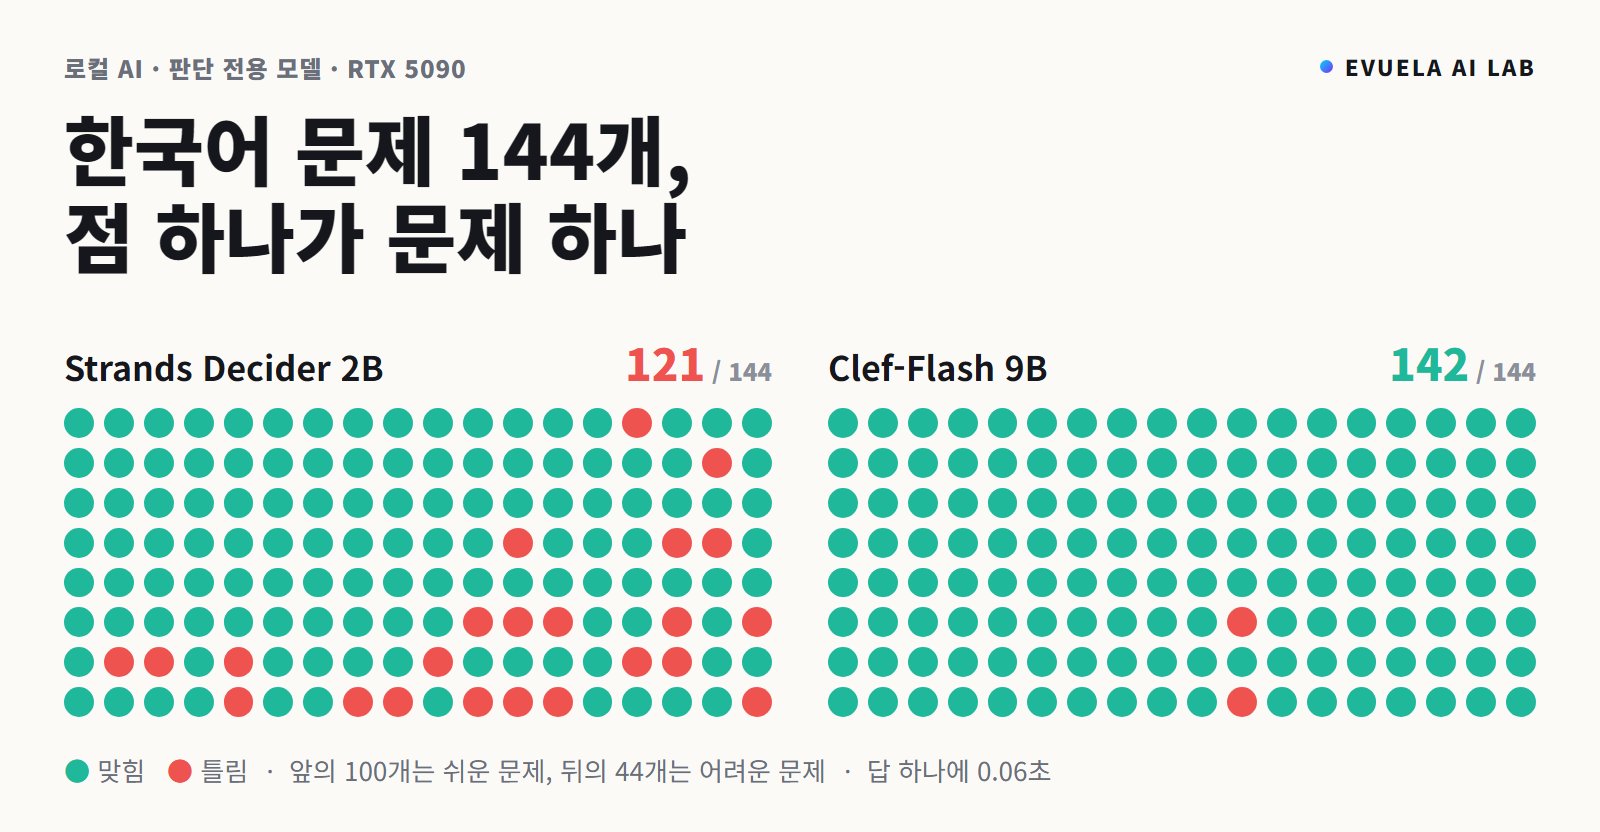
글을 쓰지 않고 보기 가운데 답을 확률로 고르는 판단 전용 모델 Strands Decider 2B와 Clef-Flash 9B를 RTX 5090에서 한국어 144문제로 비교했습니다. 쉬운 문제는 95개와 100개, 어려운 문제는 26개와 42개를 맞혔고 답 하나에 0.05~0.07초였습니다.
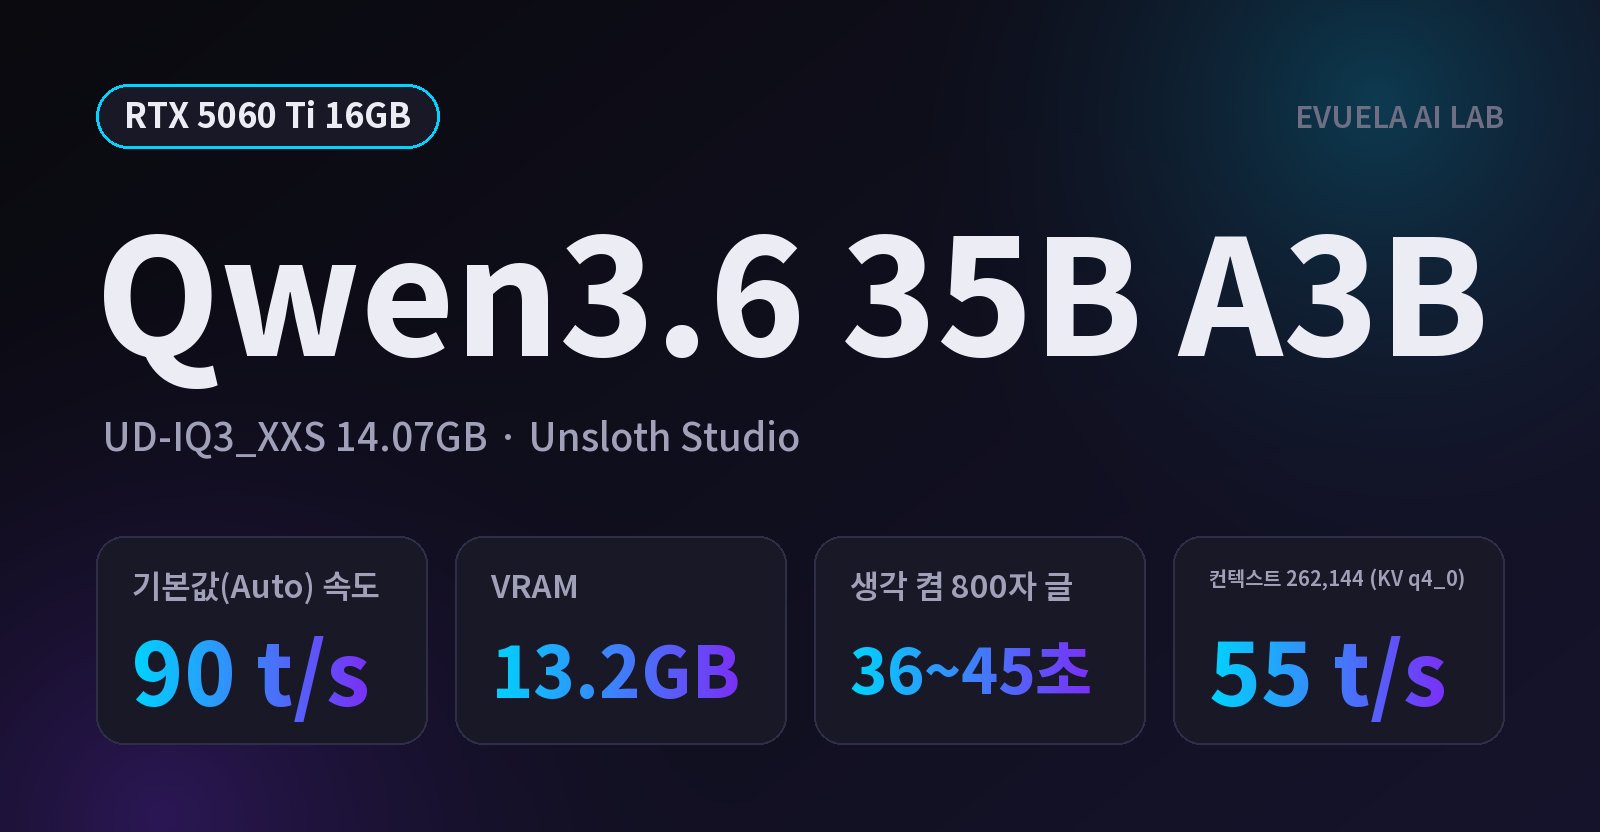
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3.6 35B A3B(UD-IQ3_XXS)를 기본값으로 돌렸습니다. VRAM 13.2GB에 다 들어갔고 초당 약 90토큰이었습니다. 컨텍스트별 속도, 설정 비교, Gemma 4 26B와의 비교를 담았습니다.
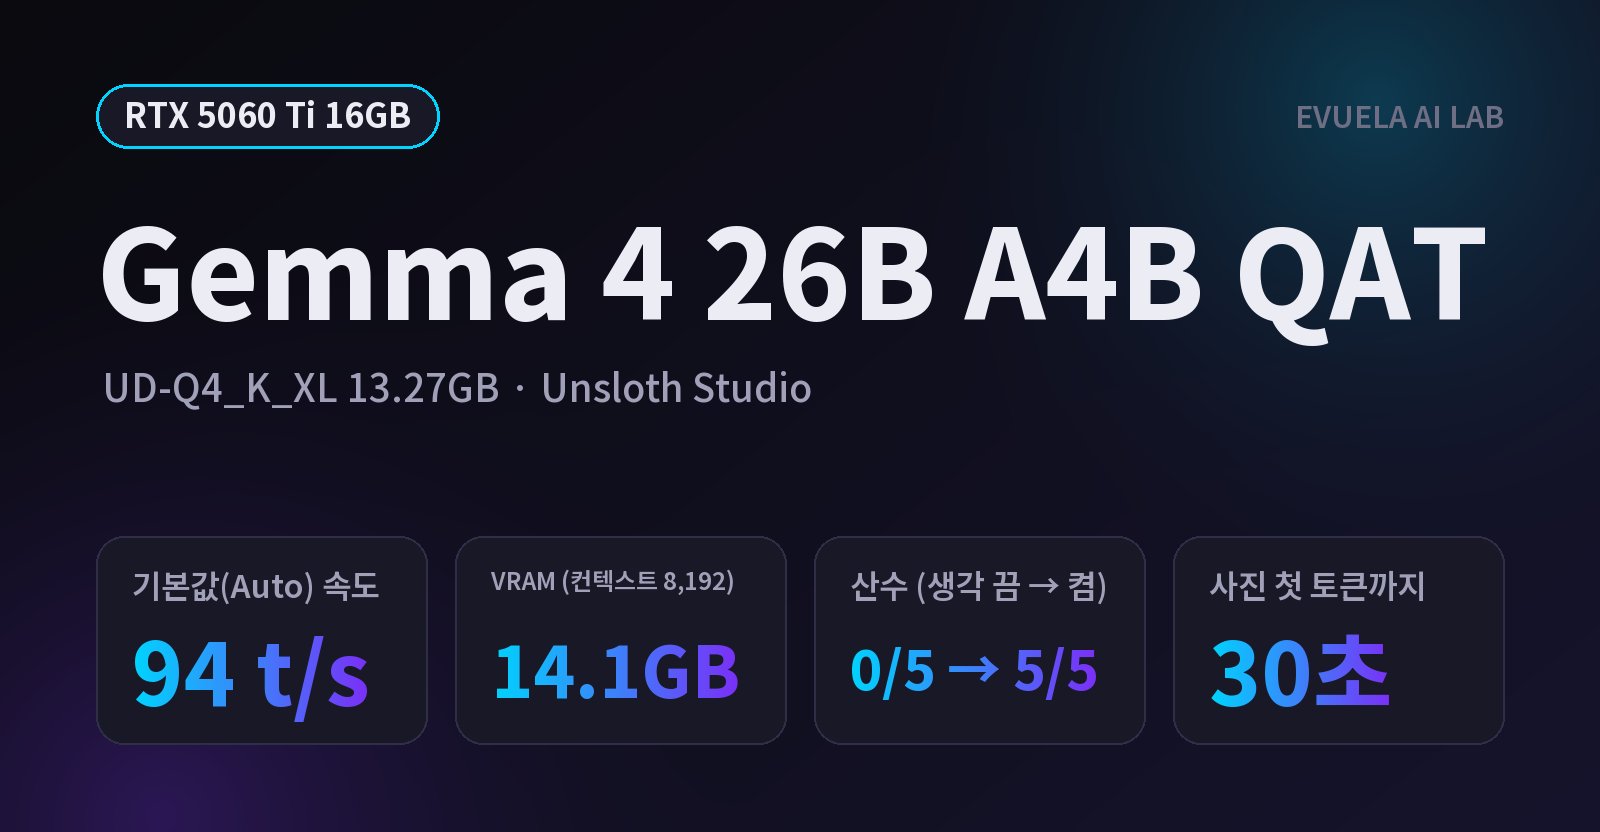
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.