"RTX 5060 Ti" 검색 결과 20건

AMD Ryzen AI Max PRO 400은 그래픽카드 없이 300B 모델을 돌린다는데, 160GB 메모리와 실제 속도를 계산해 봤다 AI 뉴스

AMD Ryzen AI Max PRO 400은 그래픽카드 없이 300B 모델을 돌린다는데, 160GB 메모리와 실제 속도를 계산해 봤다

AMD Ryzen AI Max PRO 400 시리즈가 들어간 PC가 팔리기 시작했습니다. 통합 메모리 192GB 가운데 160GB를 AI 모델에 쓸 수 있고, AMD는 300B 모델까지 돌릴 수 있다고 밝혔습니다. 공식 발표를 정리하고, 직접 잰 Qwen3.8 27B 파일 크기와 RTX 5090 속도를 가져와 300B가 정말 들어가는지, 들어가면 얼마나 빠를지 계산했습니다. 제품 가격과 RTX 5090과의 차이도 함께 담았습니다.
2026.10.02 12
[RTX 5090 32GB] Unsloth Studio로 Qwen3.8 27B를 돌리면 어떤 설정이 좋을까, 최대 컨텍스트에서도 초당 103토큰이 나왔다 RTX-5090

[RTX 5090 32GB] Unsloth Studio로 Qwen3.8 27B를 돌리면 어떤 설정이 좋을까, 최대 컨텍스트에서도 초당 103토큰이 나왔다

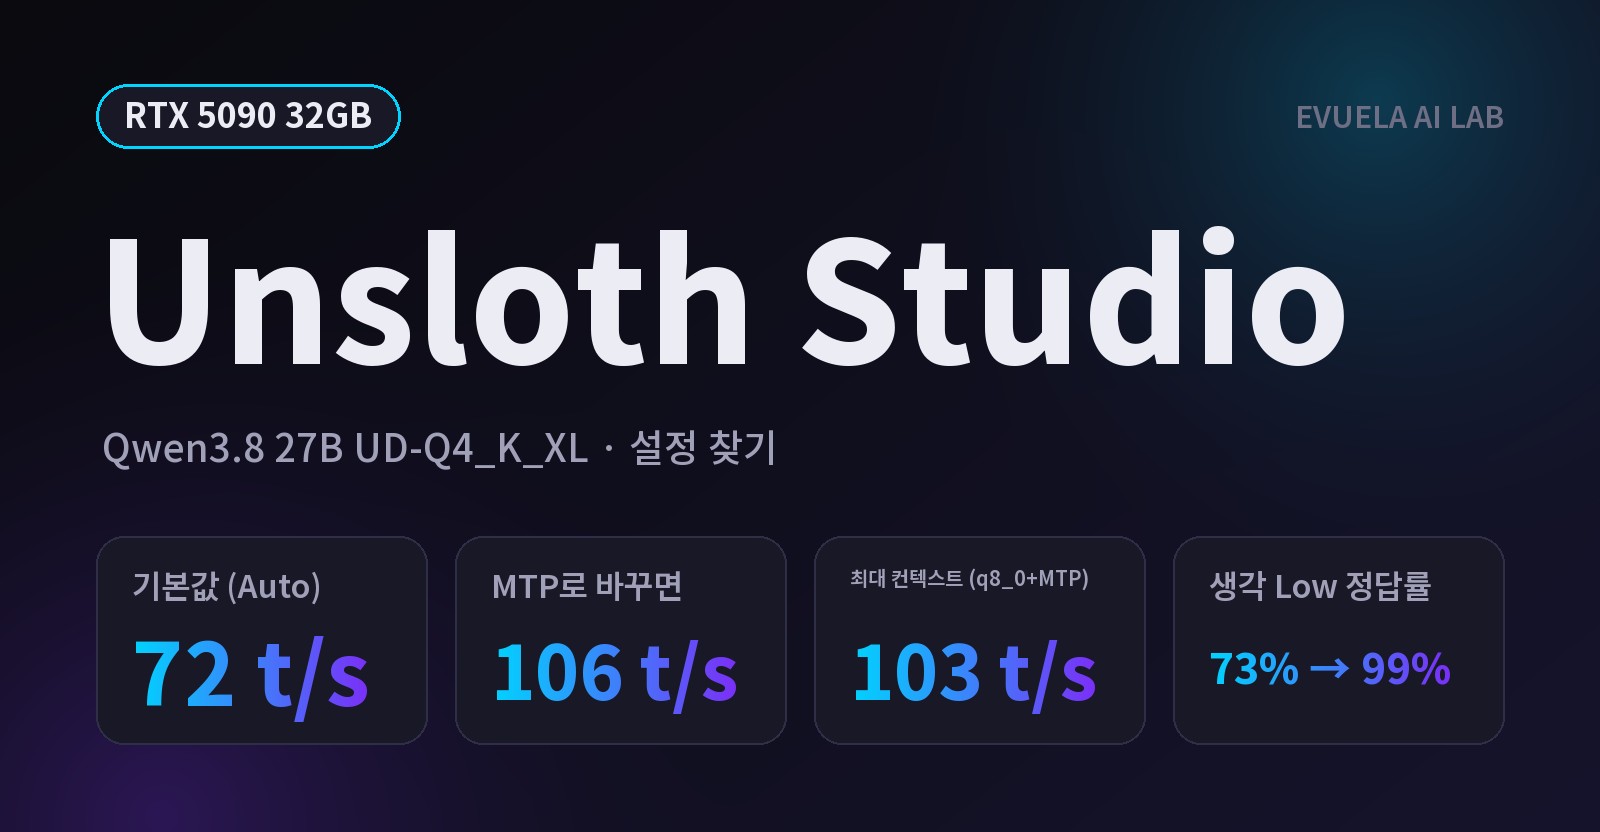
Unsloth Studio를 RTX 5090에 설치하고 Qwen3.8 27B(UD-Q4_K_XL)로 설정을 하나씩 바꿔 가며 쟀습니다. 기본값은 컨텍스트를 16만 8천 토큰으로 알아서 잡았고 초당 72토큰이었습니다. 속도 기능을 MTP로 바꾸면 48% 빨라졌고, KV 캐시를 q8_0으로 줄이면 최대 컨텍스트 262,144에서도 초당 103토큰이 나왔습니다. 생각 단계별 정답률, 화면 캡처, 쓰임새별 추천 설정을 정리했습니다.

2026.10.02 20
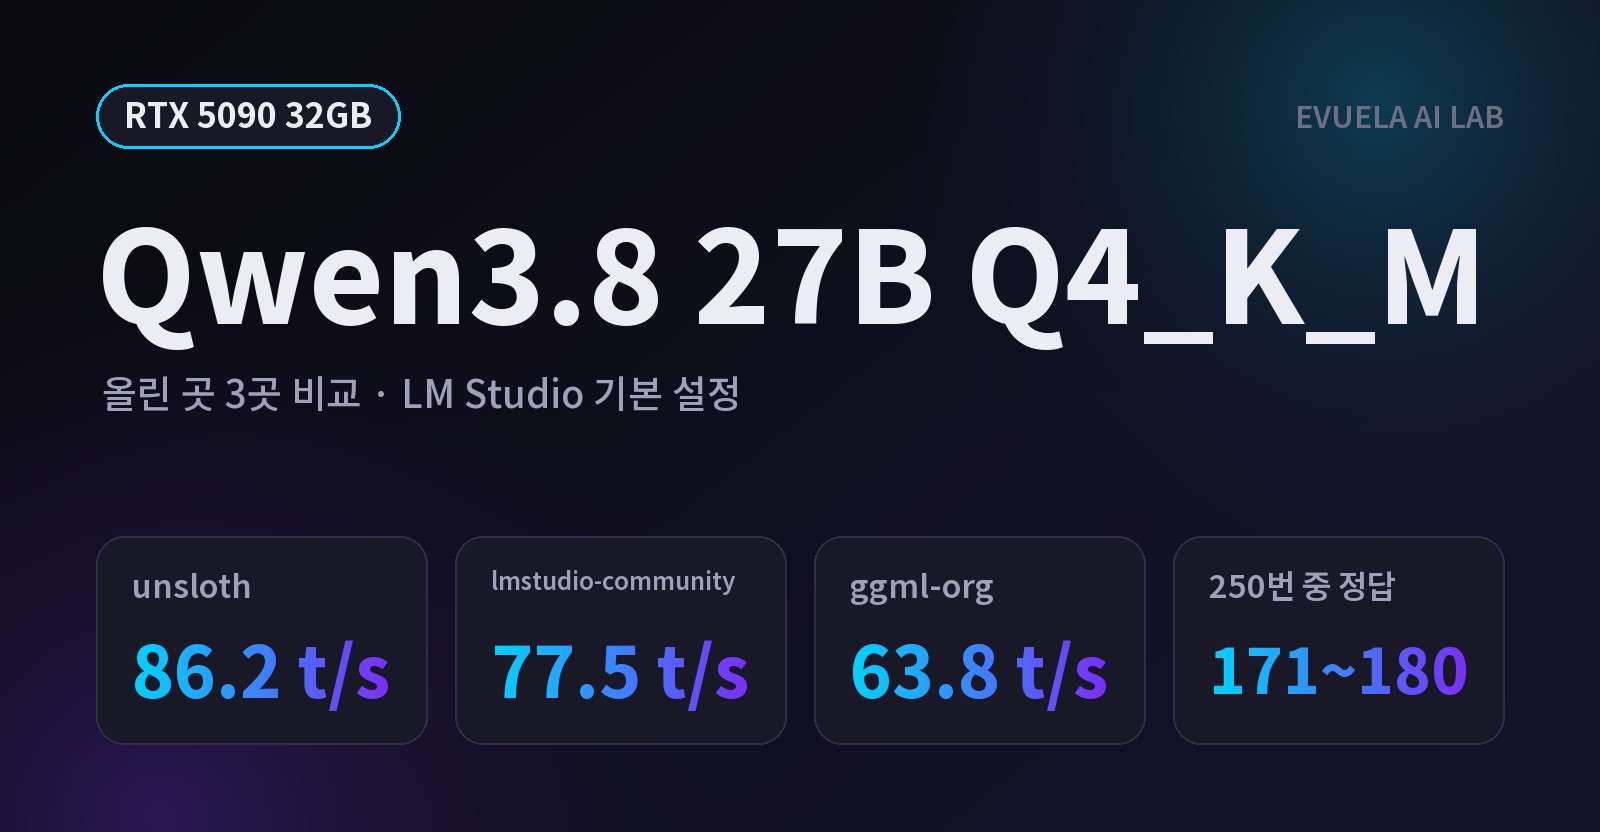
[RTX 5090 32GB] 같은 Q4_K_M인데 뭐가 다를까, unsloth·lmstudio-community·ggml-org의 Qwen3.8 27B는 정답률이 같고 속도만 달랐다 RTX-5090

[RTX 5090 32GB] 같은 Q4_K_M인데 뭐가 다를까, unsloth·lmstudio-community·ggml-org의 Qwen3.8 27B는 정답률이 같고 속도만 달랐다

Qwen3.8 27B Q4_K_M 파일을 lmstudio-community, unsloth, ggml-org 세 곳에서 받아 RTX 5090과 LM Studio로 비교했습니다. 채점 질문 250번 중 171~180번을 맞혀 정답률은 거의 같았고, 생성 속도는 초당 63.8~86.2토큰으로 달랐습니다. 차이는 파일 안에 MTP 레이어가 있느냐에서 나왔습니다. 파일 속 양자화 구성, VRAM, MCP 도구 호출 결과와 LM Studio 캡처를 함께 정리했습니다.

2026.10.01 35
[RTX 5090 32GB] 로컬 AI에 MCP 도구를 붙이면 달라질까, Qwen3.8·Gemma 4 정답률이 1%에서 99%가 됐다 Tools

[RTX 5090 32GB] 로컬 AI에 MCP 도구를 붙이면 달라질까, Qwen3.8·Gemma 4 정답률이 1%에서 99%가 됐다

로컬 AI 모델 4개(Qwen3.8 27B, Gemma 4 26B A4B, Gemma 4 31B, Muse Glimmer)에 MCP 도구 3개(웹 페이지 읽기, 현재 시간, 파일 읽기)를 붙이고 같은 질문 30개를 물었습니다. 최신 정보와 파일 질문에서 240번 중 3번이던 정답이 237번이 됐고, 도구가 없을 때는 문서를 읽은 척 틀린 답을 하기도 했습니다. LM Studio 설정 방법과 캡처, 모델별 결과를 정리했습니다.

2026.10.01 33