[RTX 5060 Ti 16GB] 16GB 그래픽카드로 소리 나는 AI 영상 만들 수 있을까? HyperFlow H3 Flash는 5.2초에 7분 36초였다
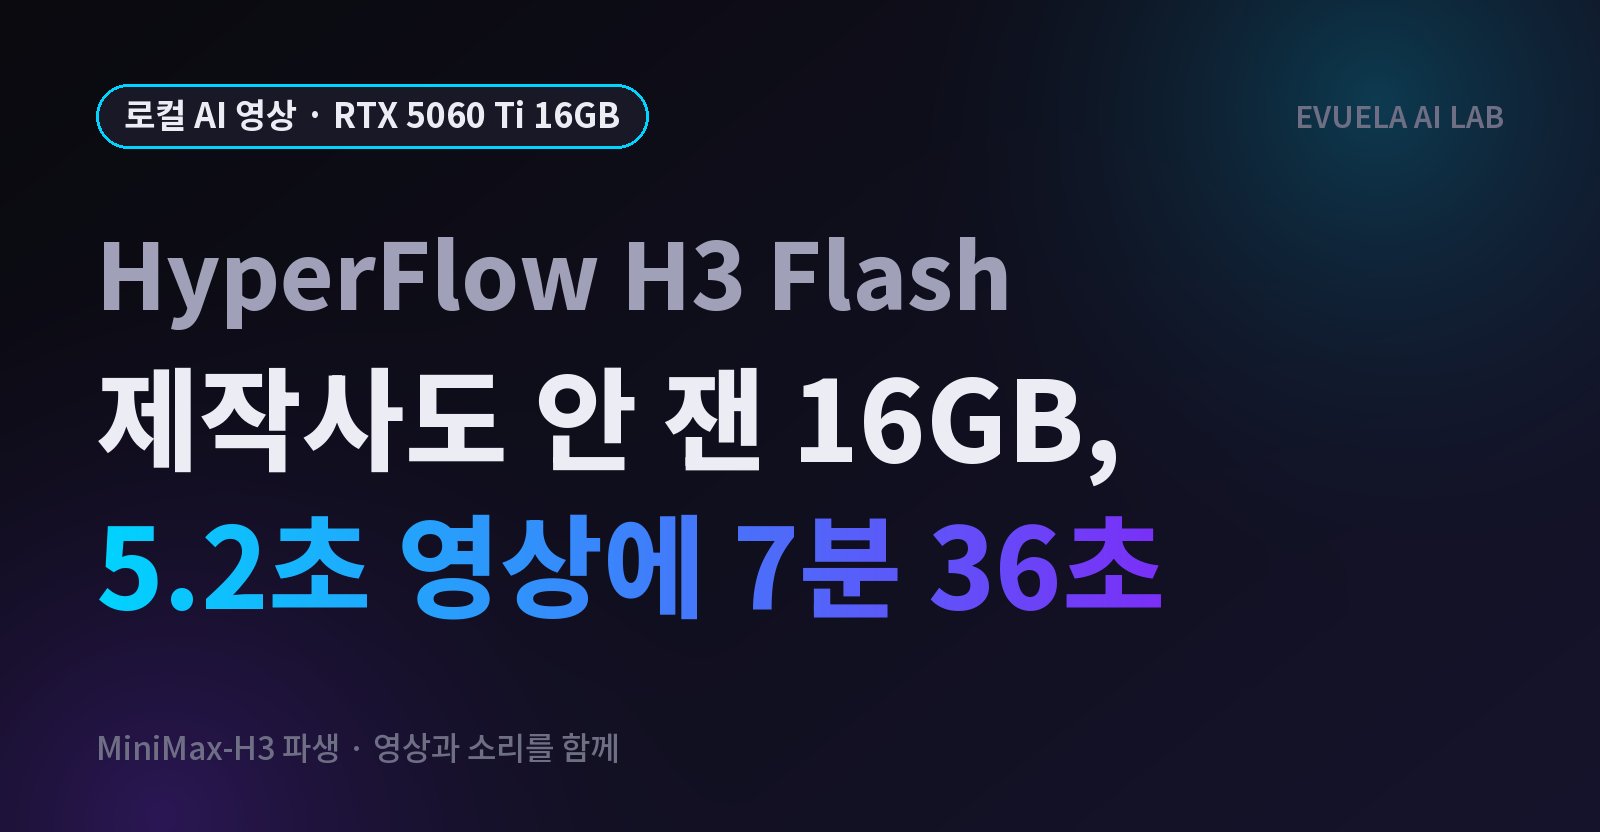
RTX 5060 Ti 16GB에서 HyperFlow H3 Flash로 소리까지 함께 나는 5.2초 영상을 만들었습니다. 1344×768 한 편에 456초, VRAM은 최대 14.8GB였고 10초부터는 VRAM이 모자랐습니다. 960×544로 낮추면 15초까지 됐습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Q8_0" 검색 결과 22건
RTX 5060 Ti 16GB에서 HyperFlow H3 Flash로 소리까지 함께 나는 5.2초 영상을 만들었습니다. 1344×768 한 편에 456초, VRAM은 최대 14.8GB였고 10초부터는 VRAM이 모자랐습니다. 960×544로 낮추면 15초까지 됐습니다.
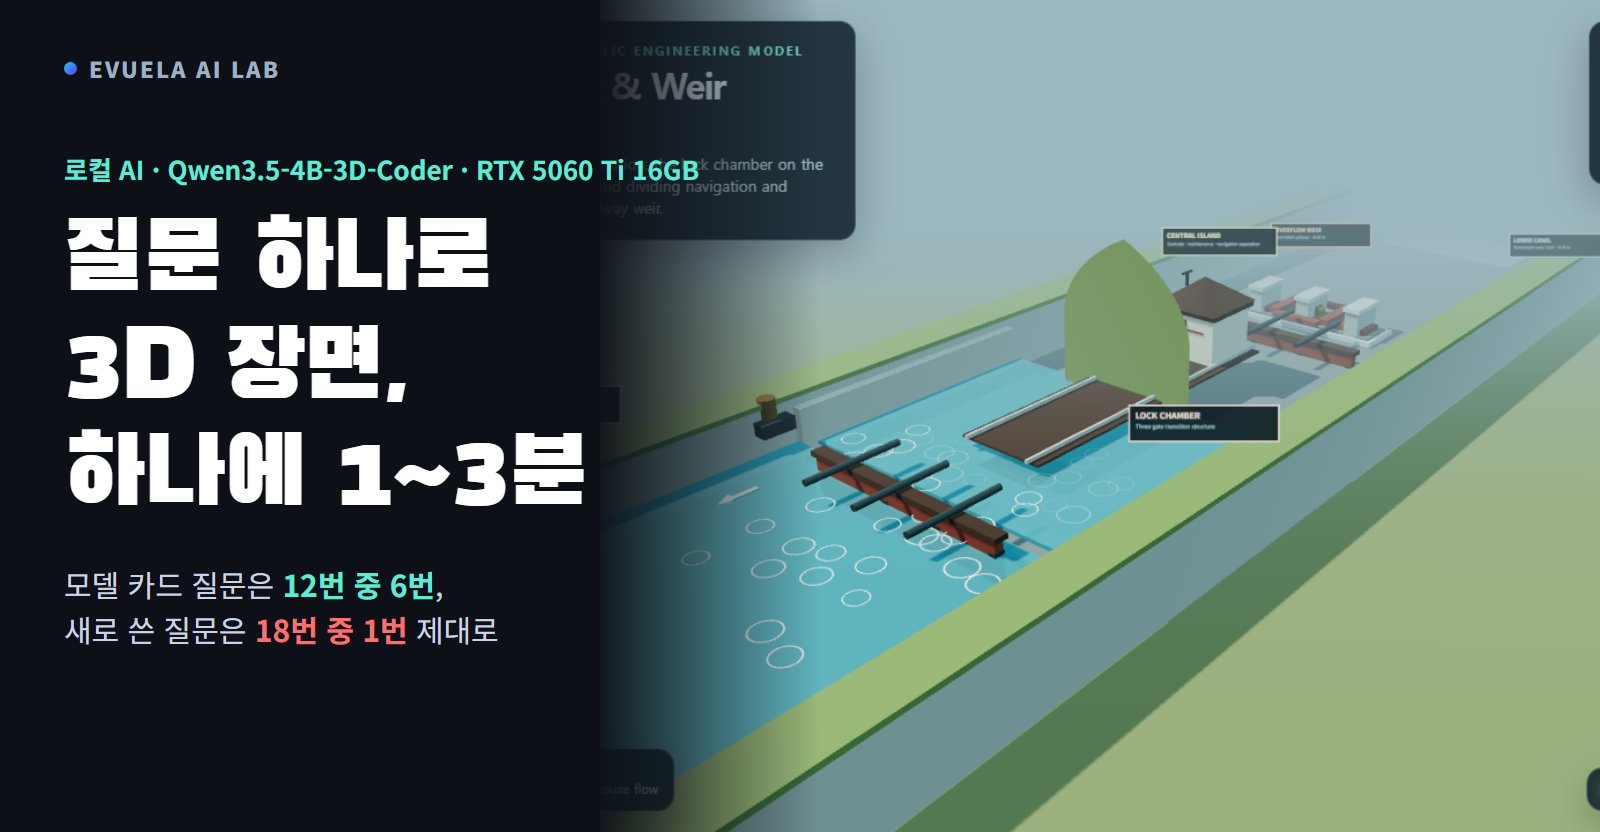
3D 장면용 4B 모델 Qwen3.5-4B-3D-Coder를 RTX 5060 Ti 16GB의 Unsloth Studio에서 돌려 장면 51개를 직접 열어 봤습니다. 제대로 그려진 것은 10개, 장면 하나에 1~3분. 생각을 켜면 6~16분이 걸렸고 결과는 같았습니다.
에이전트용 1.7B 모델 LFM3-1.7B를 Hermes Agent에 붙여 RTX 5090에서 과제 7가지를 시켰습니다. 33번 중 28번 성공, VRAM 5.5GB, 초당 252토큰. 짧은 일은 Qwen3.8 27B보다 빨랐지만 여러 단계 작업은 5번 중 1번만 성공했습니다.
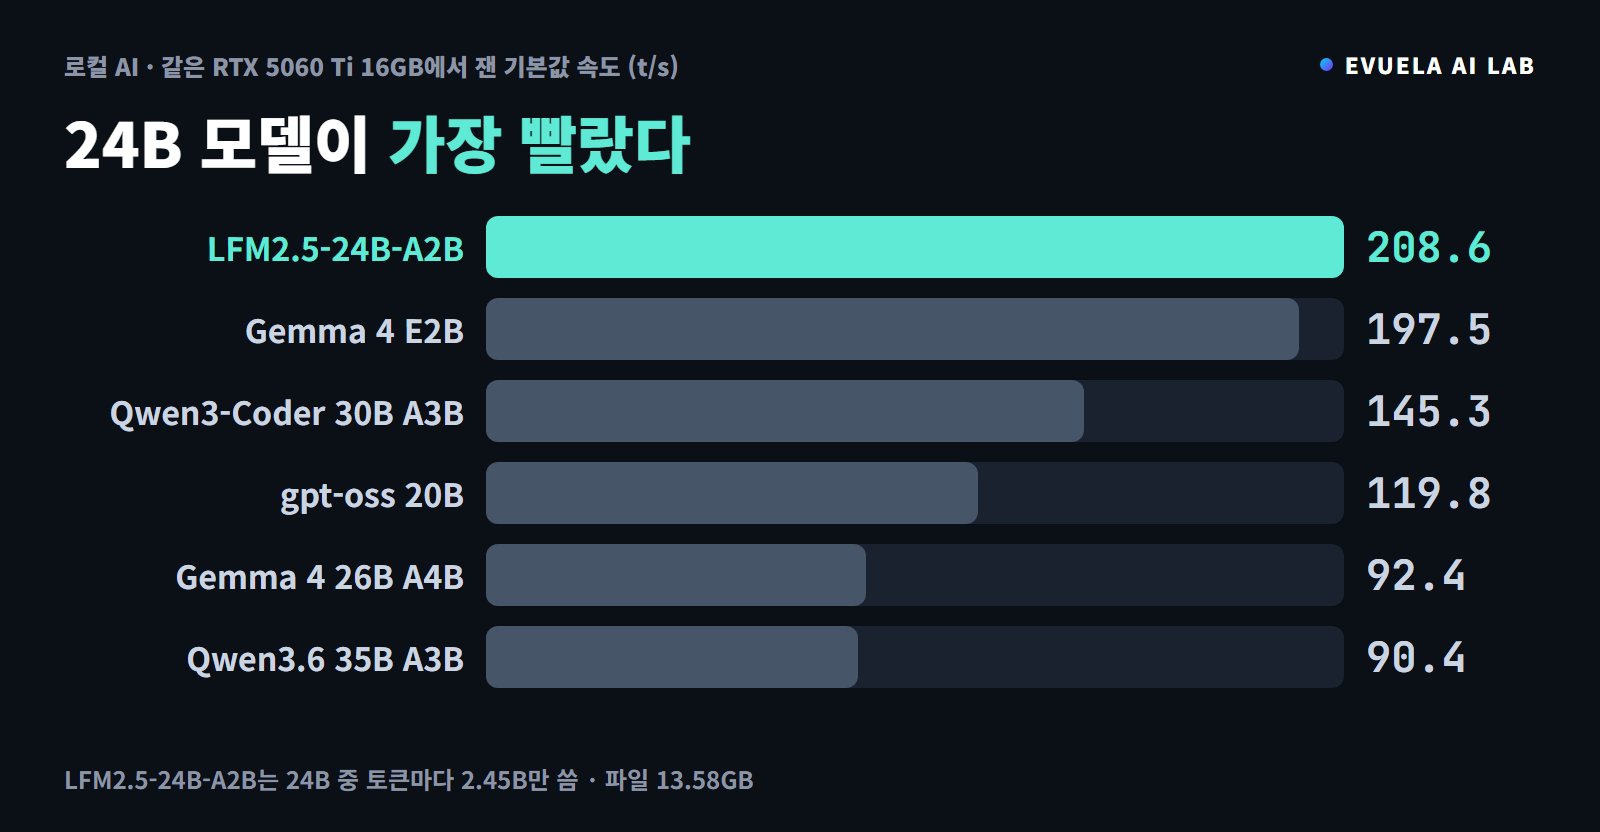
24B 중 토큰마다 2.45B만 쓰는 Liquid AI의 LFM2.5-24B-A2B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 208.6토큰으로 이 PC에서 가장 빨랐고, 100,000자 요약은 20.7초, 생각은 끌 수 없었습니다.
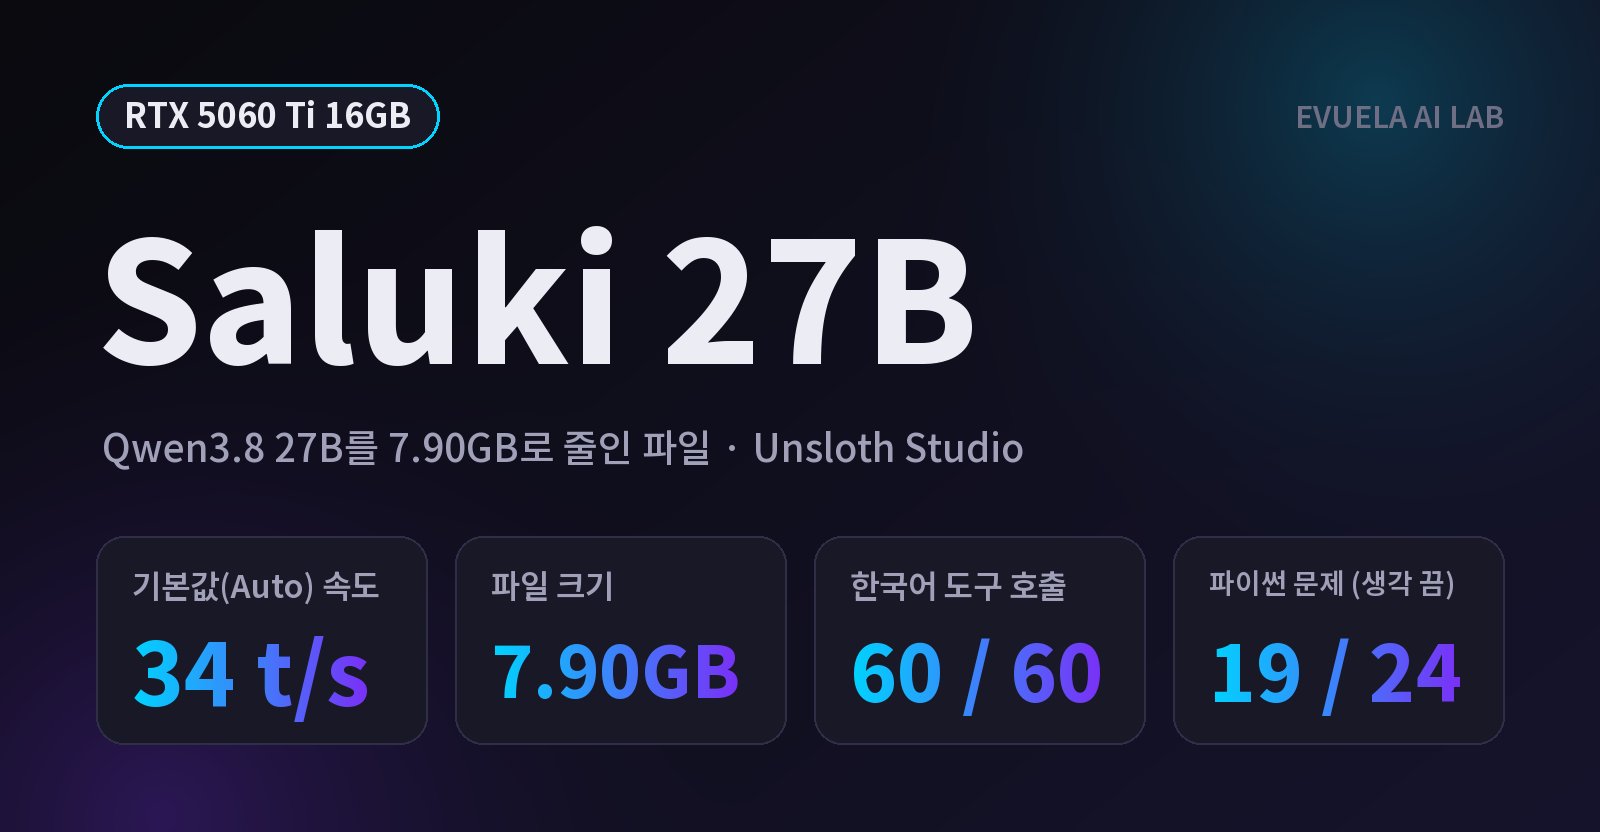
Qwen3.8 27B를 7.90GB로 줄인 Saluki 27B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 34토큰, 한국어 도구 호출 60번 모두 정답이었고, 생각 단계를 정하지 않으면 15번 중 6번은 답이 나오지 않았습니다.
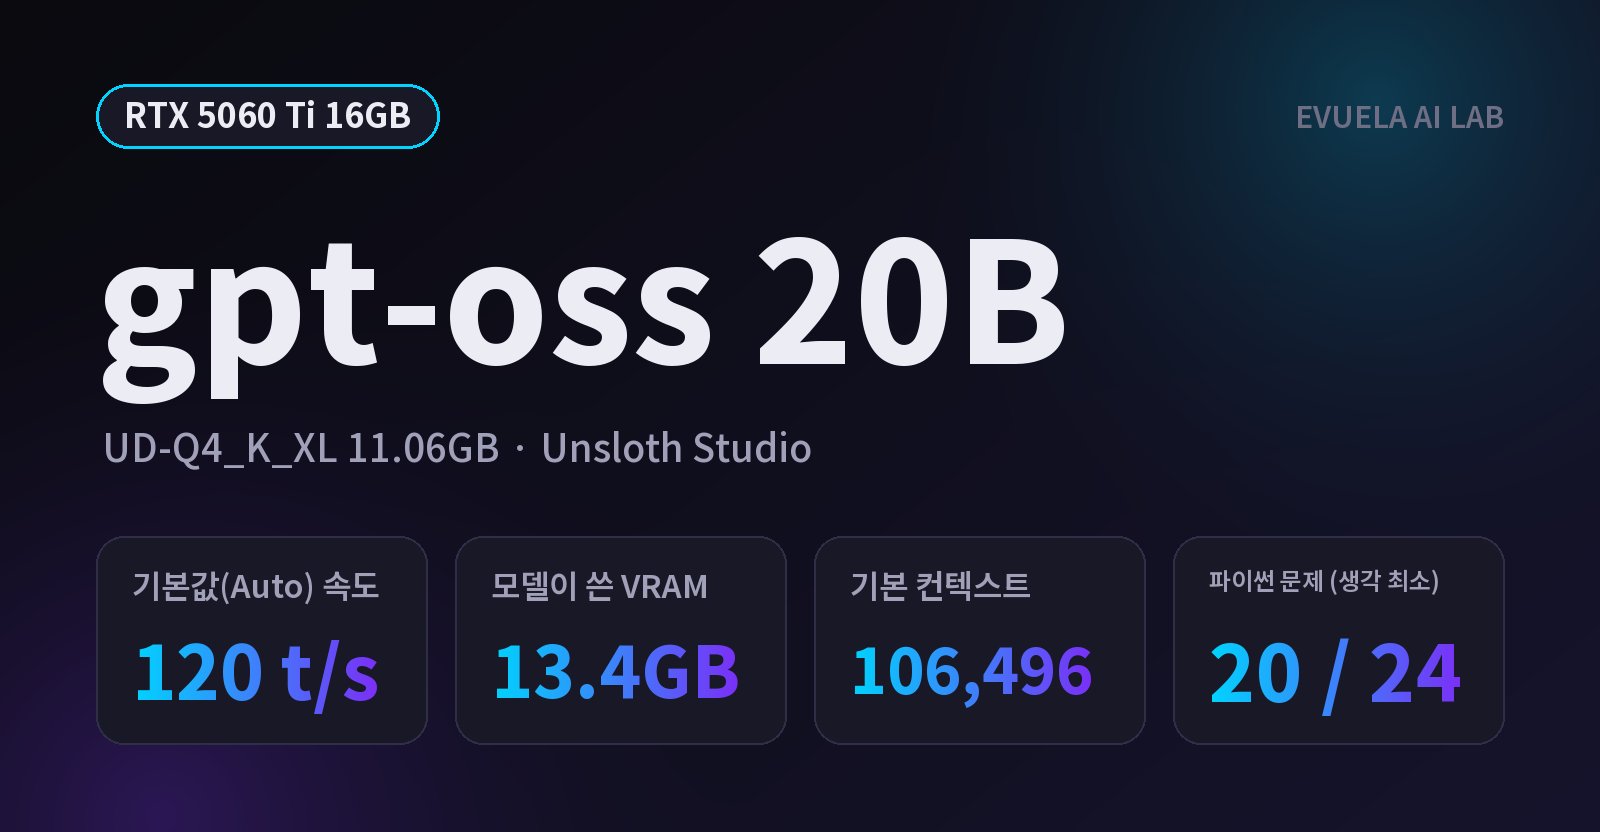
RTX 5060 Ti 16GB의 Unsloth Studio에서 OpenAI의 gpt-oss 20B(UD-Q4_K_XL 11.06GB)를 기본값으로 돌렸습니다. 초당 약 120토큰, 컨텍스트 65,536까지 같은 속도였고, 생각 단계에 따라 시간과 코딩 결과가 크게 달랐습니다.
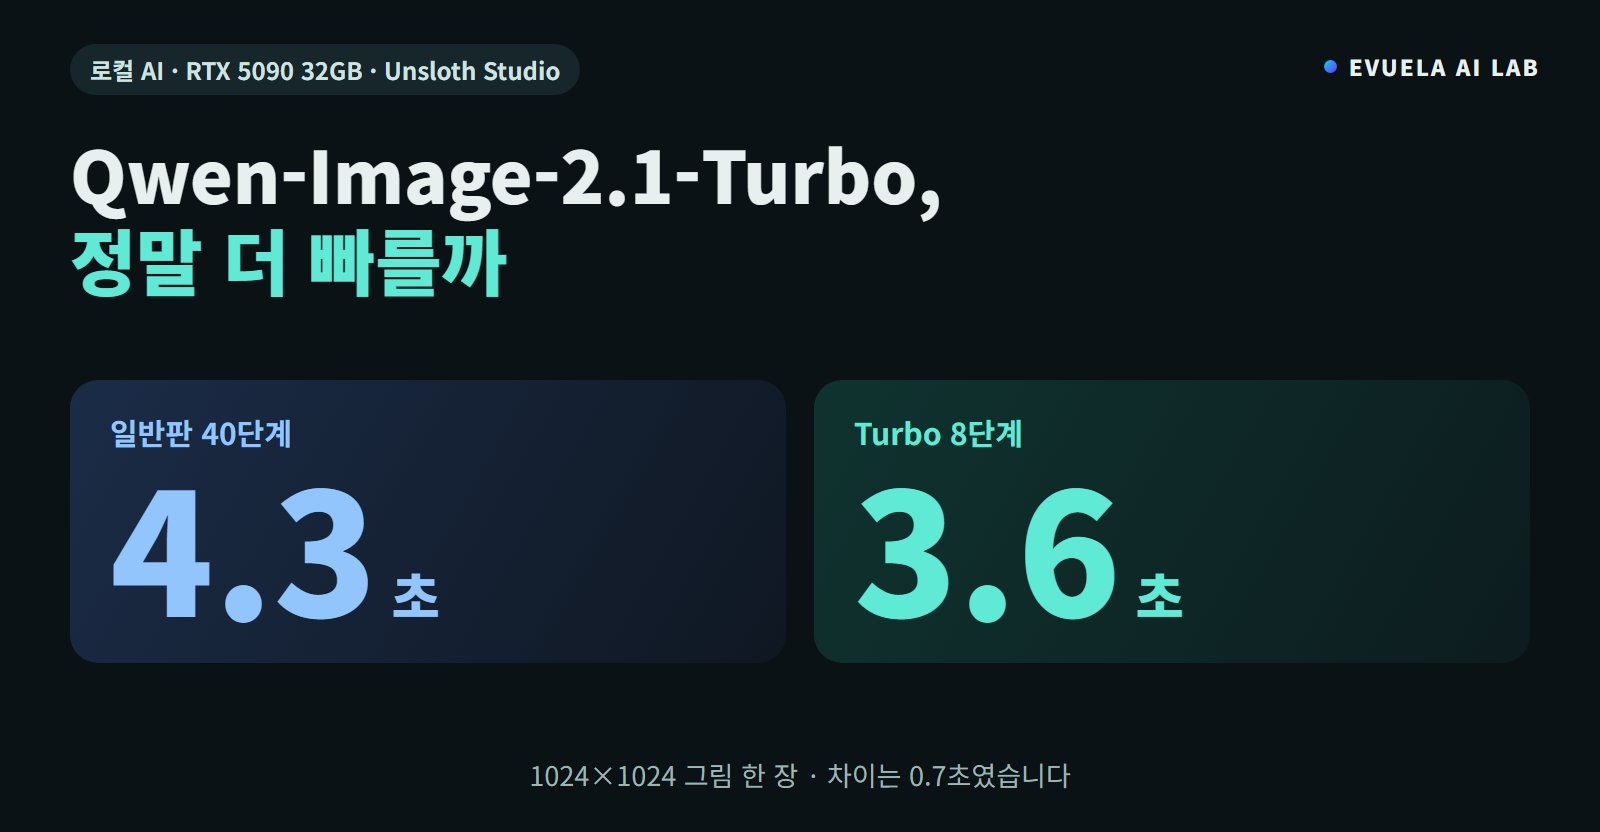
Qwen-Image-2.1-Turbo를 RTX 5090의 Unsloth Studio에서 일반판과 비교했습니다. 1024×1024 한 장에 Turbo 8단계 3.6초, 일반판 40단계 4.3초였고 VRAM은 13.9GB와 21.3GB였습니다. 기본 설정으로 올리면 일반판 가중치로 그려지는 문제와 해결 방법도 적었습니다.
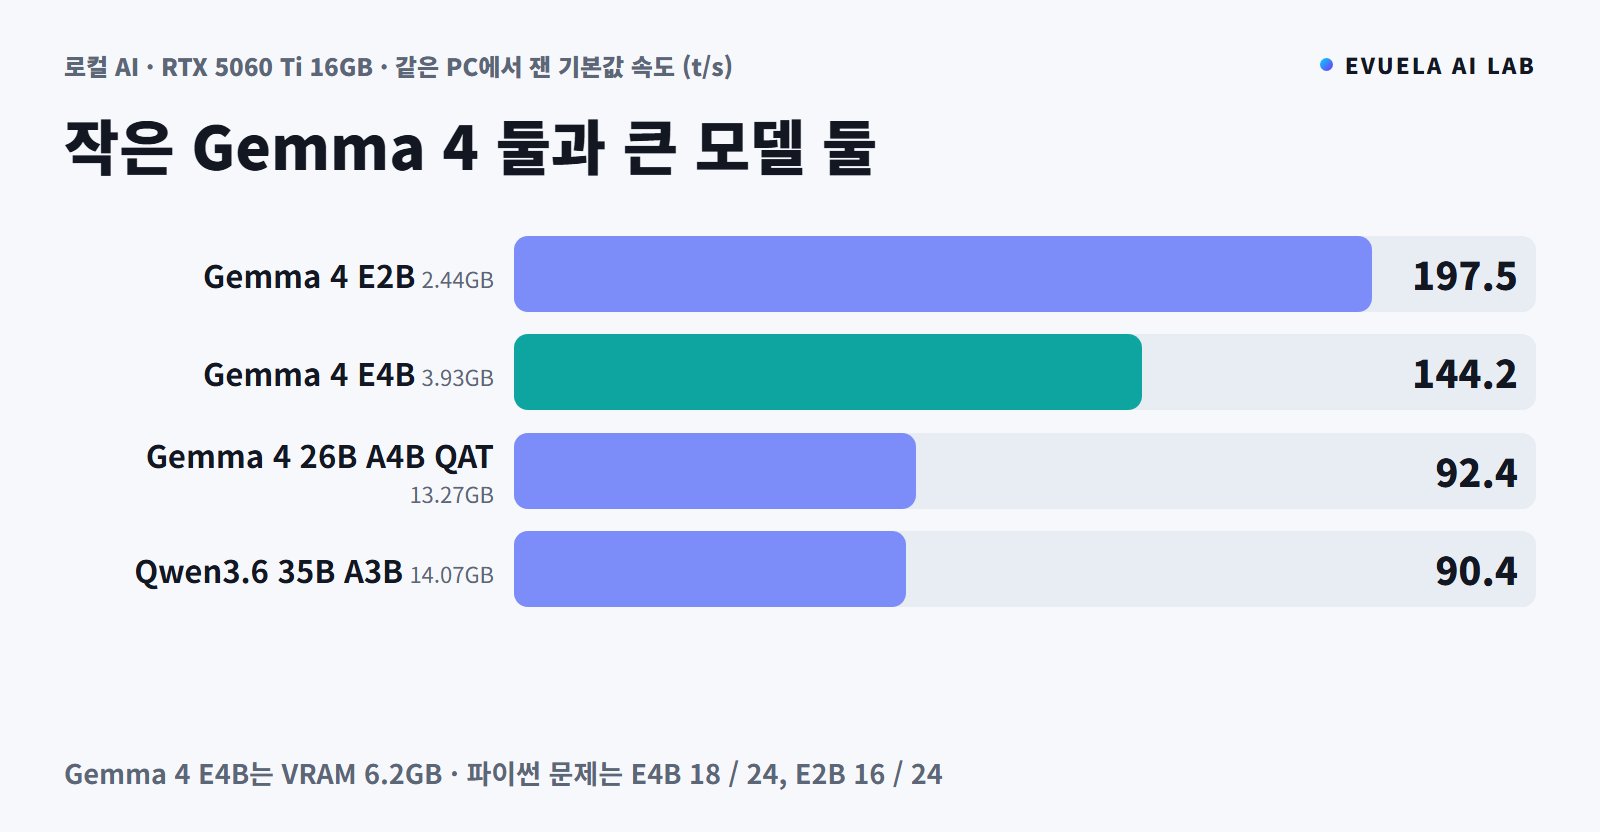
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 E4B(QAT UD-Q4_K_XL 3.93GB)를 기본값으로 돌렸습니다. VRAM 6.2GB에 초당 약 144토큰이었고, 같은 PC에서 잰 E2B와 속도·산수·코딩·사진 결과를 나란히 비교했습니다.
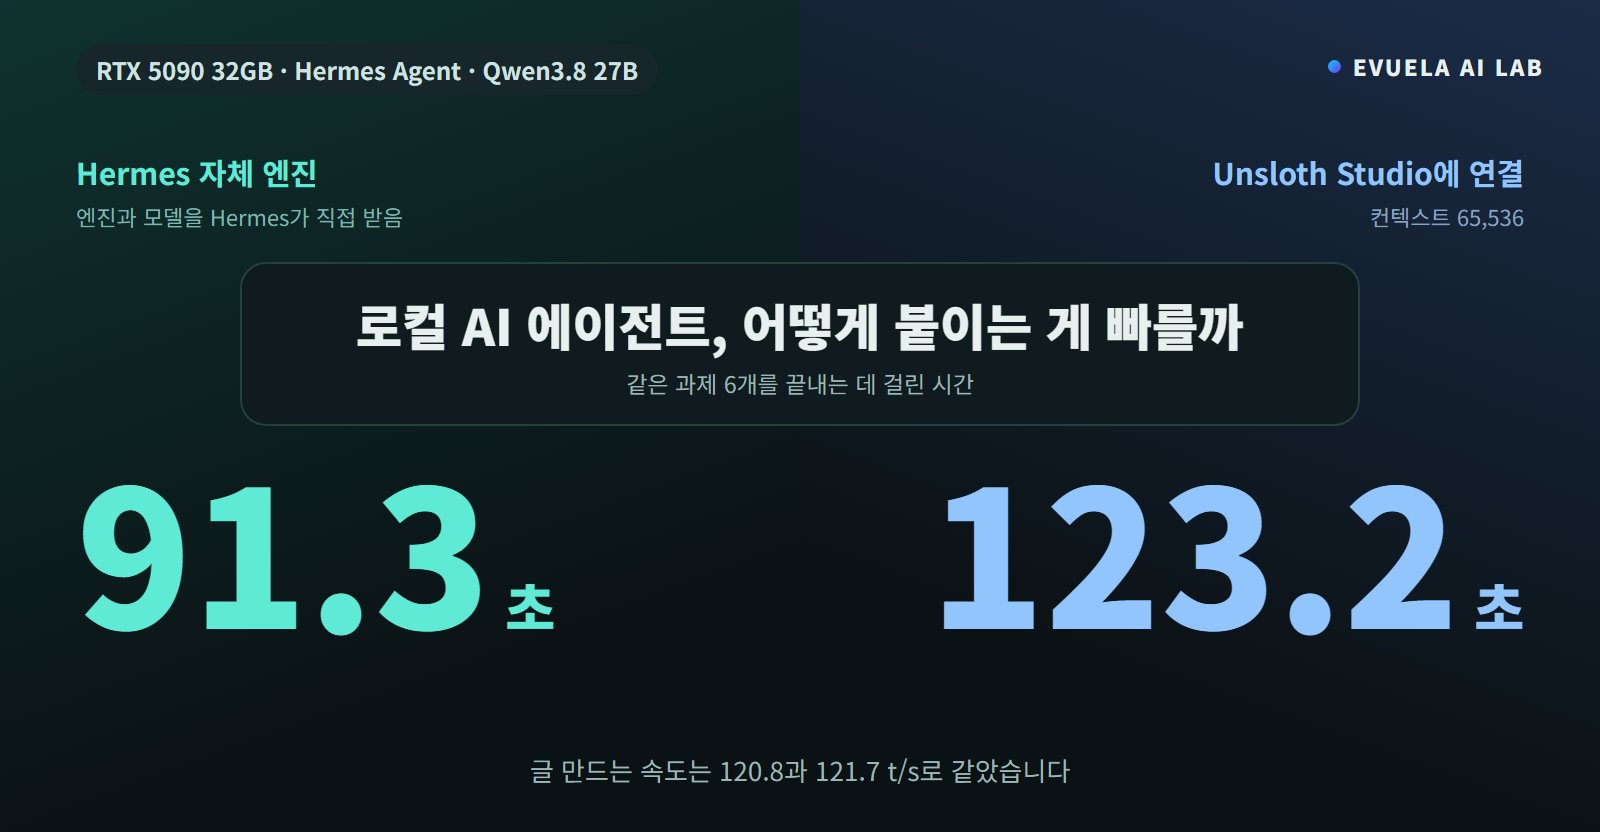
Hermes Agent를 로컬 모델에 붙이는 두 방식을 RTX 5090에서 Qwen3.8 27B로 비교했습니다. 글 만드는 속도는 120.8과 121.7 t/s로 같았지만 과제 6개는 91.3초와 123.2초였습니다. 차이는 프롬프트를 다시 읽는 양에서 났습니다.